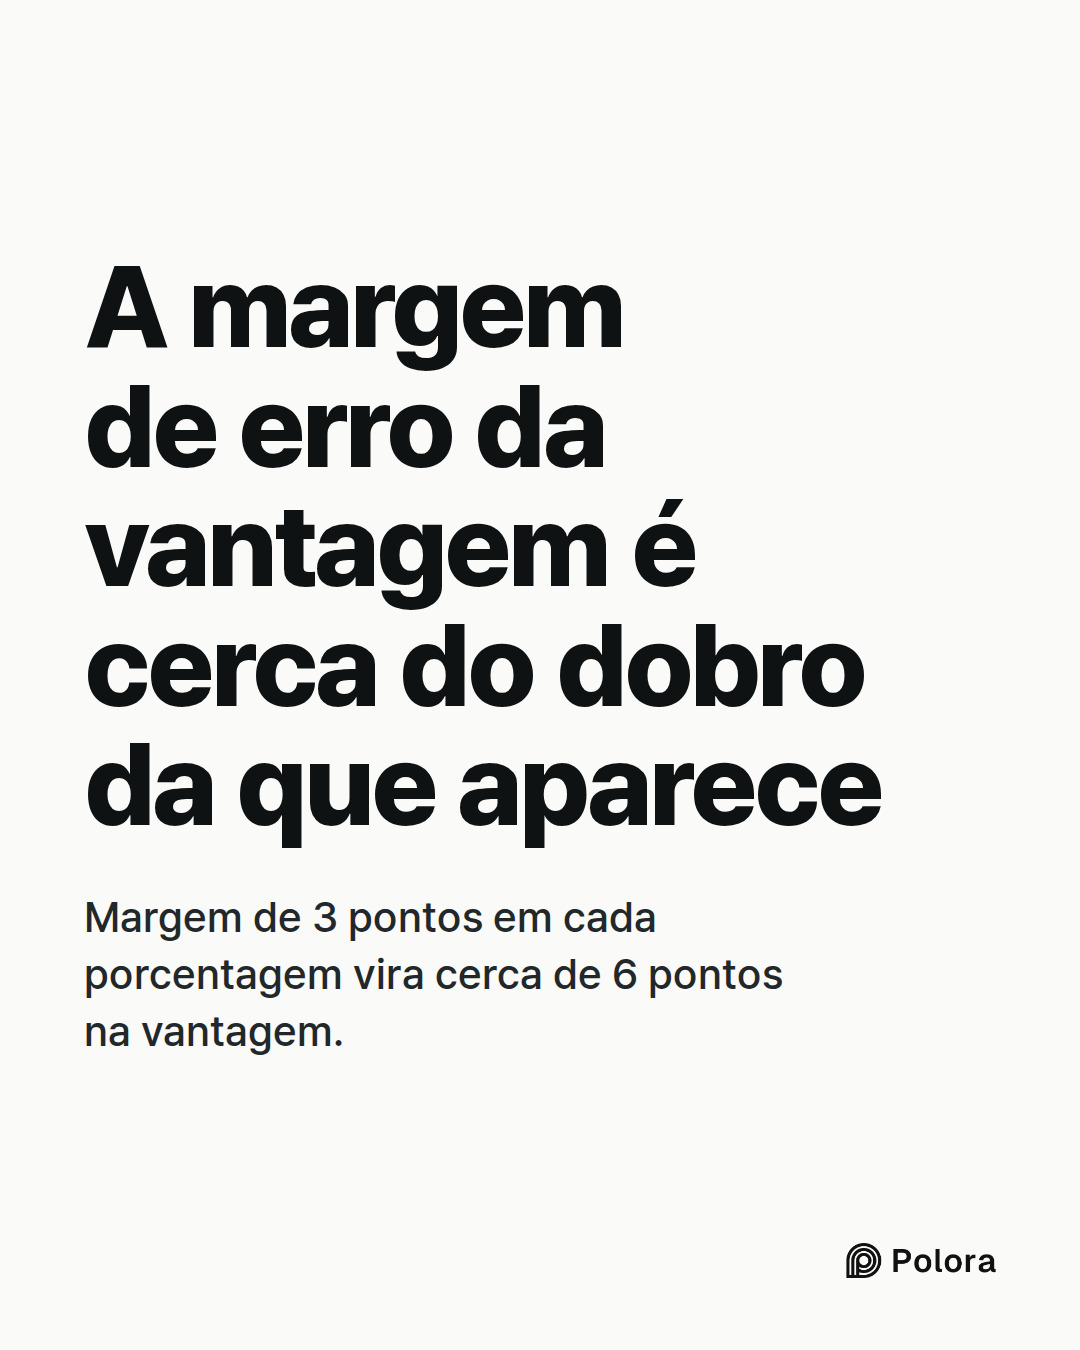
A margem de erro da vantagem é cerca do dobro da que aparece
Uma pesquisa nova mostra um candidato com 48% e o outro com 44%, com margem de erro de 3 pontos para mais ou para menos. A maioria das pessoas lê isso como uma vantagem de 4 pontos, maior que a margem de erro. Não é.
Os 3 pontos para mais ou para menos valem para a porcentagem de cada candidato, vista isoladamente. A vantagem é a diferença entre dois números incertos, e numa disputa entre dois candidatos eles se movem em sentidos opostos. Se a amostra pegou por acaso eleitores demais de um candidato, quase com certeza pegou eleitores de menos do outro. Por isso o erro sobre a diferença é maior que o erro sobre cada porcentagem. O Pew Research Center, instituto de pesquisa americano, diz isso sem rodeios : a margem da diferença costuma ser cerca do dobro da margem de cada candidato. Uma pesquisa com 3 pontos para mais ou para menos em cada porcentagem tem algo como 6 pontos para mais ou para menos na vantagem. É uma regra prática, não uma fórmula exata, e funciona melhor quando os dois candidatos juntos ficam com quase todos os votos.
Aplique isso à vantagem de 4 pontos. A faixa plausível para a diferença real vai de um cenário em que o líder está cerca de 2 pontos atrás até outro em que está cerca de 10 pontos à frente. A vantagem pode ser real, ou o candidato que aparece atrás pode estar, na verdade, na frente. No exemplo do próprio Pew, com uma vantagem de 5 pontos numa pesquisa do mesmo tamanho, a diferença real poderia estar em qualquer ponto entre menos 1 e mais 11. Por essa conta, o líder precisaria estar cerca de 6 pontos à frente para que o acaso da amostragem pudesse ser descartado.
Por que os números de jovens ou de minorias oscilam tanto nas pesquisas
A margem divulgada vale para a amostra inteira. Quando uma reportagem se concentra num pedaço dela, como os eleitores com menos de 30 anos ou uma única região, há muito menos gente por trás do número. O Pew dá o exemplo de um subgrupo com margem de 8 pontos para mais ou para menos em cada candidato, o que vira 16 pontos para mais ou para menos na diferença entre eles.
Alguns grupos também são mais difíceis de alcançar. O Pew observa que jovens e minorias respondem a pesquisas com menos frequência, então os institutos dão peso maior às respostas deles para que correspondam à participação real desses grupos na população. Esse passo, chamado ponderação, torna a amostra mais representativa, mas também aumenta a margem de erro. Uma virada dramática dentro de um subgrupo entre duas pesquisas muitas vezes é só ruído.
O que a margem de erro não cobre
A margem de erro mede uma coisa só : a chance de que uma amostra aleatória de cerca de mil pessoas saia um pouco diferente da população inteira, do mesmo jeito que as cartas que cada jogador recebe mudam a cada distribuição. Ela não diz nada sobre as outras formas como uma pesquisa pode errar.
O Pew lista três delas. Algumas pessoas simplesmente não são alcançadas pelo método usado, o que se chama erro de cobertura. Alguns grupos se dispõem menos a responder, o que é a não resposta. Algumas pessoas entendem mal a pergunta ou não dizem o que realmente pensam, o que é o erro de medição. As pesquisas eleitorais acrescentam mais uma aposta : decidir quais entrevistados vão de fato votar. Os institutos montam os chamados modelos de eleitor provável para tomar essa decisão, e o comparecimento é difícil de prever.
Quando pesquisadores comparam as pesquisas com os resultados reais, a distância é maior do que a margem declarada sugere. Um estudo com mais de 4.000 pesquisas estaduais de 1998 a 2014, feito por estatísticos de Stanford, da Microsoft Research e de Columbia, encontrou um erro típico de cerca de 3,5 pontos na porcentagem de um candidato. Esse número é a raiz do erro quadrático médio, um jeito de calcular a média que dá peso extra aos erros maiores, e corresponde a cerca do dobro do que as margens divulgadas indicavam. O Pew e a Associação Americana de Pesquisa de Opinião Pública (AAPOR), principal entidade profissional do setor, hoje usam a mesma regra prática : o potencial real de erro é cerca do dobro do número divulgado. Essa duplicação é diferente da que vale para a vantagem, e não se deve multiplicar uma pela outra para chegar a uma margem única da vantagem. A margem divulgada não mostra nenhuma das duas.
Por que a média das pesquisas é melhor que uma pesquisa isolada, até certo ponto
Duas boas pesquisas feitas na mesma semana vão sair com um ou dois pontos de diferença, porque ouviram pessoas diferentes. Fazer a média de muitas pesquisas anula boa parte desse ruído aleatório e também equilibra as particularidades de cada instituto. A orientação da AAPOR diz que as médias tiram o foco dos resultados individuais, que carregam muito ruído da variação normal, e dão uma visão mais clara das tendências.
A média tem limite. O mesmo estudo que mostrou que o erro real das pesquisas era cerca do dobro da margem declarada também concluiu que pesquisas sobre a mesma disputa tendem a errar na mesma direção, em cerca de 1,5 a 2 pontos, em média. Os autores sugerem um motivo : os institutos têm dificuldade de alcançar os mesmos grupos e usam regras parecidas para decidir quem vai votar. Uma média não consegue anular um erro que todas as pesquisas compartilham. Então uma vantagem que se mantém em muitas pesquisas é bem mais confiável do que a de um único levantamento, mas a média também não é garantia.
Quanto erraram as pesquisas americanas em 2016, 2020, 2022 e 2024?
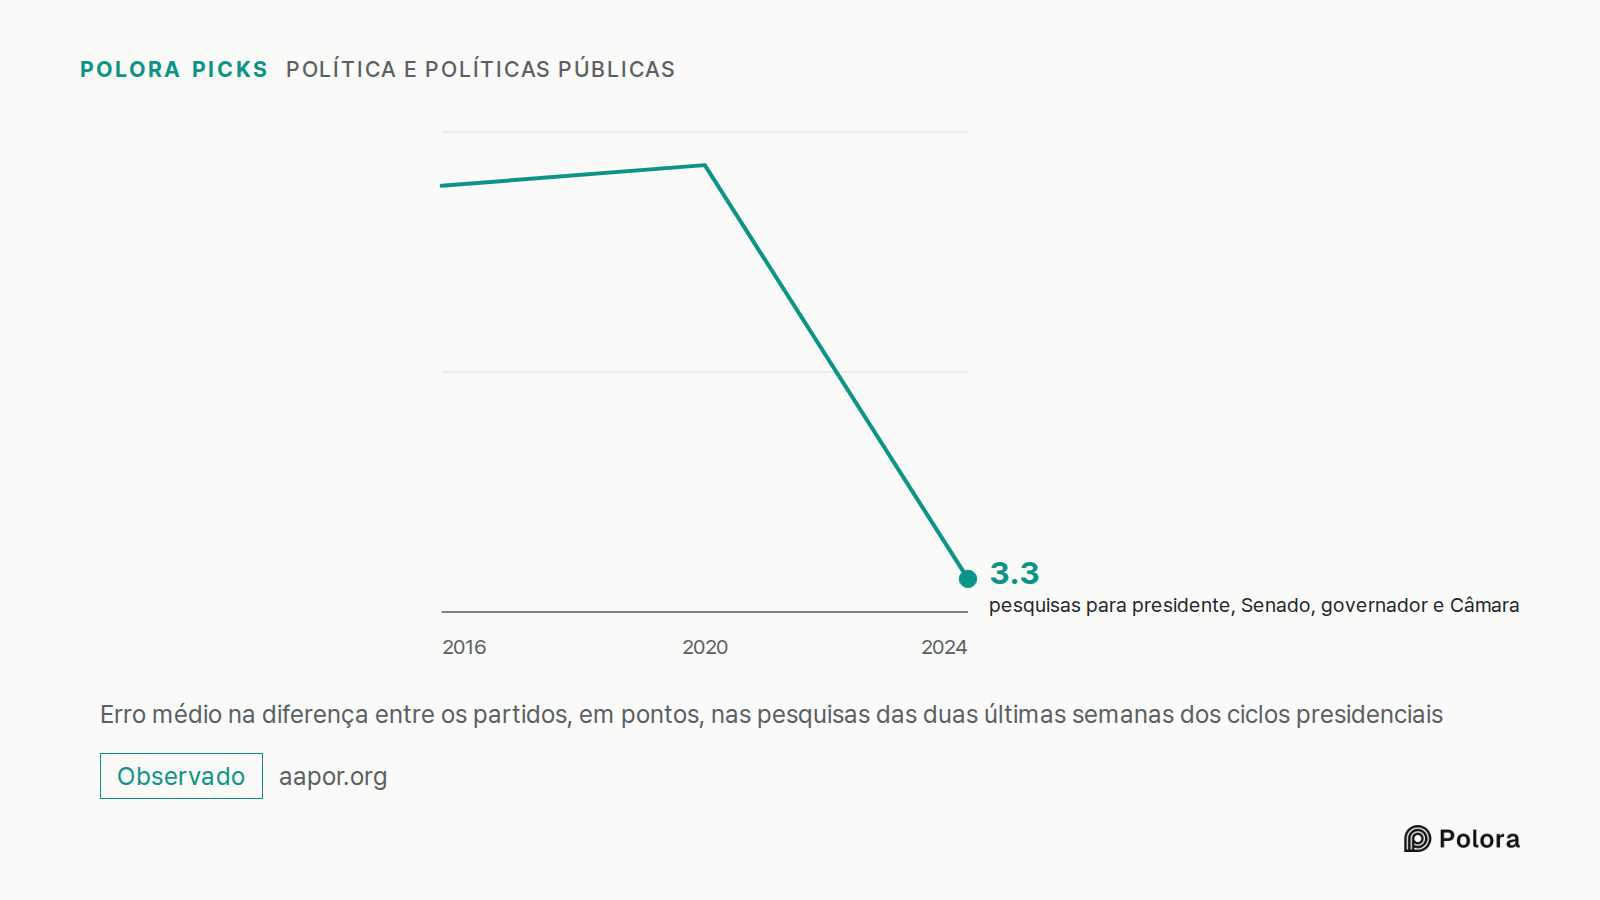
A AAPOR analisa cada ciclo presidencial. Seu relatório de 2024 examinou 611 pesquisas para presidente, Senado, governador e Câmara feitas nas duas últimas semanas de campanha. Em média, elas erraram a diferença final entre os dois partidos em 3,3 pontos. Foi uma melhora em relação aos 5,3 pontos de 2020 e aos 5,2 de 2016. As pesquisas presidenciais nacionais erraram em média 2,6 pontos, e as presidenciais estaduais, 3,0. Segundo o relatório, as pesquisas estaduais foram mais precisas do que em qualquer ciclo presidencial desde 1944.
Esses números medem o erro sobre a própria diferença, o mesmo número que aparece como vantagem nas manchetes. Ou seja, mesmo num ano bom, a pesquisa final típica errou a diferença em mais ou menos o tamanho das vantagens que viram notícia. E essas são pesquisas das duas últimas semanas. Uma pesquisa feita um mês ou mais antes da eleição não está coberta por esses parâmetros, e a preferência dos eleitores tem mais tempo para mudar depois dela.
A direção do erro também importa. Em 2016, 2020 e 2024, as pesquisas subestimaram os republicanos, em 2,7 pontos na diferença em 2024, contra 4,6 em 2020. Nas eleições de meio de mandato de 2022, o pequeno erro médio foi no sentido contrário e superestimou os republicanos em 0,6 ponto. A AAPOR observa que, desde os anos 1930, cada partido foi subestimado mais ou menos com a mesma frequência, e as pesquisas raramente erram na mesma direção por mais de duas eleições presidenciais seguidas. O erro do último ciclo não é um guia confiável para o próximo.
Por que as pesquisas não reduzem a margem de erro para 1 ponto
O Brasil vai às urnas em 4 de outubro, e os eleitores brasileiros estão fazendo a mesma pergunta. A BBC News Brasil, em reportagem republicada pelo jornal O Povo, expôs a conta que limita toda pesquisa. Para ter margem de 3 pontos para mais ou para menos, é preciso entrevistar cerca de 1.068 pessoas. Para 2 pontos, cerca de 2.401. Para 1 ponto, cerca de 9.604, o que é caro demais para a maioria das pesquisas. Reduzir a margem pela metade exige cerca de quatro vezes mais entrevistas.
É por isso que as pesquisas se contentam com margens de alguns pontos, e não de um. Segundo a mesma reportagem, a maioria das pesquisas eleitorais brasileiras divulga algo em torno de 2 pontos para mais ou para menos. É também por isso que uma vantagem de poucos pontos tantas vezes fica dentro do ruído. Raphael Nishimura, estatístico especializado em pesquisas por amostragem da Universidade de Michigan, ouvido pela BBC, descreve a pesquisa como uma fotografia do momento, não uma previsão. Uma série de pesquisas ao longo do tempo se aproxima mais de um filme.
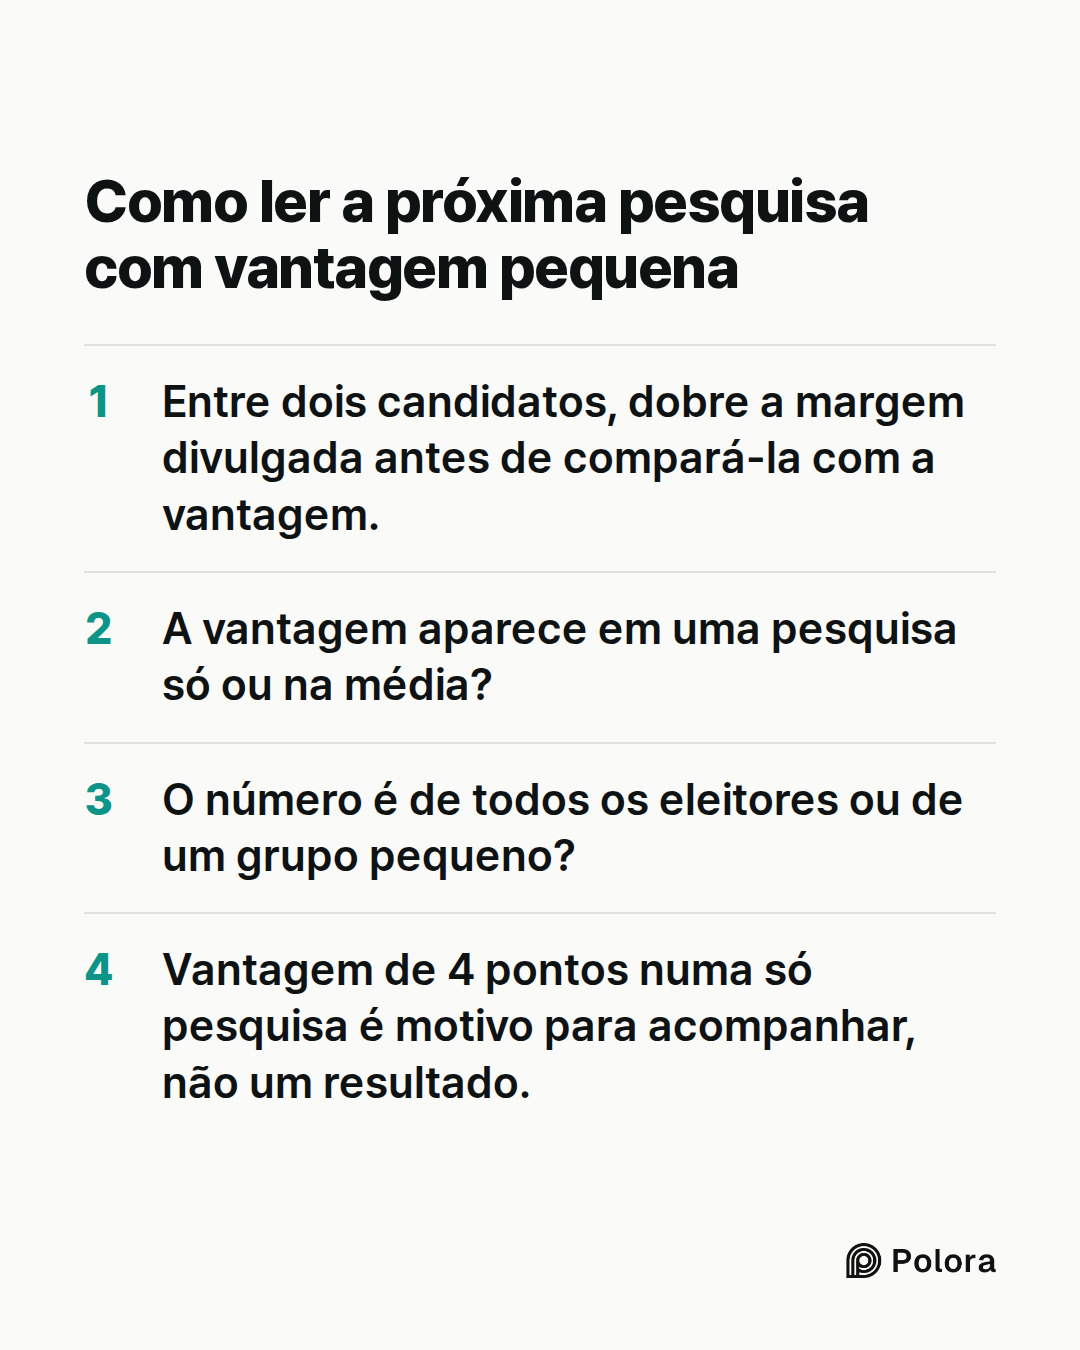
Como ler a próxima pesquisa com vantagem pequena
Numa disputa entre dois candidatos, dobre a margem divulgada antes de compará-la com a vantagem. Se a vantagem for menor que esse valor, a pesquisa mostrou quem estava à frente entre as pessoas que ela ouviu, mas não quem está à frente entre todos os eleitores. Mostrou que a disputa está apertada. Uma vantagem maior que isso ainda não é uma previsão, porque os erros que a margem deixa de fora continuam lá e a opinião pode mudar até o dia da eleição.
Depois, olhe além do número isolado. A vantagem aparece em uma pesquisa só ou na média? O número é de todos os eleitores ou de um grupo pequeno? Lembre-se de que, mesmo em 2024, um ano bom, as pesquisas finais erraram a diferença em cerca de 3 pontos, em média. Nada disso torna as pesquisas inúteis. Somando muitos levantamentos, elas costumam ficar a poucos pontos do resultado. Poucos pontos é simplesmente a cara de uma disputa apertada, e uma vantagem de 4 pontos em uma única pesquisa é motivo para continuar acompanhando, não um resultado.