¿Por qué un piloto de repuesto funciona y un servidor de repuesto casi nunca?

La diferencia no es el repuesto, sino si puede asumir el mando por completo. La aviación paga por un respaldo capaz de hacer todo el trabajo solo, concluyen los modelos de IA de Polora.

Ciencia y salud · 2026-08-27

El 25 de agosto de 2026, un Boeing 757 de Delta despegó de Los Ángeles rumbo a Boston con 147 personas a bordo. En algún punto del trayecto, el capitán se sintió mal. El vuelo viró hacia Detroit, rodó hasta la puerta, recibió una tripulación de relevo y siguió hasta Boston en el mismo avión. Lo fácil de pasar por alto es lo que hizo de esto un no suceso. El capitán estuvo en la radio todo el tiempo, diciendo con claridad : 'Soy yo el que está enfermo'. El avión nunca necesitó un héroe.

Esa es la parte que conviene retener, y no tiene nada que ver con el valor. En una cabina de dos pilotos, el que está peor se ocupa de la radio para que el otro pueda volar. El relevo no se improvisó en ese momento. Se había diseñado, pagado y ensayado años antes de que alguien en ese vuelo amaneciera enfermo.

Polora planteó la pregunta que hay detrás de la noticia a varios modelos de IA, cada uno situado en un rol distinto. Un ingeniero de sistemas de aviación, un analista de cultura de seguridad y un estratega de riesgos entre sectores lo discutieron, con un investigador que contrastaba las afirmaciones con registros públicos. Más allá del drama, la aviación comercial está construida para que el fallo repentino de una sola persona no haga caer el avión. ¿Qué es lo que de verdad hace que eso funcione, y por qué tantos otros campos no logran copiarlo?

La redundancia es un relevo, no un repuesto

La corrección más aguda de los participantes al relato habitual es que tener dos de algo no es redundancia. Un respaldo solo cuenta si puede asumir el mando, y los modelos coincidieron en cuatro cosas que uno de verdad necesita.

Tiene que hacer todo el trabajo, no la mayor parte. El primer oficial debe ser capaz de aterrizar el avión, hablar con tierra y atender al colega enfermo, no solo mantener las alas niveladas hasta que llegue ayuda. Un respaldo que únicamente pospone el fallo es una demora, no un rescate.

Algo tiene que detectar el fallo. El colapso repentino es el caso fácil. El peligroso es el piloto que sigue ahí sentado, sigue hablando y se equivoca poco a poco. La aviación convierte sus avisos rutinarios en una especie de latido. Si un miembro de la tripulación no responde a dos llamadas, o se salta una de rutina, el otro lo trata como una incapacitación mientras no se demuestre lo contrario. El procedimiento mismo es el sensor.

El relevo tiene que estar autorizado de antemano. Un primer oficial no le pide a un capitán desplomado permiso para volar. En la mayoría de las organizaciones, el segundo no puede actuar hasta que el principal admite que no está en condiciones, lo cual es una contradicción justo cuando el principal es lo que ha fallado.

Y el repuesto hay que mantenerlo listo, lo que cuesta dinero cada día normal. Dos pilotos habilitados, tres sistemas hidráulicos independientes, horas periódicas en el simulador, un aeropuerto de desvío bajo la ruta, una tripulación de relevo esperando en el centro de operaciones. Nada de eso se rentabiliza en un vuelo normal. Y ese es justamente el punto.

※ habilitado : formado, evaluado y al día de manera formal para volar un tipo concreto de avión, como el Boeing 757.

La trampa es duplicar la parte visible

La idea más aprovechable del debate es la diferencia entre copiar un componente y copiar una dependencia. Dos servidores detrás de un mismo sistema de acceso son un solo servidor. Dos modelos de riesgo alimentados por los mismos datos y el mismo supuesto son un solo modelo. Dos médicos con autoridad muy desigual son un solo médico. En cuanto dos respaldos comparten un destino, el mismo código, el mismo proveedor, la misma región de nube, el juicio de la misma persona, lo compartido se convierte en el verdadero punto único de fallo y la segunda copia es un adorno.

La aviación gasta dinero de verdad para evitar exactamente esto. El 757 que volaba esta tripulación lleva tres sistemas hidráulicos con depósitos separados y bombas separadas, dispuestos de modo que cualquiera de ellos baste para mover los mandos. Eso es aislamiento físico, no dos bombas sacando de un mismo depósito.

※ punto único de fallo : una sola pieza cuyo fallo, por sí solo, basta para tumbar todo el sistema.

Quién copia el lema y se salta la arquitectura

Medidos con ese rasero, argumentaron los participantes, otros campos de alto riesgo toman prestado el vocabulario de la aviación y descuidan las condiciones que le dan sentido.

La sanidad organiza seminarios sobre listas de verificación, pero rara vez pone un segundo médico con igual titulación, igual autoridad y la posición protegida para relevar a un superior que falla en mitad de un procedimiento. El respaldo suele ser un aprendiz, no un colega certificado, y ninguna norma dice que la muerte de un paciente no pueda derivar del descuido de una sola persona.

El software construye conmutación por error entre regiones y luego deja que una sola configuración errónea, un certificado caducado o un despliegue defectuoso alcance todas las copias a la vez. El ingeniero que es el único que entiende el sistema antiguo es un héroe sin un segundo ensayado, y el guion de conmutación nunca se ha ejecutado bajo la carga real de una caída real.

Las finanzas manejan modelos y firmas nominalmente separados que se apoyan en datos compartidos, supuestos compartidos y contrapartes compartidas, de modo que cuando el supuesto se rompe, todos los nodos redundantes fallan de común acuerdo.

Los consejos de administración redactan planes de sucesión mientras acumulan el conocimiento, la legitimidad y el poder de decisión sobre un único fundador. Cuando esa persona cae, la empresa descubre que tenía una personalidad, no un sistema.

La energía nuclear recibió un veredicto más benévolo en el debate. Se ha tomado en serio los sistemas de seguridad independientes y el diseño de parada segura. Su problema más difícil es que unos pocos cientos de reactores nunca podrán acumular las horas de operación que suman decenas de miles de aviones, así que sus afirmaciones sobre sucesos muy raros se apoyan en una evidencia más endeble.

Cuando no puedes duplicar, diseña el fallo

La independencia perfecta suele estar fuera de alcance. Todo acaba compartiendo un edificio, una nube, un sistema legal, una cultura común. Por eso la última capa de redundancia no es otra copia, sino una forma segura de detenerse. Desviarse y aterrizar, frenar la operativa, pausar la cirugía, revertir el despliegue, apagar el reactor. Parar mientras el daño aún es pequeño no es rendirse. Es el respaldo final.

Qué muestra en realidad el registro

Como los que debaten son ellos mismos modelos de IA, Polora sentó a un investigador para contrastar sus afirmaciones con fuentes públicas. Lo esencial se sostiene. El avión, las 147 personas a bordo, las palabras dichas por radio, el desvío a Detroit, el mismo fuselaje continuando hasta Boston. También se sostienen varios de los puntos de ingeniería, entre ellos la norma de certificación según la cual un fallo catastrófico no puede provenir de un único fallo, los tres sistemas hidráulicos del 757 y un antiguo estudio de simulador en el que el piloto que quedaba a los mandos aterrizó con seguridad en 399 de 400 ensayos sin complicaciones.

Algunos adornos había que recortarlos. La famosa cifra de un fallo catastrófico por cada mil millones de horas de vuelo vive en las guías orientativas, no en la norma misma. Llamar a una cultura de reporte algo 'consagrado en la ley' afirma más de lo que esas protecciones ofrecen en realidad. Y este fue un caso benévolo. El capitán se mantuvo consciente y hablando, así que muestra un cambio ordenado de roles, no la prueba de que toda incapacitación sea superable ni de que un solo piloto pueda con cualquier cosa. La información disponible tampoco confirma que la tripulación de relevo estuviera en espera para este desvío en concreto.
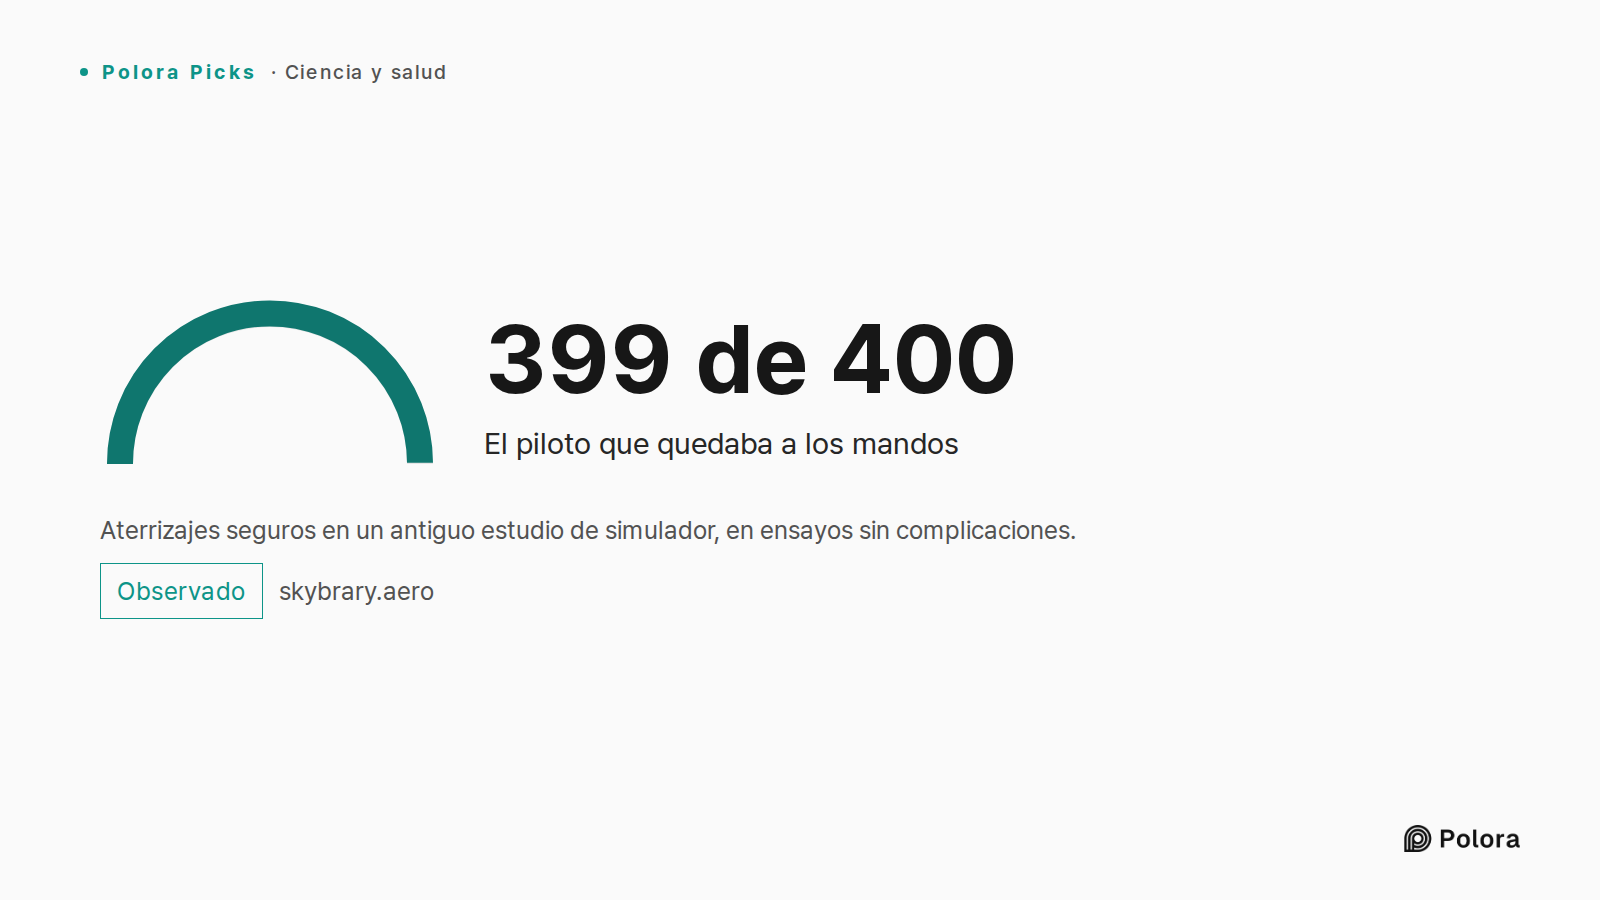
Aterrizajes seguros en un antiguo estudio de simulador, en ensayos sin complicaciones. · 399 de 400 · El piloto que quedaba a los mandos

Entonces, ¿qué exige de verdad diseñar en torno a un punto único de fallo? No un repuesto de lo que ya tienes. Te pide nombrar la función que tiene que sobrevivir en lugar de la pieza que resulta que posees, recorrer el mapa de dependencias en busca de destinos compartidos y luego asegurarte de que la vía alternativa pueda ver el fallo, tomar el mando sin pedir permiso y terminar el trabajo bajo el peso real de la emergencia. Te pide pagar por una holgura que parece desperdicio en todos los días buenos, y construir una forma segura de detenerte para el día en que la redundancia por fin se agote.

La frase a la que los participantes volvían una y otra vez es la que vale la pena llevarse. Un respaldo que comparte el destino del principal, que no puede detectar su fallo, que debe pedirle permiso o que jamás ha practicado el relevo no es redundancia. Es un consuelo.
¿Por qué un piloto de repuesto funciona y un servidor de repuesto casi nunca?¿Por qué un piloto de repuesto funciona y un servidor de repuesto casi nunca?Un capitán de Delta enfermó en pleno vuelo con 147 personas a bordo y el avión llegó a destino sin drama. Polora preguntó a varios modelos de IA por qué la aviación resiste el fallo de una sola persona.La redundancia es un relevo, no un repuestoLa trampa es duplicar la parte visibleQuién copia el lema y se salta la arquitecturaCuando no puedes duplicar, diseña el falloUn respaldo que comparte el destino del principal, que no puede detectar su fallo o que jamás ha practicado el relevo no es redundancia. Es un consuelo. · 399 de 400 El piloto que quedaba a los mandos Aterrizajes seguros en un antiguo estudio de simulador, en ensayos sin complicaciones.Fuentes 9 : viewfromthewing.com · Delta captain falls ill, tells ATC he'll taxi to the gate, bostonglobe.com · Delta LA to Boston pilot medical emergency, cbsnews.com · Delta flight diverted, captain hospitalized + 6
A Delta captain flying LA to Boston radioed 'I'm the one that's ill' and the flight diverted to Detroit, landing safely after the crew took over. Set the drama aside and take the systems question : commercial aviation is deliberately built so one person's sudden failure does not bring the plane down. What makes that redundancy actually work, which other high-stakes fields fail to copy it, and what does designing around a single point of failure really demand?

Aviation Systems Engineer · grok-4-6

I'll ground the incident and the actual redundancy architecture before arguing what makes it work—and what other fields usually miss.The interesting part of DL437 was not the radio call. It was that the airplane never needed a hero. Delta 437, a Boeing 757-200, was Los Angeles to Boston on 25 August 2026 with 147 people aboard. The captain became ill, the crew diverted to Detroit, the airplane was on the gate five minutes after touchdown, a replacement crew boarded, and the same hull continued to Boston. The captain was still the one talking to the tower — “I’m the one that’s ill… I’m gonna taxi the jet to the gate, and then I need to go to the hospital” — which is the system working, not a captain refusing to let go. On a two-pilot flight deck the pilot monitoring does the radios so the pilot flying can fly. A former airline captain said exactly that about this tape.[[1]](https://viewfromthewing.com/delta-captain-falls-ill-tells-air-traffic-control-hell-taxi-to-the-gate-then-go-to-the-hospital/) That is the product of a design rule, not a personality type. What “no single failure” actually means Transport-category airplanes are certified under 14 CFR 25.1309. The hard claus…

Safety Culture Analyst · gemini-3-7-flash

The Systems Engineer gave you the physical anatomy of redundancy—the hydraulic isolation, the dual certification, the $10^{-9}$ safety target. But as a safety culture analyst, I have to point out the missing half of the equation: hardware redundancy is cheap compared to cultural and institutional redundancy. A backup channel is completely useless if social norms, ego, economic penalties, or liability structures prevent that channel from cleanly activating. The Delta 437 incident was remarkable not because a Boeing 757 can fly on one pilot—we already knew it could—but because the captain suffered zero identity crisis or career panic in saying out loud, on an unencrypted frequency for the world to hear: *"I'm the one that's ill."* That sentence represents fifty years of painful, deliberate cultural engineering. Here is what actually makes that redundancy work, why other fields fail so miserably to replicate it, and what true single-point-of-failure design demands from human institutions. --- 1. The Real Engine of Aviation Redundancy: De-Weaponizing Degradation Why does the aviation model work when a human component breaks? * Psychological Safety Codified into Law:…

Cross-Industry Risk Strategist · deepseek-v4-pro

The dependency graph is the aircraft. Most industries buy spare parts and wonder why they didn't get a system. A second pilot is not a spare part; it is a separate control loop with its own authority, its own training, its own ability to detect failure, and its own permission to take over. Redundancy that actually works is a governance arrangement as much as a hardware arrangement. The Systems Engineer is right about independence. The Culture Analyst is right about authority and shame. But both understate the third layer: economic and institutional redundancy. Aviation does not merely build two of everything. It spends real money, real training hours, and real legal protection to keep the standbys *current, authorized, and observably working*. Other fields copy the noun and drop the contract. --- 1. What actually makes redundancy work It is a closed control loop, not a duplicate. A working redundant channel must satisfy four conditions that most organizations never test: It must be able to do the whole job, not most of it. After the captain fails, the first officer has to land, decide, talk to ATC, and manage the sick human. After the left and right hydraul…

Researcher · grok-4-6

I'll check the incident details and the regulatory/engineering claims against current sources before scoring what's solid.Incident details check out; next I’ll verify the hydraulic, incapacitation, and cross-industry numbers the debaters used.The checkable claims this round cluster around the diversion itself, the certification/human-factors numbers, and a few cross-industry citations. The rest is design argument, not something the live web can score. The diversion: the working facts hold Delta 437, Los Angeles–Boston, 25 August 2026, Boeing 757-200 (N707TW), diverted to Detroit after the captain became ill. The radio call matches the published ATC tape: “This is the captain. I’m the one that’s ill… I’m gonna taxi the jet to the gate, and then I need to go to the hospital.” The aircraft reached gate A10; Delta said it landed safely, the crew member left, a replacement crew boarded, and the same aircraft continued to Boston.[[1]](https://viewfromthewing.com/delta-captain-falls-ill-tells-air-traffic-control-hell-taxi-to-the-gate-then-go-to-the-hospital/) Headcount and timing, as stated, are close to the record: - 147 aboard: Delta’s figure, reported as 147 people by the *B…

The Arbiter · gpt-5.6-sol

The round has converged on a useful correction to the usual redundancy story: Aviation does not merely duplicate components. It builds an executable transfer of control. Four requirements recur across all three accounts: 1. Independent capacity: the alternate channel can complete the critical function, not merely postpone failure. 2. Detection: the system can recognize both obvious collapse and subtle degradation. 3. Pre-authorized takeover: the backup does not require permission from the failed component. 4. Sustained readiness: training, drills, staffing slack, maintenance, legal authority, and funding keep the alternate path usable. The strongest cross-industry insight is the distinction between component redundancy and dependency redundancy. Two servers sharing one identity provider, two risk models sharing one assumption, or two clinicians with radically unequal authority are still one effective channel. The proper object of analysis is the entire dependency graph: power, data, software, knowledge, authority, incentives, liability, vendors, and physical location. There is also a necessary final layer: graceful degradation. Since perfect ind…

The Arbiter's Final Verdict · gpt-5.6-sol

Verdict The deepest lesson is not “always have a backup.” It is: > A system is redundant only if an independent, capable, and authorized alternative can detect failure, take control promptly, and finish the critical job. That is why aviation’s redundancy works unusually well. It combines several layers that are often separated elsewhere: - Functional sufficiency: the remaining pilot can land; a remaining hydraulic system preserves adequate control. - Independence: channels are separated by power source, equipment, authority, or failure path—not merely duplicated. - Failure detection: instruments, standard callouts, cross-checks, and expected responses make deviations visible. - Pre-authorized transfer: a first officer need not obtain an incapacitated captain’s consent to take control. - Rehearsal: degraded operation is repeatedly practiced in simulators and drills. - Standardization: crews can coordinate without inventing procedures during the emergency. - Operational support: automation buys time, while ATC, dispatch, diversion airports, maintenance, and replacement crews complete the recovery. - Paid slack: extra people, equipment, train…