同じ文書をひとつ、七つの会社のAIにそのまま入れてみました。返ってきた請求を見ると、「入力トークン数」が会社ごとにすべて違っていました。一文字も変えていない、まったく同じ文書なのにです。
トークンとは、AIが文章を区切って読むときの単位で、料金もこのトークンの数で決まります。どこで区切るかを決めるのは、人が定めた文法ではありません。学習に使われた膨大な文章の中で、よく一緒に現れる文字のかたまりが基準になります。おおよそ単語か、単語の切れ端くらいの単位と考えれば大きく外れません。
トークンを数えるものさしは会社ごとに違う
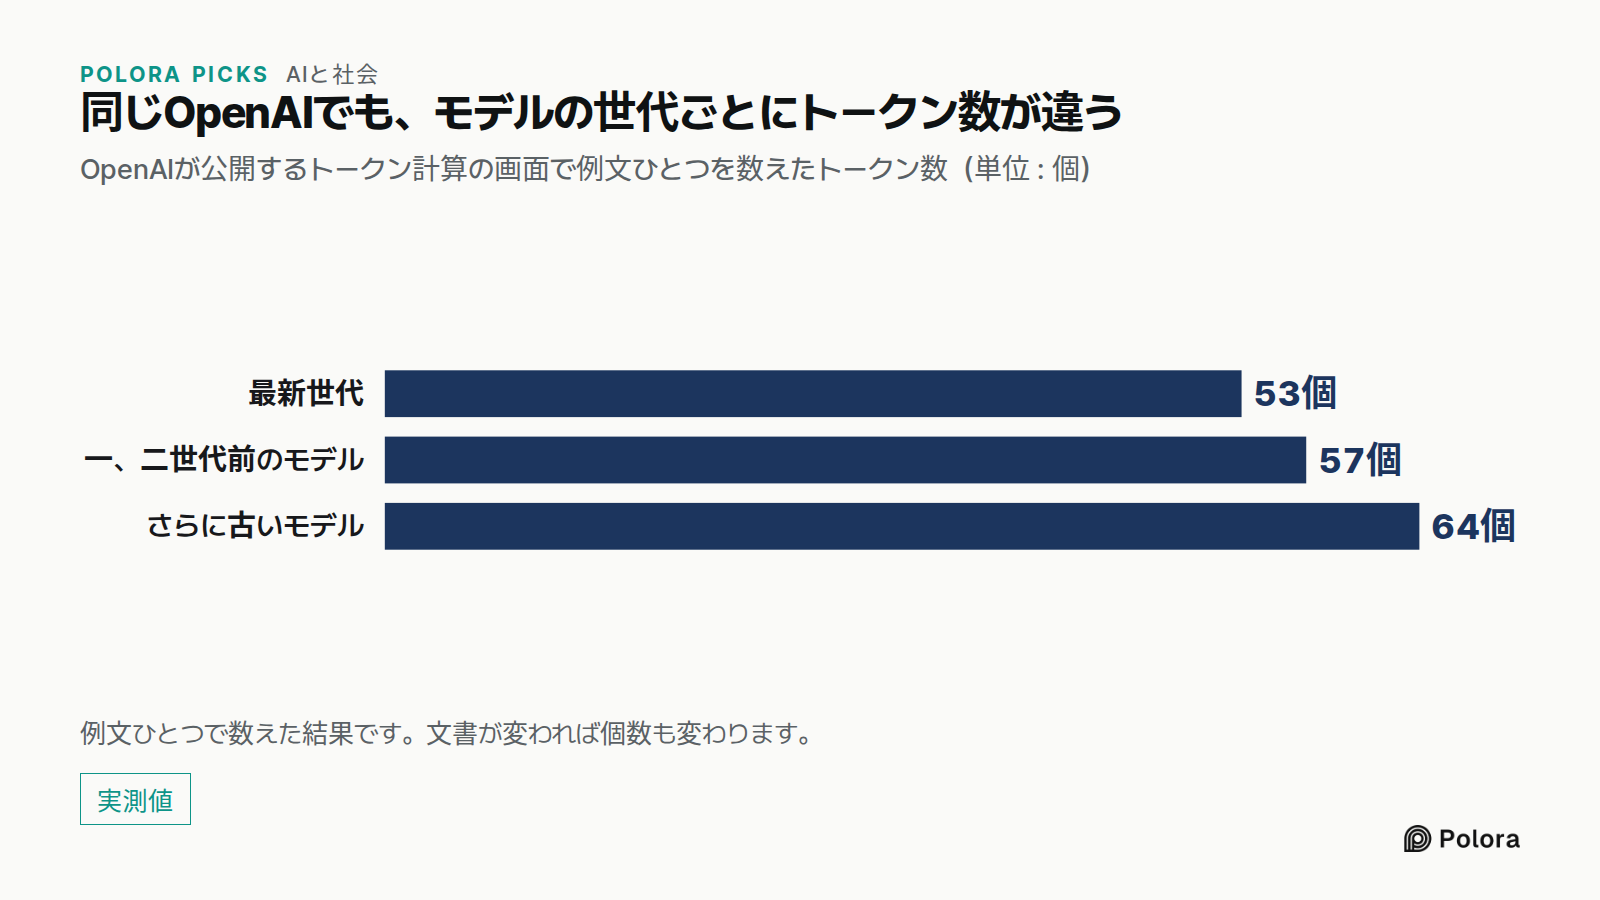
問題は、文章をどんなかたまりで区切るかを決めた一覧、つまりトークンを数えるものさし(トークナイザー)を、各社が別々に作っていることです。しかも同じ会社でも、モデルの世代が変わると一覧を作り直すことがあります。OpenAIが公開しているトークン計算の画面に例文をひとつ入れて数えると、最新世代では53個、一、二世代前のモデルでは57個、さらに古いモデルでは64個になります。ひとつの会社の中でもこれだけ開くのですから、会社どうしならなおさらです。
長さにはメートル、重さにはグラムという共通のものさしがあります。トークンにはそれがありません。各社がそれぞれ違うものさしで、同じ文章を測っているわけです。
AIの単価は据え置きなのに請求額だけが増えた
この問題に気づいたきっかけは、FinOps(クラウドやAIの費用を追跡し管理する実務分野)のあるイベントでの発表でした。発表者は、AIの利用費用を見積もるのがなぜこれほど難しいのかを指摘し、トークンの数え方が違うため、同じ料金表でも実際に出ていくお金には大きな差が出ると話していました。
実例もあります。今年4月、Anthropicは新しいモデルを出す際にトークンの数え方を変えました。料金表の単価は直前のモデルとまったく同じでしたが、同じ文章から出るトークンが最大35%増えました。単価は少しも上がっていないのに、請求額だけが大きくなったのです。
韓国語の文書で七社・十六モデルのトークン数を測ってみた
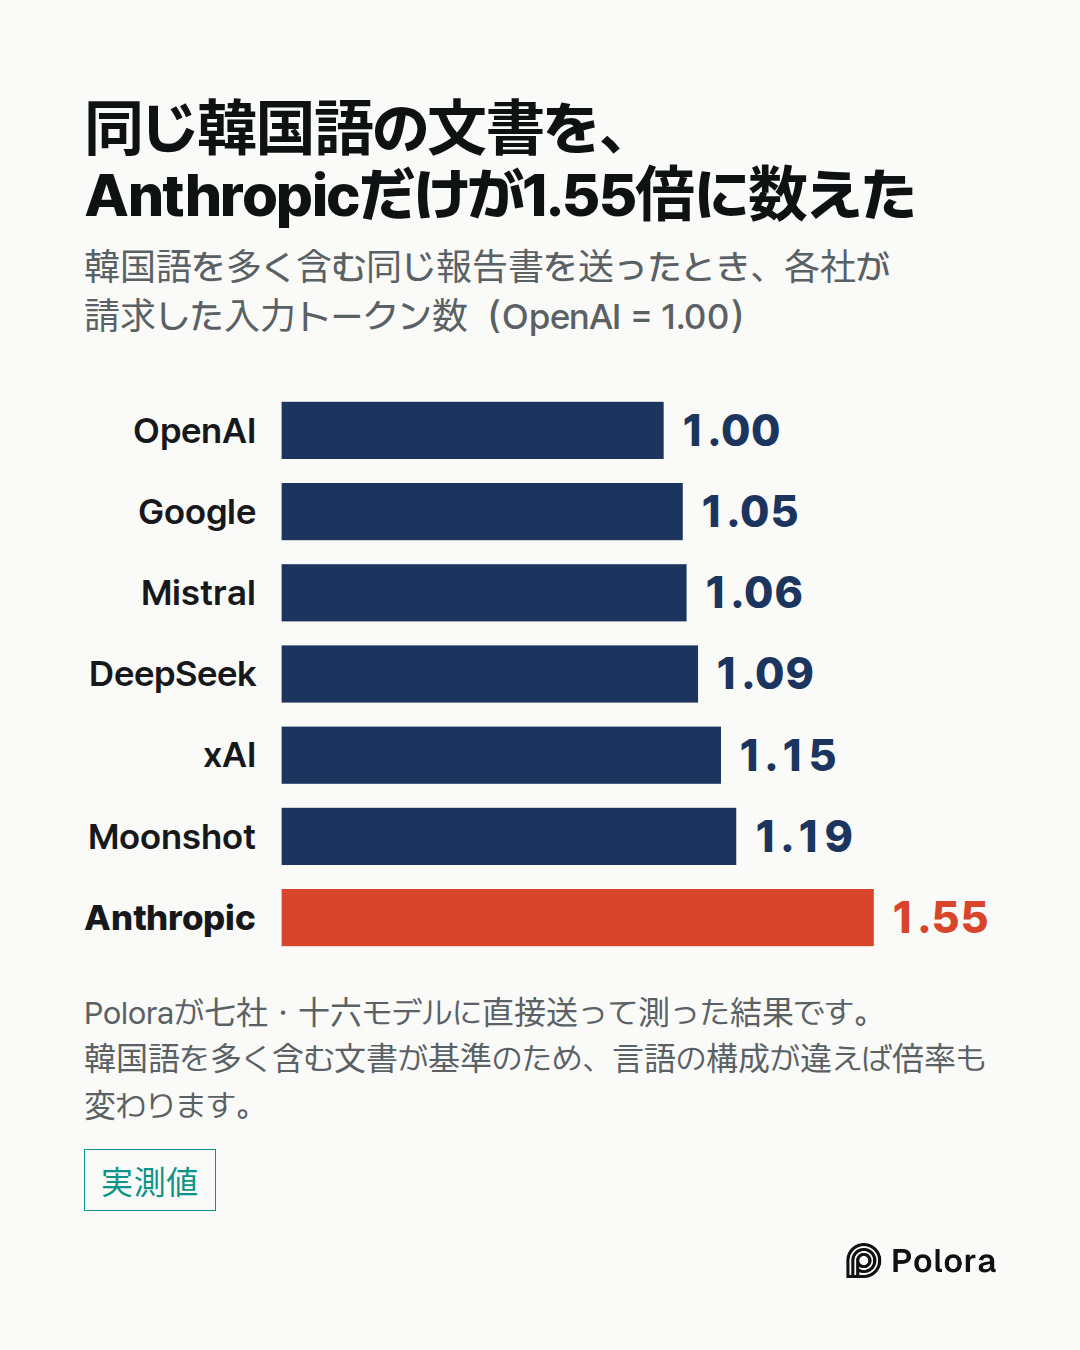
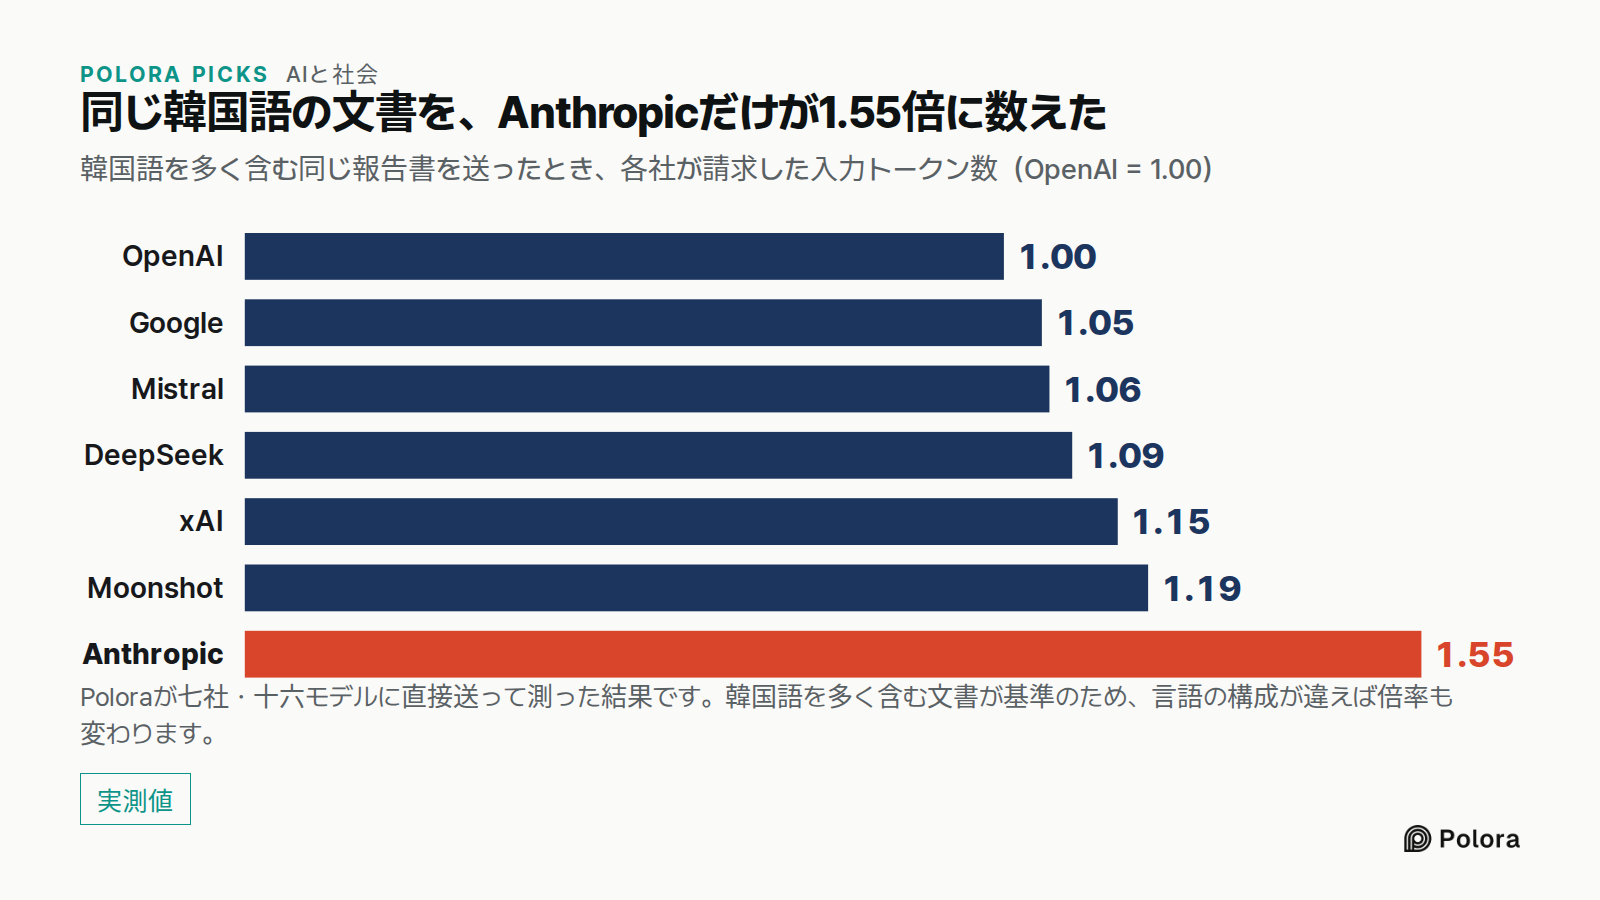
そこでPoloraで実際に測ってみました。韓国語を多く含む同じ報告書を添えた、まったく同じ質問を七つの会社の十六のモデルに何回かに分けて送り、各社が請求の根拠として返してきたトークン数を集めました。
OpenAIが数えた個数を1.00とすると、Google 1.05、Mistral 1.06、DeepSeek 1.09、xAI 1.15、Moonshot 1.19と、ほぼ横並びでした。ところがAnthropicだけは1.55と、大きく離れていました。
この数値は、送るたびに変わる偶然の結果ではありません。同じ会社・同じ世代の二つのモデルに同じ入力を121回送りましたが、トークン数は毎回ぴたりと同じでした。
AIの本当の値段は単価にトークン数を掛けて初めて見える
トークン数の違いがそのままお金の問題になるのは、AIの料金表の単位がトークンだからです。二つの会社がそろって「100万トークンあたり2ドル」と書いていても、片方が同じ文章を1.55倍に数えるなら、実際に払うお金も1.55倍になります。単価だけを比べるのは、為替レートを考えずに、通貨の違う二つの国の値札を比べるようなものです。
これは品質の良し悪しに直結する話ではありません。文章を細かく区切るやり方には性能の面で有利なところもあり、各社もそれを踏まえて単価を決めているのかもしれません。大事なのは、単価を並べるだけでは足りず、自分の文書を各社がいくつに数えるかまで掛け合わせて初めて、実際に払う額が見えるということです。ただし今回の測定は韓国語を多く含む文書を基準にしたもので、文書に含まれる言語の割合が違えば倍率も変わります。
見積書を比べるなら、単価だけでなく、数量の数え方がそろっているかまで確かめなければ、比べたことになりません。韓国語の文書で行った今回の測定でも、同じ文章に対して会社ごとに数えた個数が分かれました。AIの料金にも、長さにおけるメートルのような共通のものさしが必要になる時が来そうです。
次の記事では、同じ質問を英語で尋ねた場合と韓国語で尋ねた場合とで、料金がどれだけ開くかを測った結果を取り上げます。韓国語で書く人にとっては、少し釈然としない数字が出てきます。