El margen de error de una ventaja ronda el doble del que se publica
Una encuesta nueva da a un candidato el 48 por ciento y al otro el 44, con un margen de error de más o menos 3 puntos. La mayoría lo interpreta como una ventaja de 4 puntos que supera el margen de error. No es así.
Ese más o menos 3 se aplica al porcentaje de cada candidato por separado. La ventaja es la diferencia entre dos cifras inciertas, y en una contienda entre dos esas cifras se mueven en direcciones opuestas. Si la muestra recogió por azar demasiados partidarios de un candidato, es casi seguro que recogió demasiado pocos del otro. Por eso el error sobre la diferencia es mayor que el error sobre cualquiera de los dos porcentajes. El Pew Research Center lo dice sin rodeos : el margen de la diferencia suele ser más o menos el doble del margen de cada candidato. Una encuesta con más o menos 3 puntos en cada porcentaje tiene aproximadamente más o menos 6 en la ventaja. Es una regla práctica, no una fórmula exacta, y funciona mejor cuando entre los dos candidatos se reparten casi todo el voto.
Aplicada a la ventaja de 4 puntos, la diferencia real puede ir desde que el líder vaya unos 2 puntos por detrás hasta que vaya unos 10 por delante. La ventaja puede ser real, o puede que quien aparece segundo vaya en realidad primero. El propio ejemplo de Pew parte de una ventaja de 5 puntos con una encuesta del mismo tamaño : la diferencia real podría estar en cualquier punto entre menos 1 y más 11, de modo que el líder necesitaría unos 6 puntos de ventaja para descartar que se deba al azar de la muestra.
Por qué las cifras de las encuestas sobre jóvenes o minorías oscilan tanto
El margen que se publica corresponde a la muestra completa. Cuando una noticia se centra en una parte de ella, como los votantes menores de 30 años o una sola región, detrás de la cifra hay muchas menos personas. Pew pone el ejemplo de un subgrupo con más o menos 8 puntos en cada candidato, que se convierten en más o menos 16 en la diferencia entre ambos.
Además, a algunos grupos cuesta más localizarlos. Pew señala que los jóvenes y las minorías responden a las encuestas con menos frecuencia, así que los encuestadores dan más peso a sus respuestas para que alcancen su proporción real en la población. Ese paso, llamado ponderación, hace que la muestra sea más representativa, pero también amplía el margen de error. Un vuelco espectacular dentro de un subgrupo entre dos encuestas suele ser simple ruido.
Lo que el margen de error no tiene en cuenta
El margen de error mide una sola cosa : la probabilidad de que una muestra aleatoria de unas mil personas difiera un poco del conjunto, igual que las manos de una partida de cartas cambian de un reparto a otro. No dice nada de las demás formas en que una encuesta puede fallar.
Pew enumera tres. Hay personas a las que el método empleado no llega en absoluto, lo que se llama error de cobertura. Hay grupos menos dispuestos a contestar, que es el error de no respuesta. Y hay personas que entienden mal una pregunta o no dicen lo que de verdad piensan, que es el error de medición. Las encuestas electorales añaden una suposición más : decidir qué encuestados votarán de verdad. Para ello los encuestadores construyen los llamados modelos de votante probable, y la participación es difícil de prever.
Cuando los investigadores comparan las encuestas con los resultados reales, la desviación es mayor de lo que sugiere el margen publicado. Un estudio de más de 4000 encuestas estatales realizadas entre 1998 y 2014, firmado por estadísticos de Stanford, Microsoft Research y Columbia, halló un error típico de unos 3,5 puntos en el porcentaje de cada candidato. Esa cifra es la raíz del error cuadrático medio, una forma de promediar que da más peso a los fallos grandes, y equivale aproximadamente al doble de lo que indicaban los márgenes publicados. Pew y la Asociación Estadounidense de Investigación de la Opinión Pública (AAPOR, por sus siglas en inglés), la principal organización profesional de encuestadores, aplican hoy la misma regla práctica : el error real posible ronda el doble de la cifra publicada. Esta duplicación es independiente de la que se aplica a una ventaja, y las dos no deben multiplicarse para obtener un único margen de la ventaja. El margen publicado no refleja ninguna de las dos.
Por qué un promedio de encuestas es mejor que una sola, hasta cierto punto
Dos buenas encuestas hechas la misma semana darán resultados que difieren en un punto o dos, porque llegaron a personas distintas. Promediar muchas encuestas anula buena parte de ese ruido aleatorio y además compensa las particularidades de cada encuestadora. Según las pautas de la AAPOR, la asociación profesional de encuestadores de Estados Unidos, los promedios quitan protagonismo a los resultados individuales, que arrastran mucho ruido por la variación normal, y ofrecen una imagen más clara de las tendencias.
Promediar tiene un límite. El mismo estudio que concluyó que el error real de las encuestas duplicaba el margen declarado halló también que las encuestas sobre una misma elección tienden a equivocarse en la misma dirección, en promedio entre 1,5 y 2 puntos. Los autores apuntan una explicación : a los encuestadores les cuesta llegar a los mismos grupos y usan reglas parecidas para decidir quién votará. Un promedio no puede anular un error que comparten todas las encuestas. Por eso, una ventaja que se mantiene en muchas encuestas es mucho más creíble que la de un único sondeo, pero un promedio tampoco es una garantía.
¿Cuánto se equivocaron las encuestas de Estados Unidos en 2016, 2020, 2022 y 2024?
La AAPOR, la principal asociación de encuestadores de Estados Unidos, revisa cada ciclo presidencial. Su informe de 2024 analizó 611 encuestas sobre la presidencia, el Senado, las gobernaciones y la Cámara de Representantes realizadas en las dos últimas semanas de campaña. En promedio, se desviaron 3,3 puntos de la diferencia final entre los dos partidos. Fue una mejora respecto a los 5,3 puntos de 2020 y los 5,2 de 2016. Las encuestas presidenciales nacionales se desviaron 2,6 puntos de media, y las presidenciales estatales, 3,0. El informe afirma que las encuestas estatales fueron más precisas que en cualquier ciclo presidencial desde 1944.
Estas cifras miden el error sobre la propia diferencia, es decir, sobre el mismo número que un titular presenta como ventaja. Así que, incluso en un buen año, la encuesta final típica se desvió en la diferencia más o menos tanto como las ventajas que son noticia. Y se trata de encuestas de las dos últimas semanas. Una encuesta hecha un mes o más antes de la jornada electoral queda fuera de estas referencias, y entre el momento en que se hace y la votación las preferencias de los votantes tienen más tiempo para cambiar.
También importa hacia dónde se equivocan. En 2016, 2020 y 2024, las encuestas subestimaron a los republicanos : 2,7 puntos en la diferencia en 2024, frente a 4,6 en 2020. En las elecciones de mitad de mandato de 2022, el pequeño error medio fue en sentido contrario y sobrestimó a los republicanos en 0,6 puntos. La AAPOR señala que, desde la década de 1930, cada partido ha sido subestimado aproximadamente con la misma frecuencia, y que las encuestas rara vez fallan en la misma dirección durante más de un par de elecciones presidenciales seguidas. El error del último ciclo no es una guía fiable para el siguiente.
Por qué las encuestadoras no reducen el margen de error a 1 punto
Brasil vota el 4 de octubre, y sus votantes se hacen la misma pregunta. BBC News Brasil, en un artículo reproducido por el periódico brasileño O Povo, expuso la aritmética que limita a toda encuesta. Para lograr un margen de más o menos 3 puntos hay que entrevistar a unas 1068 personas. Para más o menos 2 hacen falta unas 2401. Para más o menos 1, unas 9604, algo demasiado caro para la mayoría de las encuestas. Reducir el margen a la mitad exige unas cuatro veces más entrevistas.
Por eso las encuestas se conforman con márgenes de unos pocos puntos y no de uno. Según el mismo artículo, la mayoría de las encuestas electorales brasileñas publican un margen de alrededor de más o menos 2. Y por eso también una ventaja de pocos puntos queda tan a menudo dentro del ruido. Raphael Nishimura, estadístico especializado en encuestas de la Universidad de Míchigan citado por la BBC, describe una encuesta como una foto del momento, no como una predicción. Una serie de encuestas a lo largo del tiempo se parece más a la película.
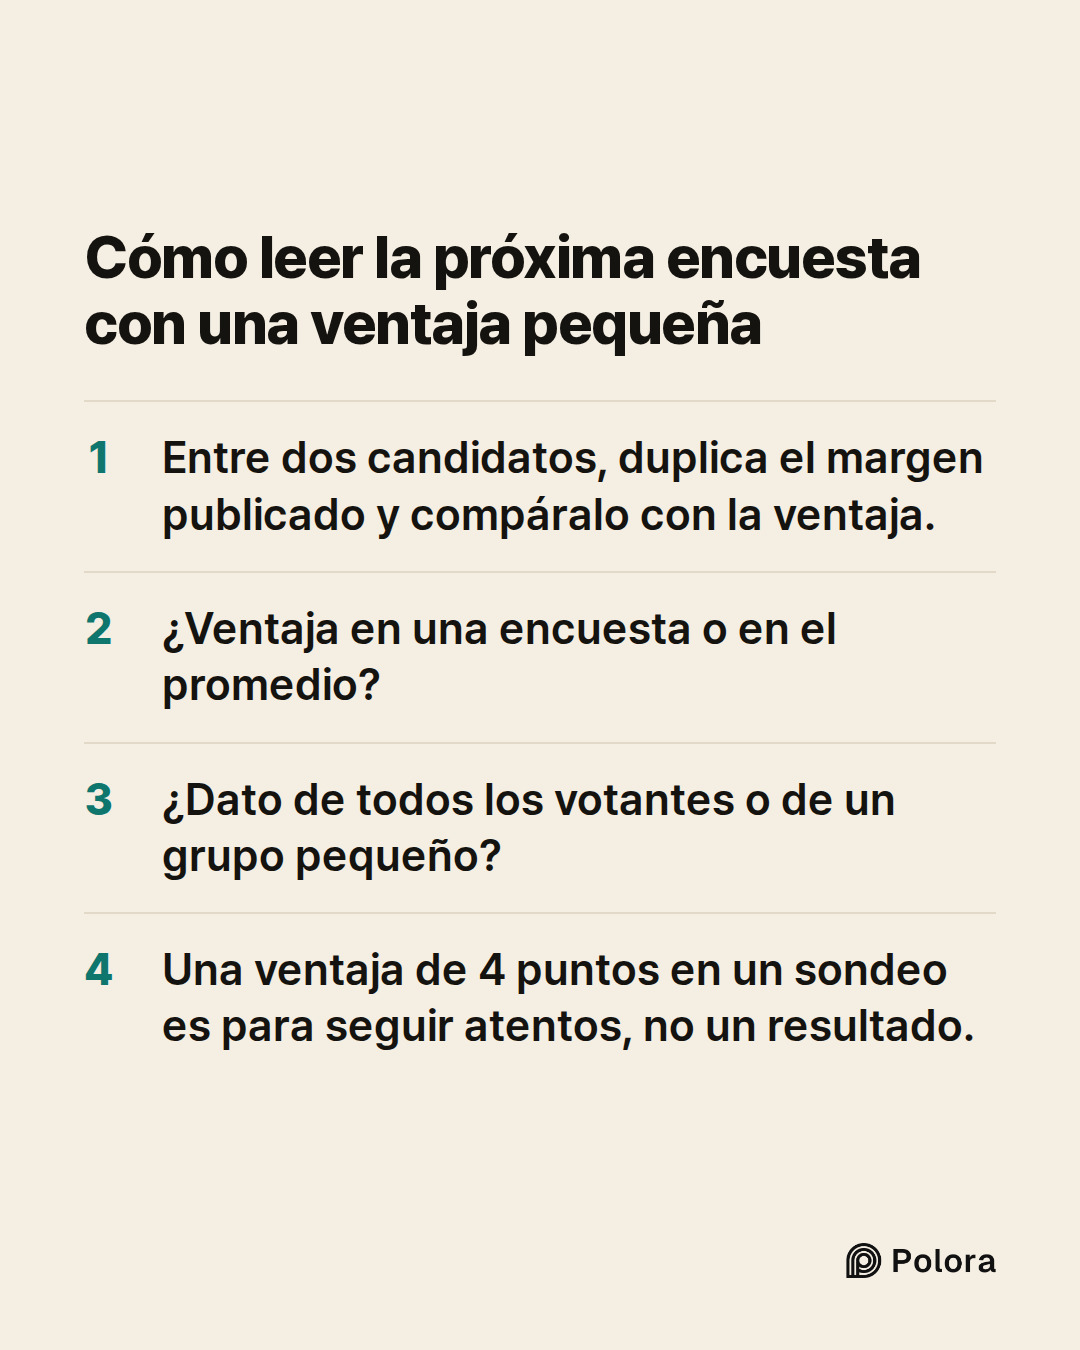
Cómo leer la próxima encuesta con una ventaja pequeña
En una contienda entre dos, conviene duplicar el margen declarado antes de compararlo con la ventaja. Si la ventaja es menor que esa cifra, la encuesta ha mostrado quién iba por delante entre las personas a las que llegó, pero no quién va por delante entre todos los votantes. Lo que ha mostrado es que la carrera está reñida. Una ventaja mayor tampoco es un pronóstico, porque siguen ahí los errores que el margen deja fuera y la opinión puede cambiar antes de la jornada electoral.
Después, hay que mirar más allá de la cifra aislada. ¿La ventaja aparece en una sola encuesta o en el promedio? ¿El dato corresponde a todos los votantes o a un grupo pequeño? Conviene recordar que incluso en 2024, un buen año, las encuestas finales se desviaron de media unos 3 puntos en la diferencia. Nada de esto hace inútiles las encuestas. En el conjunto de muchos sondeos, suelen quedar a pocos puntos del resultado. Pero unos pocos puntos son justamente la distancia de una carrera reñida, y una ventaja de 4 puntos en una sola encuesta es un motivo para seguir atentos, no un resultado.