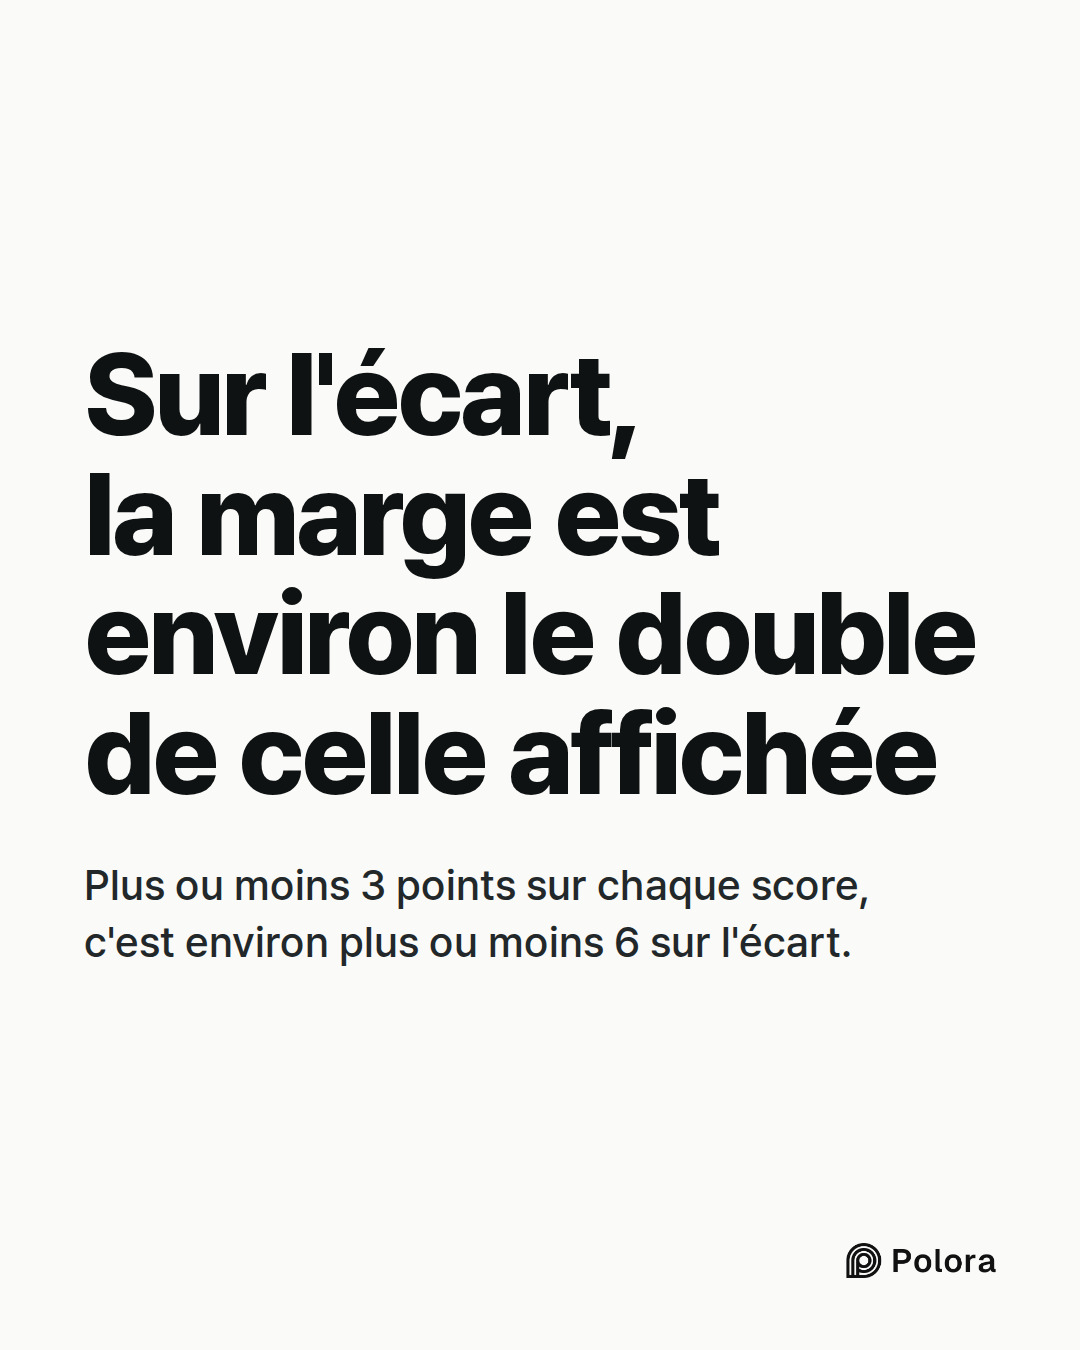
Sur l'écart entre deux candidats, la marge d'erreur est environ deux fois plus grande que celle affichée
Un nouveau sondage donne un candidat à 48 % et l'autre à 44 %, avec une marge d'erreur de plus ou moins 3 points. La plupart des gens y voient une avance de 4 points, supérieure à la marge d'erreur. Ce n'est pas le cas.
Les 3 points en plus ou en moins portent sur le score de chaque candidat pris isolément. L'avance, elle, est la différence entre deux chiffres incertains l'un comme l'autre, et dans un duel ils bougent en sens contraire. Si l'échantillon compte par hasard trop de partisans d'un candidat, il compte presque sûrement trop peu de partisans de l'autre. L'erreur sur l'écart est donc plus grande que l'erreur sur chacun des deux scores. Le Pew Research Center, un institut d'études américain, le dit sans détour : la marge sur la différence est en général à peu près le double de la marge sur un candidat. Autrement dit, un sondage à plus ou moins 3 points sur chaque score présente une marge d'environ plus ou moins 6 points sur l'écart. C'est un ordre de grandeur et non une formule exacte, et il vaut surtout quand les deux candidats se partagent presque toutes les voix.
Appliquons cela à l'avance de 4 points. L'écart réel peut plausiblement aller d'un retard d'environ 2 points pour le candidat en tête à une avance d'environ 10 points. L'avance est peut-être réelle, mais il se peut aussi que le candidat distancé soit en fait devant. Pew donne son propre exemple chiffré, avec une avance de 5 points et un sondage de même taille : l'écart réel pourrait se situer n'importe où entre moins 1 et plus 11. Il faudrait donc que le candidat en tête ait environ 6 points d'avance pour qu'on puisse écarter le simple hasard de l'échantillon.
Pourquoi les chiffres des sondages sur les jeunes ou les minorités varient autant
La marge annoncée vaut pour l'échantillon entier. Quand un article se concentre sur une partie de cet échantillon, par exemple les moins de 30 ans ou une seule région, le chiffre repose sur beaucoup moins de personnes. L'institut Pew cite l'exemple d'un sous-groupe dont la marge est de plus ou moins 8 points sur chaque candidat, ce qui donne plus ou moins 16 points sur l'écart entre les deux.
Certains groupes sont aussi plus difficiles à joindre. Pew relève que les jeunes et les minorités répondent moins souvent aux enquêtes, si bien que les instituts accordent plus de poids à leurs réponses pour les ramener à leur part réelle dans la population. Cette étape, appelée pondération, rend l'échantillon plus représentatif, mais elle élargit aussi la marge d'erreur. Un revirement spectaculaire au sein d'un sous-groupe d'un sondage à l'autre n'est souvent que du bruit.
Ce que la marge d'erreur ne mesure pas
La marge d'erreur ne mesure qu'une chose : le risque qu'un échantillon d'environ mille personnes tirées au hasard diffère un peu de l'ensemble de la population, comme la main qu'on reçoit aux cartes change d'une donne à l'autre. Elle ne dit rien des autres façons dont un sondage peut se tromper.
L'institut Pew en cite trois. Certaines personnes sont tout simplement injoignables par la méthode employée, c'est l'erreur de couverture. Certains groupes acceptent moins volontiers de répondre, c'est la non-réponse. Certaines personnes comprennent mal une question ou ne disent pas ce qu'elles pensent vraiment, c'est l'erreur de mesure. Les sondages électoraux reposent en outre sur un pari : deviner quels répondants iront réellement voter. Les instituts construisent pour cela des modèles dits d'électeurs probables, et la participation est difficile à prévoir.
Quand des chercheurs comparent les sondages aux résultats réels, l'écart dépasse ce que laisse attendre la marge annoncée. Des statisticiens de Stanford, de Microsoft Research et de Columbia ont étudié plus de 4 000 sondages menés à l'échelle des États américains entre 1998 et 2014. Ils ont trouvé une erreur typique d'environ 3,5 points sur le score d'un candidat. Ce chiffre est une erreur quadratique moyenne, une façon de faire la moyenne qui donne plus de poids aux erreurs les plus fortes, et il est à peu près le double de ce qu'impliquaient les marges publiées. Pew et l'American Association for Public Opinion Research (AAPOR), principale organisation professionnelle des sondeurs aux États-Unis, retiennent désormais le même ordre de grandeur : le risque d'erreur réel est environ le double du chiffre annoncé. Ce doublement est distinct de celui qui s'applique à une avance, et il ne faut pas multiplier les deux pour obtenir une marge unique sur l'écart. La marge annoncée ne montre ni l'un ni l'autre.
Pourquoi une moyenne de sondages vaut mieux qu'un sondage isolé, jusqu'à un certain point
Deux bons sondages réalisés la même semaine afficheront un ou deux points d'écart, parce qu'ils n'ont pas interrogé les mêmes personnes. Faire la moyenne de nombreux sondages efface une bonne partie de ce bruit aléatoire et gomme aussi les particularités de chaque institut. Selon les recommandations de l'AAPOR, l'association professionnelle des sondeurs américains, les moyennes détournent l'attention des résultats isolés, très bruités par les variations normales, et donnent une vision plus claire des tendances.
La moyenne a pourtant une limite. L'étude qui a montré que l'erreur réelle des sondages était environ le double de la marge annoncée a aussi constaté que les sondages portant sur une même élection ont tendance à se tromper dans le même sens, d'environ 1,5 à 2 points en moyenne. Les auteurs avancent une explication : les instituts peinent à joindre les mêmes groupes et appliquent des règles semblables pour déterminer qui votera. Une moyenne ne peut pas annuler une erreur que tous les sondages partagent. Une avance qui se maintient dans de nombreux sondages est donc bien plus crédible que celle d'une seule enquête, mais une moyenne n'est pas non plus une garantie.
De combien les sondages américains se sont-ils trompés en 2016, 2020, 2022 et 2024 ?
L'AAPOR, l'association professionnelle des sondeurs américains, dresse un bilan après chaque élection présidentielle. Son rapport sur 2024 a examiné 611 sondages portant sur la présidentielle, le Sénat, les postes de gouverneur et la Chambre des représentants, réalisés au cours des deux dernières semaines de campagne. En moyenne, ils se sont trompés de 3,3 points sur l'écart final entre les deux partis. C'est mieux qu'en 2020 (5,3 points) et qu'en 2016 (5,2 points). Les sondages présidentiels nationaux se sont trompés de 2,6 points en moyenne, et ceux menés dans les États de 3,0 points. Selon le rapport, les sondages présidentiels dans les États n'avaient jamais été aussi précis depuis 1944.
Ces chiffres mesurent l'erreur sur l'écart lui-même, c'est-à-dire le même chiffre que l'avance affichée en une. Même lors d'une bonne année, le sondage final typique s'est donc trompé sur l'écart d'à peu près autant que les avances qui font les gros titres. Et il s'agit là des sondages des deux dernières semaines. Un sondage réalisé un mois ou plus avant le scrutin n'entre pas dans ces mesures, et les préférences des électeurs ont davantage le temps d'évoluer ensuite.
Le sens de l'erreur compte aussi. En 2016, 2020 et 2024, les sondages ont sous-estimé les républicains, de 2,7 points sur l'écart en 2024 contre 4,6 points en 2020. Lors des élections de mi-mandat de 2022, la faible erreur moyenne est allée dans l'autre sens, surestimant les républicains de 0,6 point. L'AAPOR note que depuis les années 1930, chaque parti a été sous-estimé à peu près aussi souvent que l'autre, et que les sondages se trompent rarement dans le même sens plus de deux présidentielles d'affilée. L'erreur de la dernière élection ne permet pas de prévoir celle de la suivante.
Pourquoi les sondeurs ne ramènent pas simplement la marge à 1 point
Le Brésil vote le 4 octobre, et les électeurs brésiliens se posent la même question. BBC News Brasil, dans un article repris par le quotidien brésilien O Povo, a détaillé le calcul qui limite tout sondage. Pour obtenir une marge de plus ou moins 3 points, il faut interroger environ 1 068 personnes. Pour plus ou moins 2 points, il en faut environ 2 401. Pour plus ou moins 1 point, il en faut environ 9 604, ce qui coûte trop cher pour la plupart des sondages. Diviser la marge par deux demande environ quatre fois plus d'entretiens.
C'est pourquoi les sondages se contentent de marges de quelques points plutôt que d'un seul. D'après le même article, la plupart des sondages électoraux brésiliens affichent une marge d'environ plus ou moins 2 points. C'est aussi pourquoi une avance de quelques points se trouve si souvent noyée dans le bruit. Raphael Nishimura, statisticien spécialiste des enquêtes à l'université du Michigan, cité par la BBC, décrit un sondage comme une photographie du moment et non comme une prédiction. Une série de sondages dans le temps se rapproche davantage du film.
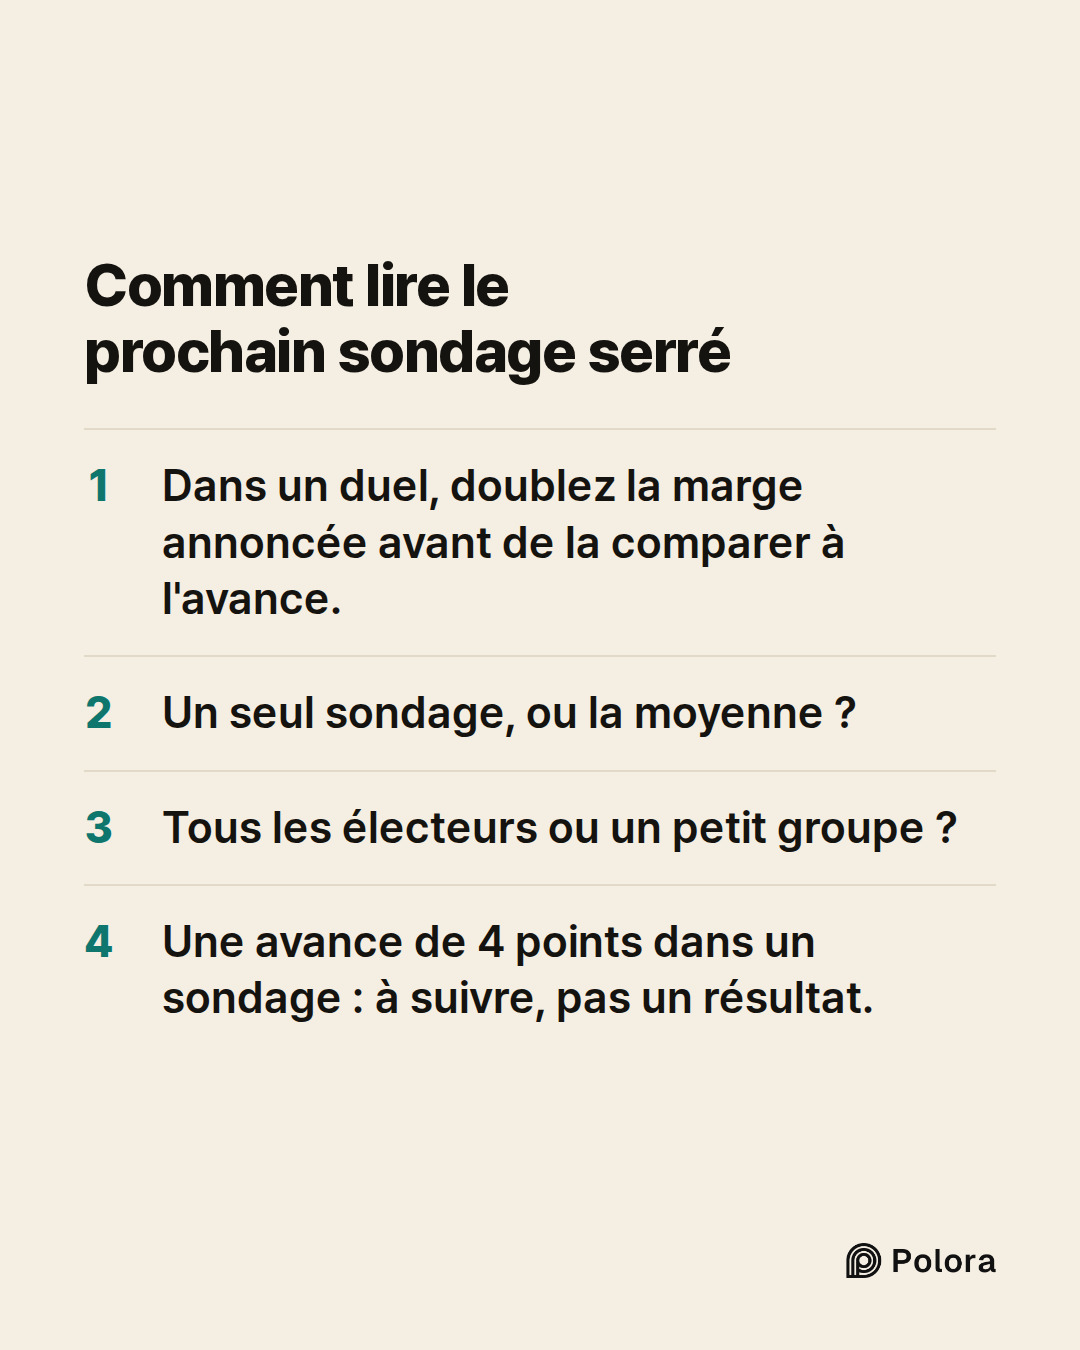
Comment lire le prochain sondage qui annonce une faible avance
Dans un duel, doublez la marge annoncée avant de la comparer à l'avance. Si l'avance est inférieure à ce chiffre, le sondage montre qui est en tête parmi les personnes interrogées, mais pas parmi l'ensemble des électeurs. Ce qu'il montre, c'est que la course est serrée. Une avance supérieure n'est pas pour autant une prévision, car les erreurs que la marge ne couvre pas demeurent et l'opinion peut encore bouger avant le scrutin.
Ensuite, regardez au-delà du chiffre isolé. L'avance apparaît-elle dans un seul sondage ou dans la moyenne ? Le chiffre porte-t-il sur tous les électeurs ou sur un petit groupe ? Gardez en tête que même en 2024, une bonne année, les derniers sondages se sont trompés d'environ 3 points en moyenne sur l'écart. Rien de tout cela ne rend les sondages inutiles. Sur un grand nombre d'enquêtes, ils tombent généralement à quelques points près. Quelques points d'écart, c'est justement le propre d'une course serrée, et une avance de 4 points dans un seul sondage est une raison de continuer à suivre la campagne, pas un résultat.