Nous avons envoyé un seul et même document aux IA de sept entreprises. Sur les factures qui sont revenues, le « nombre de tokens en entrée » était différent à chaque fois. Pourtant, pas une lettre du document n'avait changé.
Un token (on dit aussi « jeton ») est l'unité par laquelle une IA découpe le texte qu'elle lit, et c'est aussi au nombre de tokens que l'usage est facturé. Le découpage ne suit pas une grammaire fixée par des humains. Il repose sur les groupes de caractères qui revenaient souvent ensemble dans l'immense masse de textes ayant servi à entraîner le modèle. On ne se trompe donc guère en se représentant un token comme un mot ou un morceau de mot.
Chaque entreprise a sa propre règle pour compter les tokens
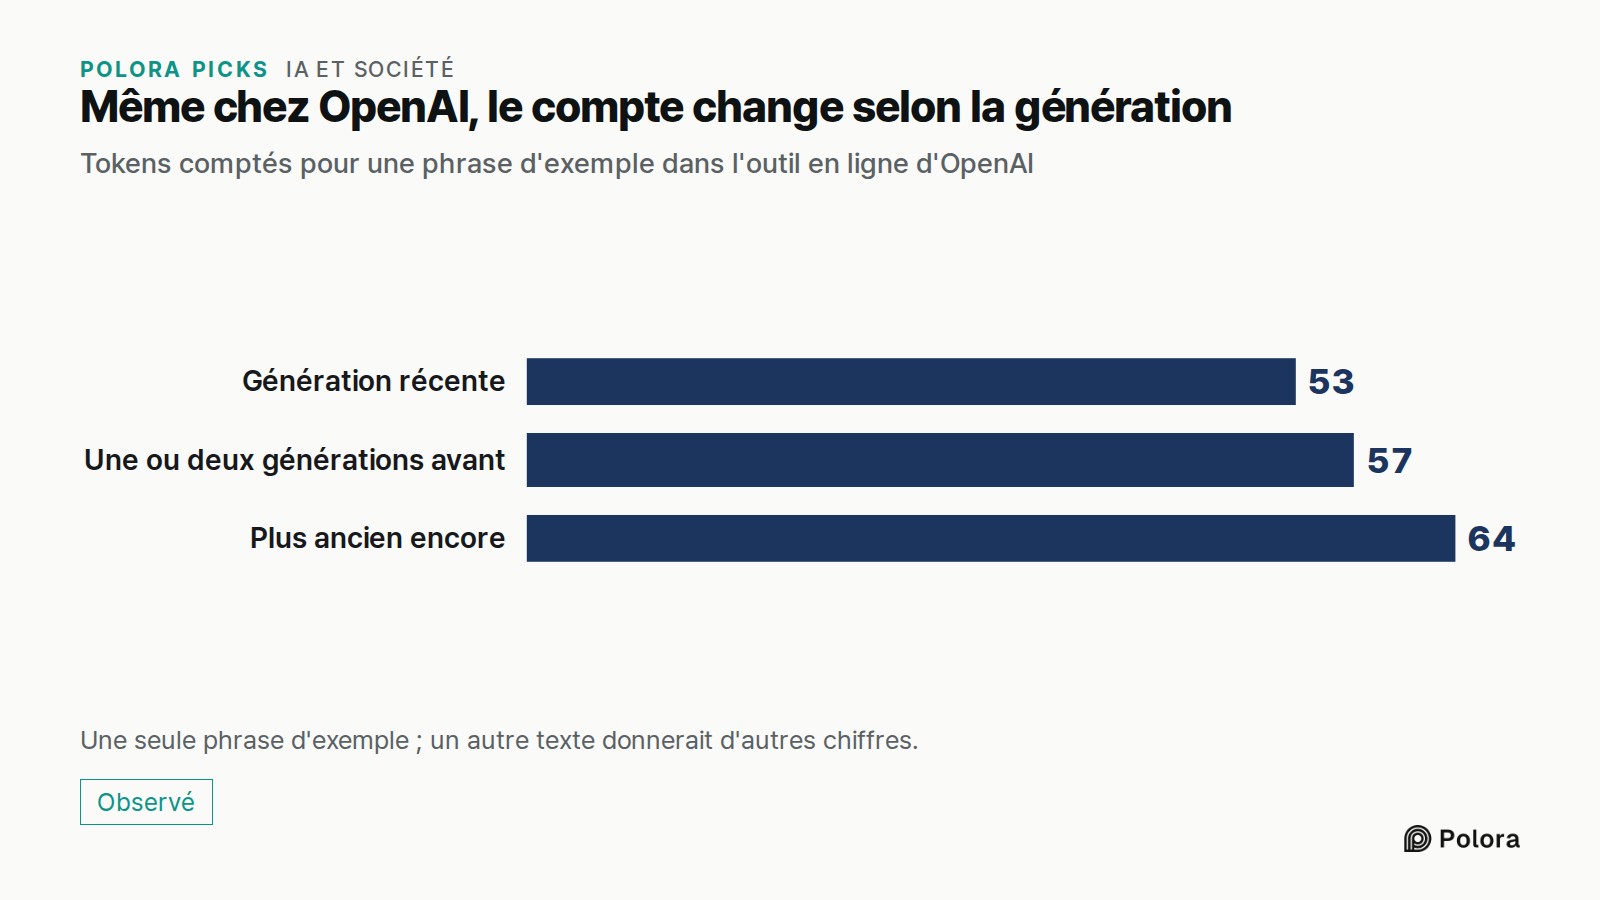
Le problème, c'est que chaque entreprise établit sa propre liste des morceaux selon lesquels le texte sera découpé, autrement dit sa propre règle de comptage (ce qu'on appelle un tokenizer). Une même entreprise peut d'ailleurs refaire cette liste quand elle change de génération de modèles. Si l'on colle une phrase d'exemple dans l'outil de comptage qu'OpenAI met en ligne, on obtient 53 tokens avec la génération la plus récente, 57 avec un modèle plus ancien d'une ou deux générations, et 64 avec un modèle plus ancien encore. Si l'écart est déjà aussi grand au sein d'une seule entreprise, on imagine ce qu'il en est d'une entreprise à l'autre.
Pour les longueurs, il existe une unité commune, le mètre, et pour les masses, le gramme. Pour les tokens, rien de tel. Chacun mesure le même texte avec sa propre règle graduée.
Le tarif de l'IA n'a pas bougé, mais la facture a grossi
Ce problème a d'abord attiré notre attention lors d'une intervention à un événement consacré au FinOps, la pratique qui consiste à suivre et à maîtriser les dépenses de cloud et d'IA. L'intervenant expliquait pourquoi il est si difficile d'estimer ce que coûte l'usage d'une IA, et soulignait que, les méthodes de comptage des tokens étant différentes, une même grille tarifaire peut aboutir à des montants réellement payés très différents.
Un cas concret l'illustre. En avril dernier, Anthropic a sorti un nouveau modèle et changé au passage sa façon de compter les tokens. Le tarif affiché était exactement celui du modèle précédent, mais un même texte produisait jusqu'à 35 % de tokens en plus. Le prix unitaire n'avait pas augmenté d'un centime, et pourtant la facture, elle, avait grossi.
Nous avons mesuré les tokens de seize modèles de sept entreprises sur un document en coréen
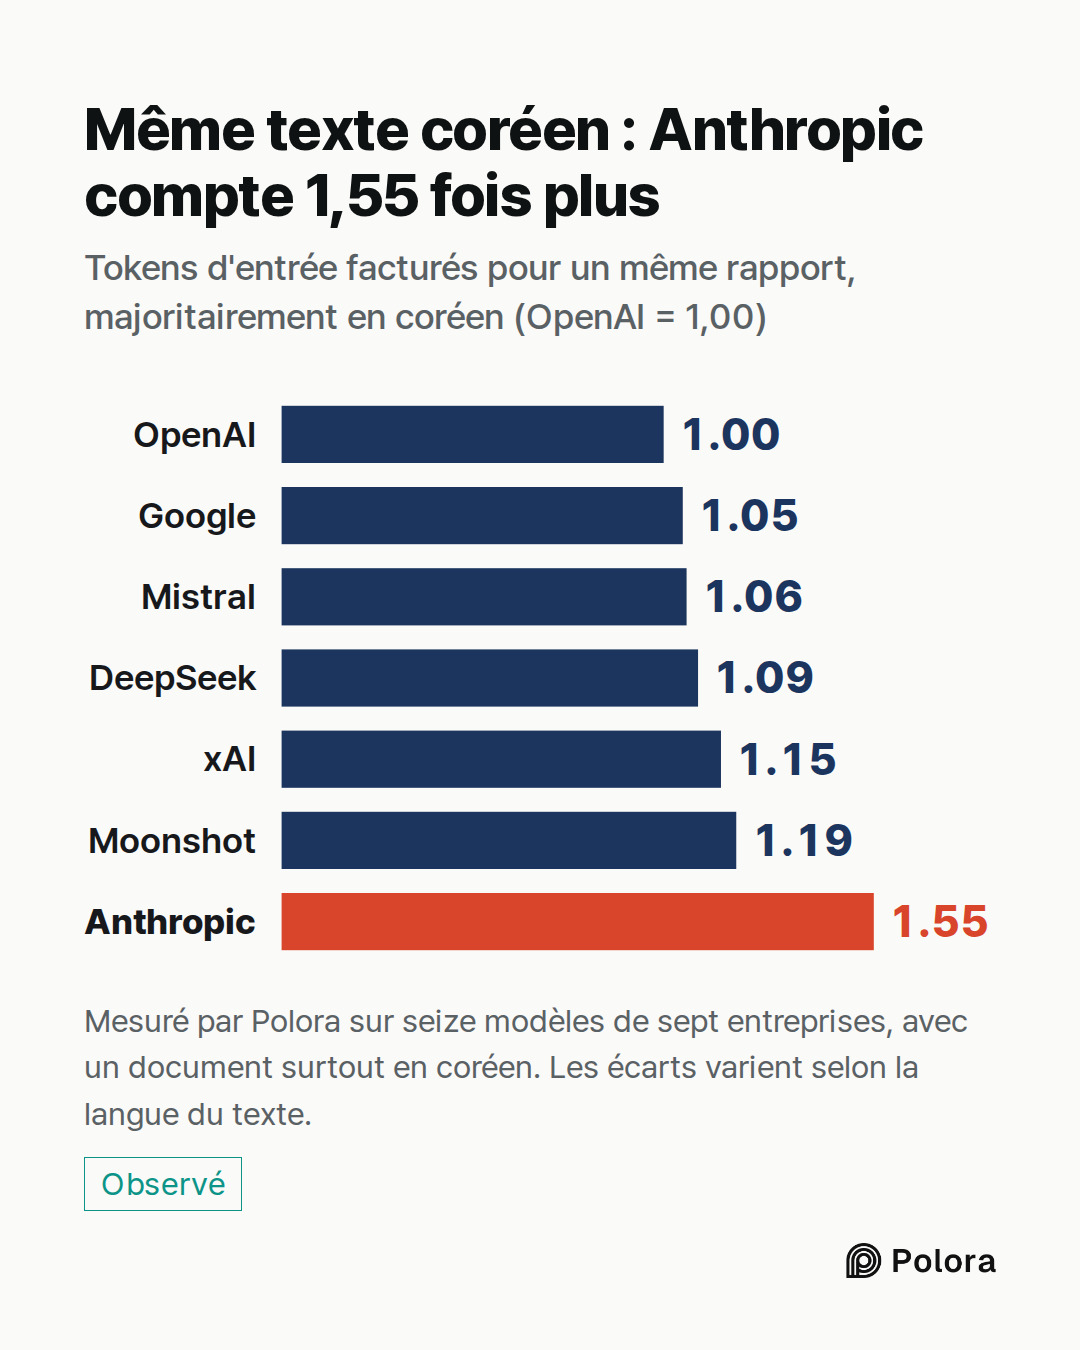
Chez Polora, nous avons donc fait la mesure nous-mêmes. Nous avons envoyé, en plusieurs fois, la même question accompagnée du même rapport, rédigé en grande partie en coréen, à seize modèles de sept entreprises, et recueilli le nombre de tokens que chaque entreprise renvoyait comme base de facturation.
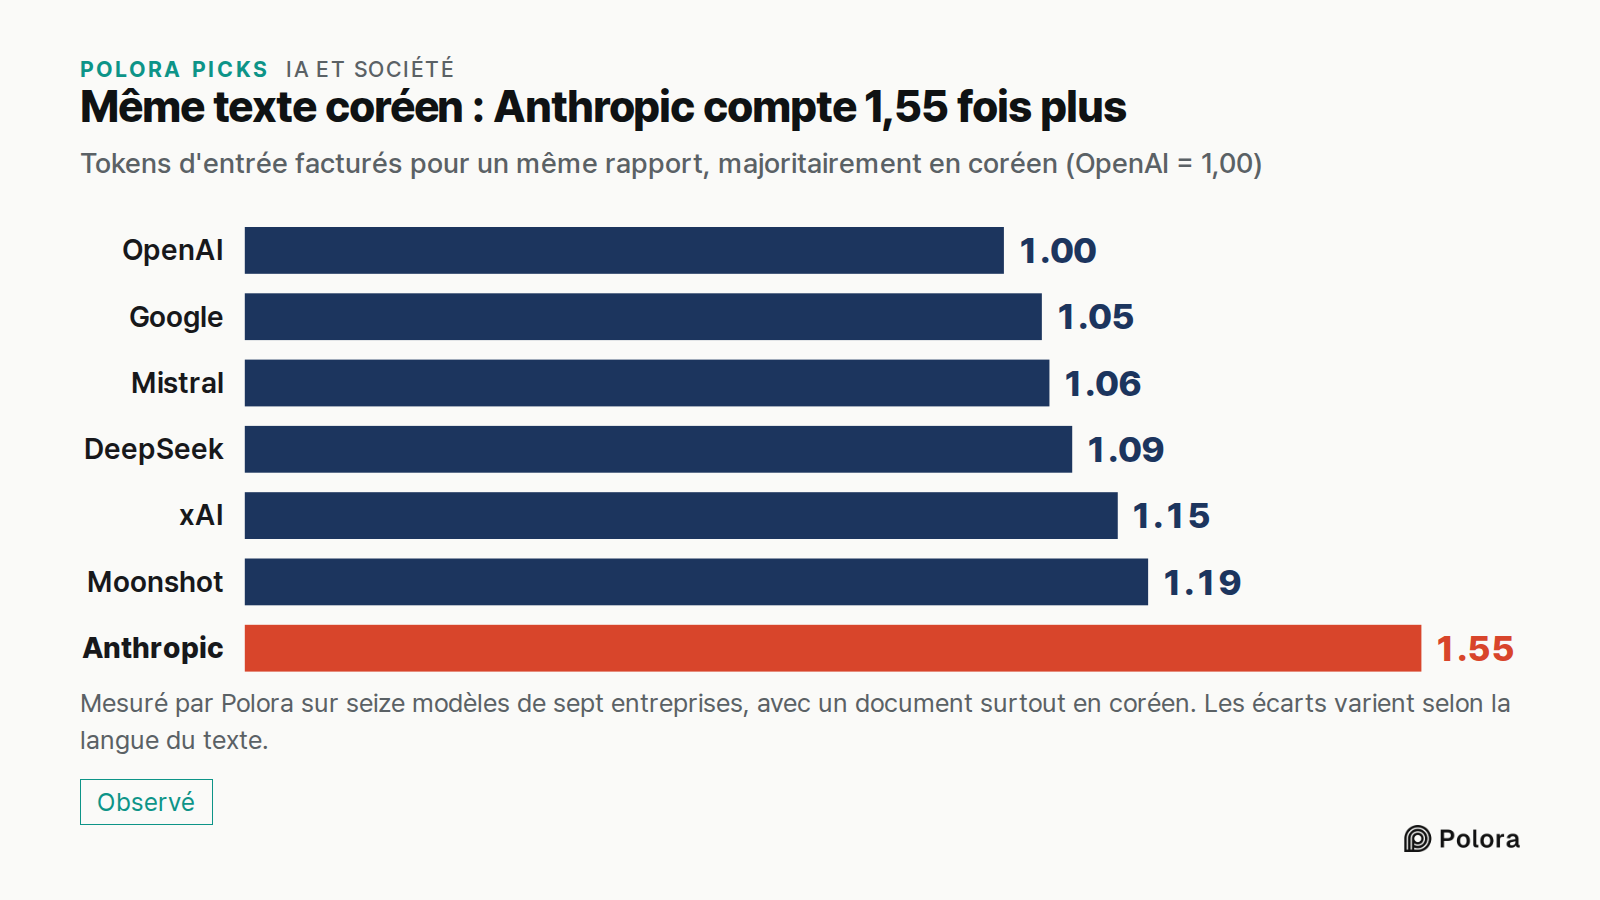
En prenant pour référence le nombre compté par OpenAI, fixé à 1,00, on obtient 1,05 pour Google, 1,06 pour Mistral, 1,09 pour DeepSeek, 1,15 pour xAI et 1,19 pour Moonshot, des valeurs assez proches les unes des autres. Seul Anthropic se détache nettement, à 1,55.
Ces chiffres ne doivent rien au hasard et ne varient pas d'un envoi à l'autre. Nous avons soumis 121 fois la même entrée à deux modèles d'une même entreprise et d'une même génération, et le nombre de tokens n'a jamais varié d'une seule unité.
Le vrai prix d'une IA, c'est le tarif multiplié par le nombre de tokens
Si un écart dans le nombre de tokens devient une question d'argent, c'est parce que les grilles tarifaires des IA sont exprimées en tokens. Deux entreprises peuvent afficher le même prix de 2 dollars par million de tokens ; si l'une compte le même texte 1,55 fois plus que l'autre, la somme réellement payée est elle aussi 1,55 fois plus élevée. C'est comme comparer les étiquettes de prix de deux pays aux monnaies différentes sans tenir compte du taux de change.
Cela ne dit rien, en soi, de la qualité. Découper le texte plus finement peut avoir des avantages pour les performances, et les entreprises ont peut-être fixé leurs tarifs en en tenant compte. L'essentiel est ailleurs : il ne suffit pas de mettre les tarifs côte à côte, il faut aussi les multiplier par le nombre de tokens que chaque entreprise compte pour vos propres documents afin de voir ce que vous paierez vraiment. Précisons que cette mesure a été faite sur un document rédigé en grande partie en coréen, et que les rapports changent avec la composition linguistique du texte.
Quand on reçoit un devis, il faut vérifier que les quantités sont comptées selon la même règle avant même de comparer les prix unitaires. Dans cette mesure réalisée sur un document en coréen, le même texte n'a pas été compté de la même façon d'une entreprise à l'autre. Le moment approche peut-être où la facturation de l'IA aura besoin, elle aussi, d'une unité commune, comme le mètre pour les longueurs.
Dans le prochain article, nous verrons de combien le prix s'écarte selon qu'on pose la même question en anglais ou en coréen. Les chiffres sont un peu injustes pour ceux qui écrivent en coréen.