「損は得の2倍つらい」は本当? 損失回避の数字の出どころ

多くの実験で、人は同じ額なら得より損を重く見て選びます。ただ「2倍」は1992年の学生25人の中央値で、その後の推定は約2から約1まで幅があります。

2026-11-12

「損の痛みは得の2倍」はどこから来たのか

ふたつの日を思い浮かべてください。ある日、思いがけず100ドルを拾う。別の日に100ドルをなくす。たいていの人は、あとの日のほうが長く心に残ると言います。よく聞く説明はそこに数字を添えます。損の痛みは、同じ額の得の喜びのおよそ2倍だ、と。

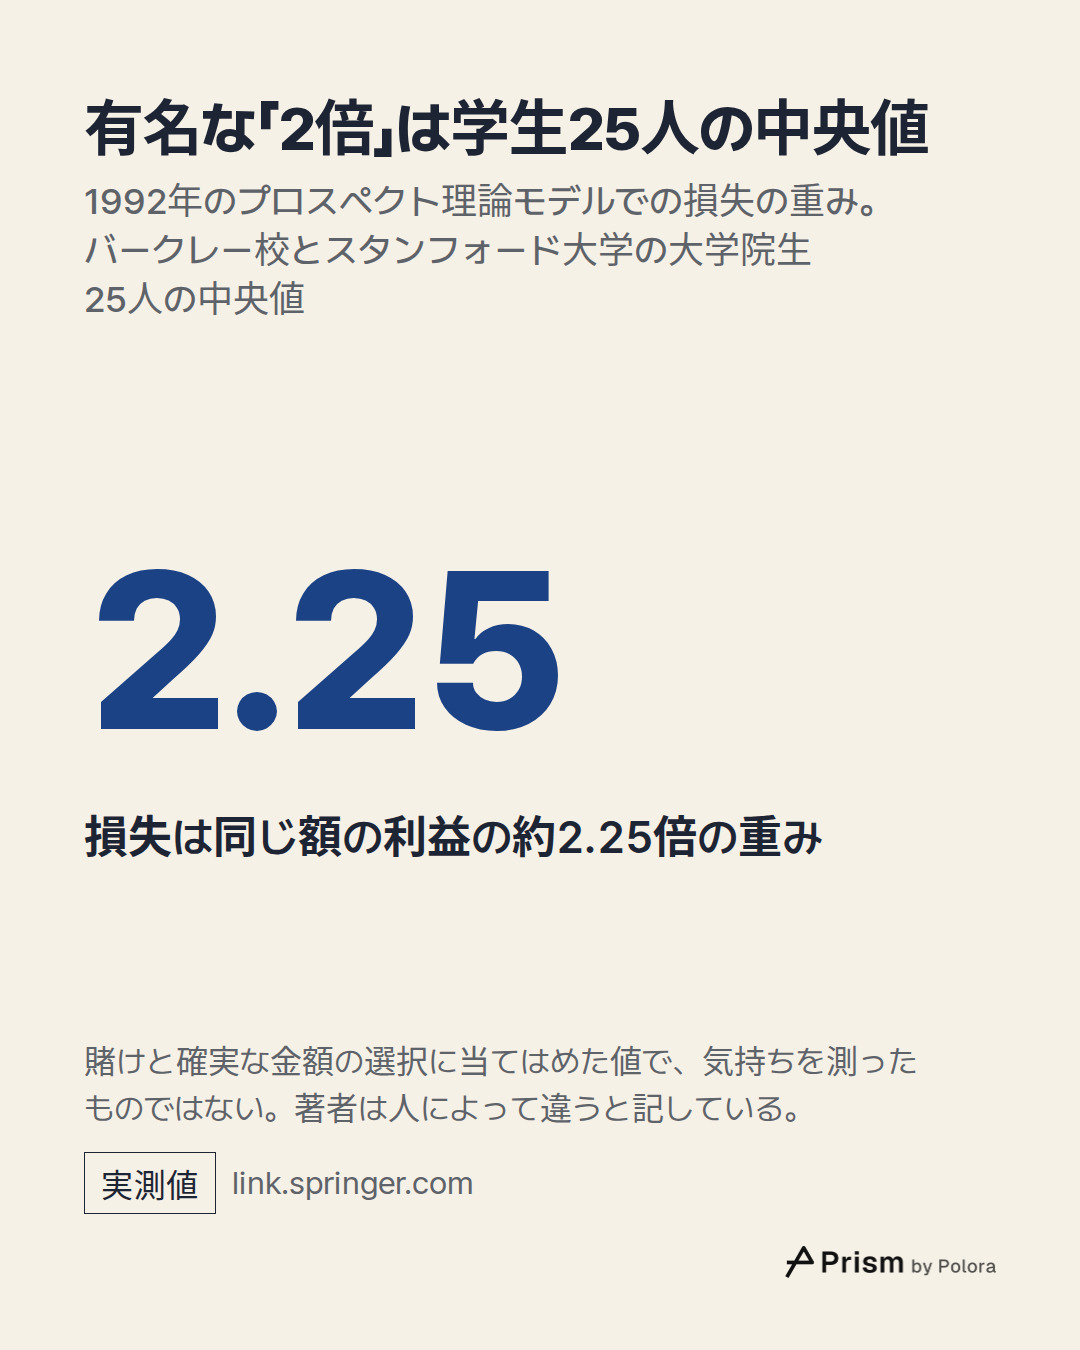
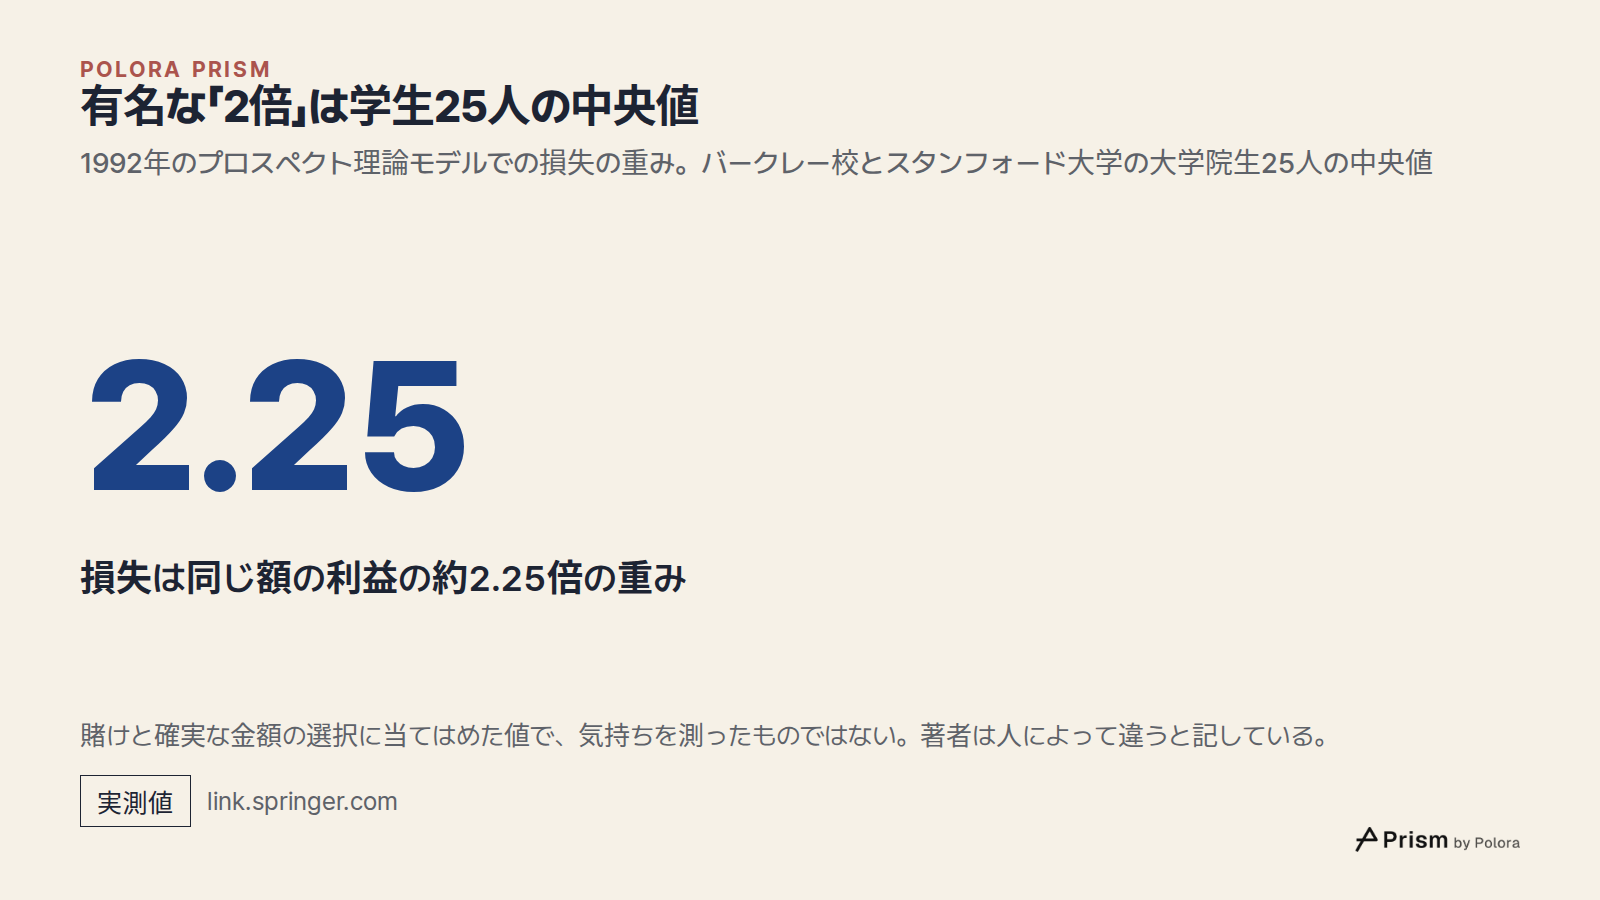
この数字には出どころがあります。1979年、心理学者のダニエル・カーネマンとエイモス・トベルスキーが「プロスペクト理論」を発表しました。結果が不確かなとき、人が実際にどう選ぶのかを描いた理論です(学術誌Econometrica、1979年)。1992年、ふたりはこれを改良し、カリフォルニア大学バークレー校とスタンフォード大学の大学院生25人の選択に当てはめました。学生は参加の謝礼として25ドルずつ受け取り、賭けと確実にもらえる金額のどちらを取るかを選びました(Journal of Risk and Uncertainty、1992年)。損失の重みを表す推定値の中央値は2.25でした。この集団の選択に合わせたモデルでは、損失が同じ大きさの利益のおよそ2.25倍の重みで扱われていた、ということです。

つまり「2倍」は、ひとつの小さな集団の、ひとつの条件のもとでの中央値です。著者自身も、曲線の形は人によって違うと書いています。しかもこれは学生たちの選択を表すモデルから出た数字です。誰かひとりの、あるいは人間一般の「感じ方」を測ったものではありませんでした。
有名な「2倍」は学生25人の中央値 · 1992年のプロスペクト理論モデルでの損失の重み。バークレー校とスタンフォード大学の大学院生25人の中央値 · 2.25 · 損失は同じ額の利益の約2.25倍の重み · 賭けと確実な金額の選択に当てはめた値で、気持ちを測ったものではない。著者は人によって違うと記している。
1992年のプロスペクト理論モデルでの損失の重み。バークレー校とスタンフォード大学の大学院生25人の中央値

有名な損得の曲線は、実際に何を示しているのか

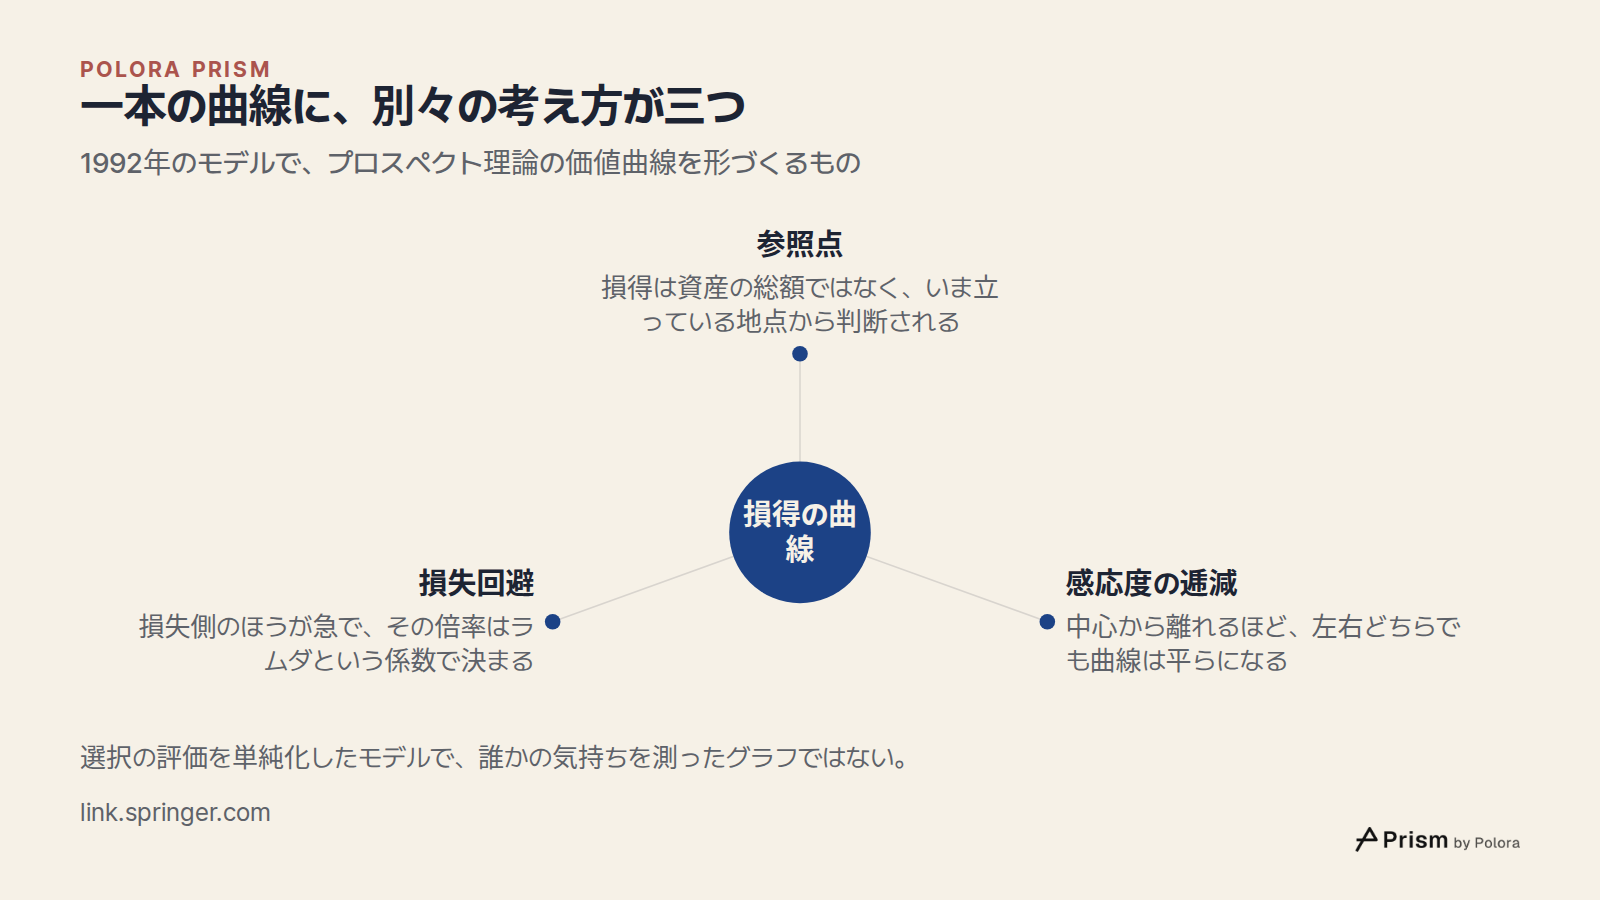
プロスペクト理論はふつう一本の曲線で描かれます。中心点から右が利益、左が損失で、縦軸はその結果をどれだけの価値と見るかを表します。この曲線には別々の考え方が三つ入っていて、混ざりやすいのです。

まず「参照点」です。曲線は資産の総額ではなく、いま自分が立っている地点から始まります。手元に1,000ドルあっても100万ドルあっても、100ドル減れば、出発点や予想していた額から見た「損」として判断されます。

次に「感応度の逓減」、つまり額が大きくなるほど感じ方が鈍くなることです。曲線は中心から離れるほど左右どちらでも平らになります。0ドルから100ドルになる違いは、1,000ドルから1,100ドルになる違いより大きく感じられます。利益でも損失でも同じです。1992年の当てはめでは、この曲がり方は0.88という指数で決まり、左右で同じ値でした。

そして「損失回避」です。見出しの問いに直接かかわるのはこれです。曲線は損失側のほうが利益側より急なので、左へ一歩進んだときに下がる幅は、右へ同じ一歩進んだときに上がる幅より大きくなります。損失側を何倍にするかを決める係数はラムダ(λ)と呼ばれます。1992年のモデルでは、損失は同じ額の利益のラムダ倍の重みで評価されます。ラムダが1なら損も得も同じ重さで、2.25が1992年の中央値です。

この曲線は、こうした係数を入れて選択の評価を単純化したモデルです。誰かの気持ちを測って描いたグラフではありません。
一本の曲線に、別々の考え方が三つ · 1992年のモデルで、プロスペクト理論の価値曲線を形づくるもの · 損得の曲線 · 参照点 · 感応度の逓減 · 損失回避 · 損得は資産の総額ではなく、いま立っている地点から判断される · 中心から離れるほど、左右どちらでも曲線は平らになる · 損失側のほうが急で、その倍率はラムダという係数で決まる · 選択の評価を単純化したモデルで、誰かの気持ちを測ったグラフではない。
1992年のモデルで、プロスペクト理論の価値曲線を形づくるもの

その後の研究で測り直すと、どうなったのか

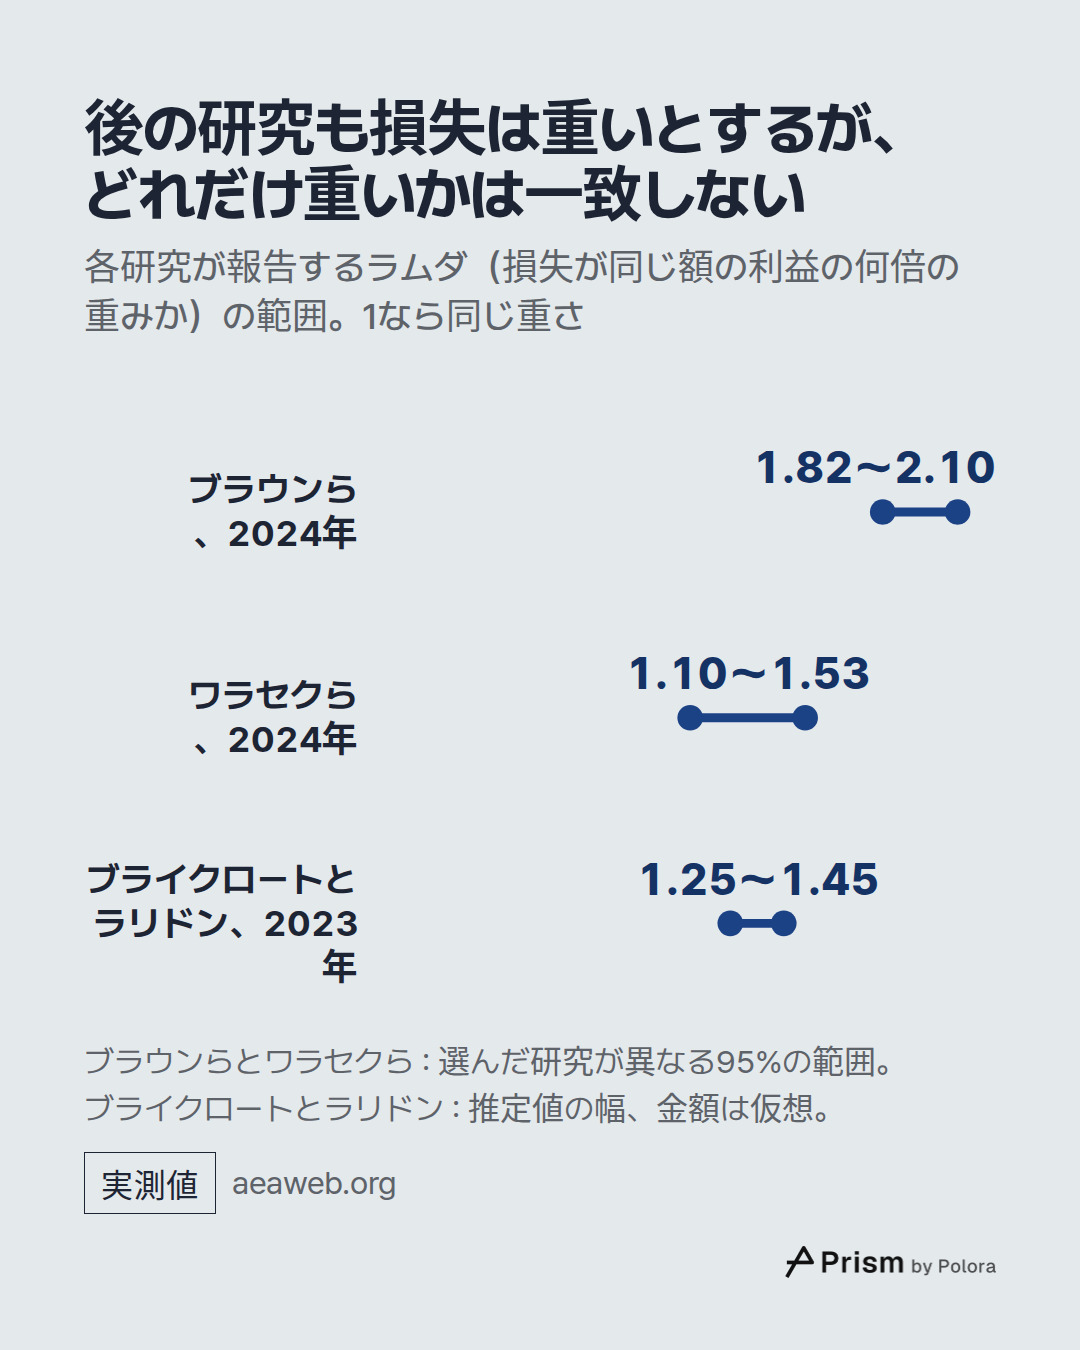
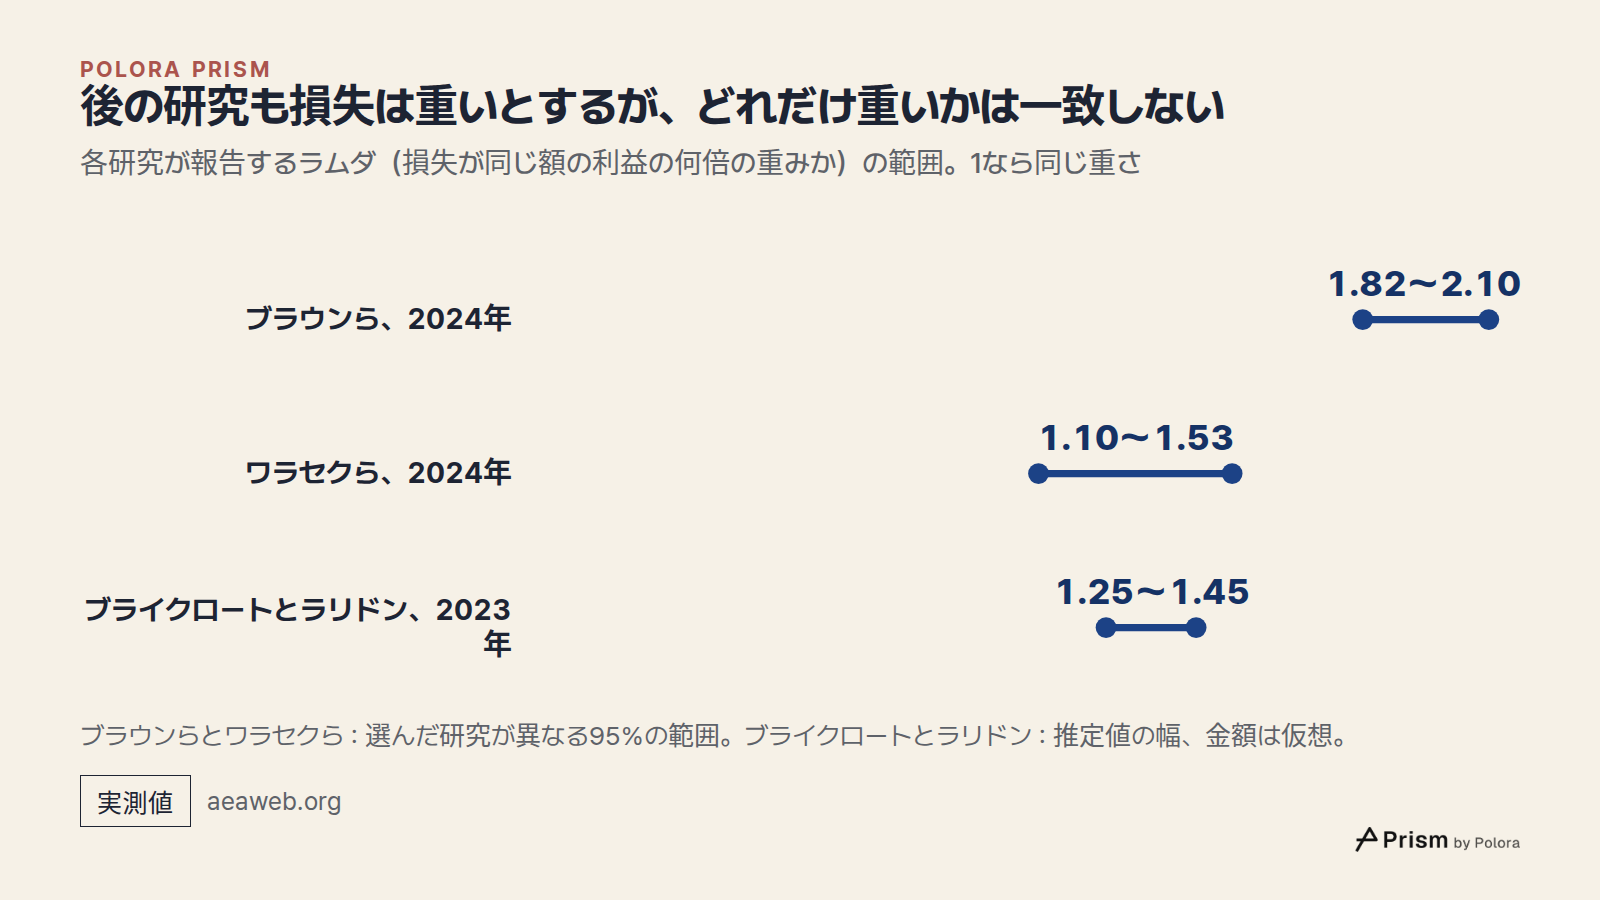
それ以来、何百もの研究がラムダを推定してきました。最大規模の研究のまとめは、アレクサンダー・ブラウン、イマイ・タイスケ、フェルディナンド・ヴィーダー、コリン・カメラーによるものです(Journal of Economic Literature、2024年)。1992年から2017年に出た150本の論文から、607件の推定値を集めました。報告された値をそのまま見ると、中央値は1.69、平均は1.97です。著者たちが統計的な補正をかけた後の中心的な推定値は1.955で、95%の範囲は1.82から2.10でした。また、記録した研究デザインの特徴のうち、結果の違いと結びつくものはほとんど見つかりませんでした。

もっと低い値を出したまとめもあります。ルカシュ・ワラセク、ティモシー・マレット、ニール・スチュワート(Journal of Economic Psychology、2024年)は、賭けを扱った17件の研究の生の選択データからラムダを推定し直し、1.31を得ました。95%の範囲は1.10から1.53で、2.25には届きません。この研究群のデータの多くは質が低いとも指摘しています。マイケル・ノイマンとウルフ・ベッケンホルト(Journal of Retailing、2014年)は消費者がブランドを選ぶ場面を調べ、モデルによって1.49か1.73という値を得ました。ハン・ブライクロートとオリヴィエ・ラリドン(Judgment and Decision Making、2023年)は、損失回避と曲線の平らになり方を切り分けるよう設計した方法で、少額でも高額でも損失回避を確認しました。ラムダは1.25から1.45で、ふだん観測されるより小さいと述べています。ただし金額は仮想のものでした。

これらは、人間に共通するひとつの定数を何度も測ったものではありません。それぞれ違う研究を選び、違う方法で組み立てた分析です。損失のほうが重いのかと問えば、これらの研究はたいてい「はい」と答えます。どれだけ重いのかと問うと、答えは約2から約1.3まで分かれます。
後の研究も損失は重いとするが、どれだけ重いかは一致しない · 各研究が報告するラムダ(損失が同じ額の利益の何倍の重みか)の範囲。1なら同じ重さ · ブラウンら、2024年 · ワラセクら、2024年 · ブライクロートとラリドン、2023年 · 1.82〜2.10 · 1.10〜1.53 · 1.25〜1.45 · ブラウンらとワラセクら : 選んだ研究が異なる95%の範囲。ブライクロートとラリドン : 推定値の幅、金額は仮想。
各研究が報告するラムダ(損失が同じ額の利益の何倍の重みか)の範囲。1なら同じ重さ

なぜテストの組み方で答えが変わるのか

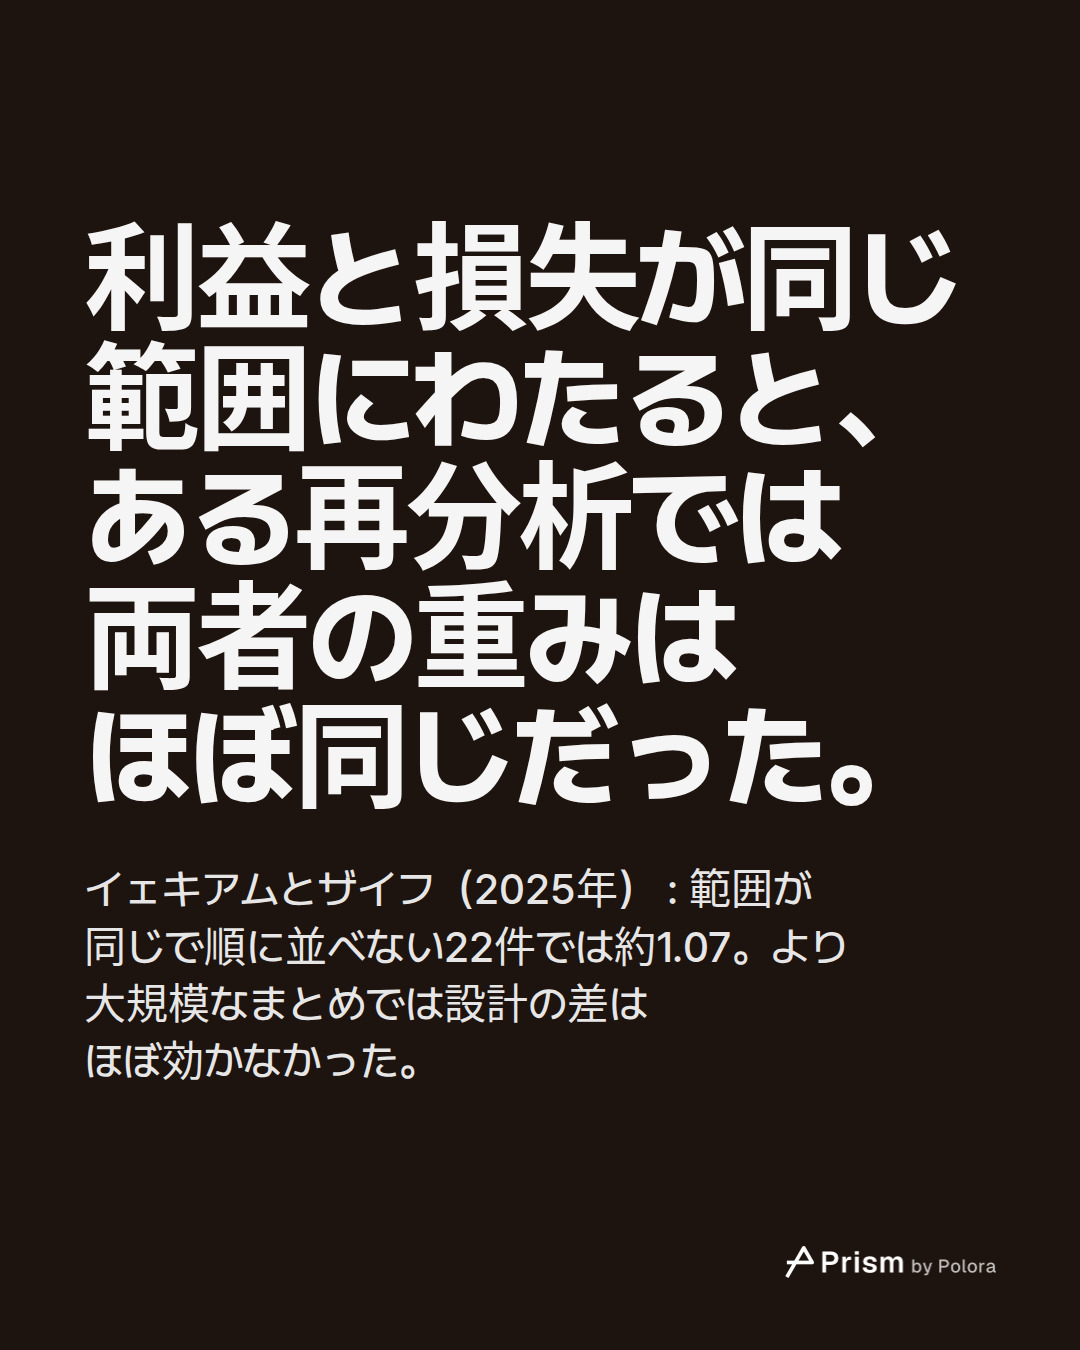
エルダド・イェキアムとダナ・ザイフ(Journal of Economic Psychology、2025年)は、ブラウンらのデータに戻り、研究を設計ごとに分けました。分類できたのは84本の論文の163件の推定値です。損失回避が強く見えるところでは、ふたつの特徴が繰り返し現れました。起こりうる損失が起こりうる利益より小さく設定されていたか、金額が大きさの順に並べて示されていたかです。利益と損失が同じ範囲にわたり、順番に並べられていなかった22件では、ラムダは約1.07、範囲は0.97から1.18で、1を有意に上回りませんでした。また、仮想のお金より本物のお金のほうが推定値は低めでした。論文の題名「損失回避は頑健ではない」が、著者たちの読み方をそのまま表しています。この値はふたりが選んだ一部の研究についてのものです。大きな推定値がどこまで一般的かに疑問を投げかけますが、大きな推定値そのものを否定するわけではありません。ブラウンらは記録した設計の特徴がほとんど効かないとし、イェキアムとザイフは効く設計の違いを見つけたので、この点でふたつのまとめは食い違っています。

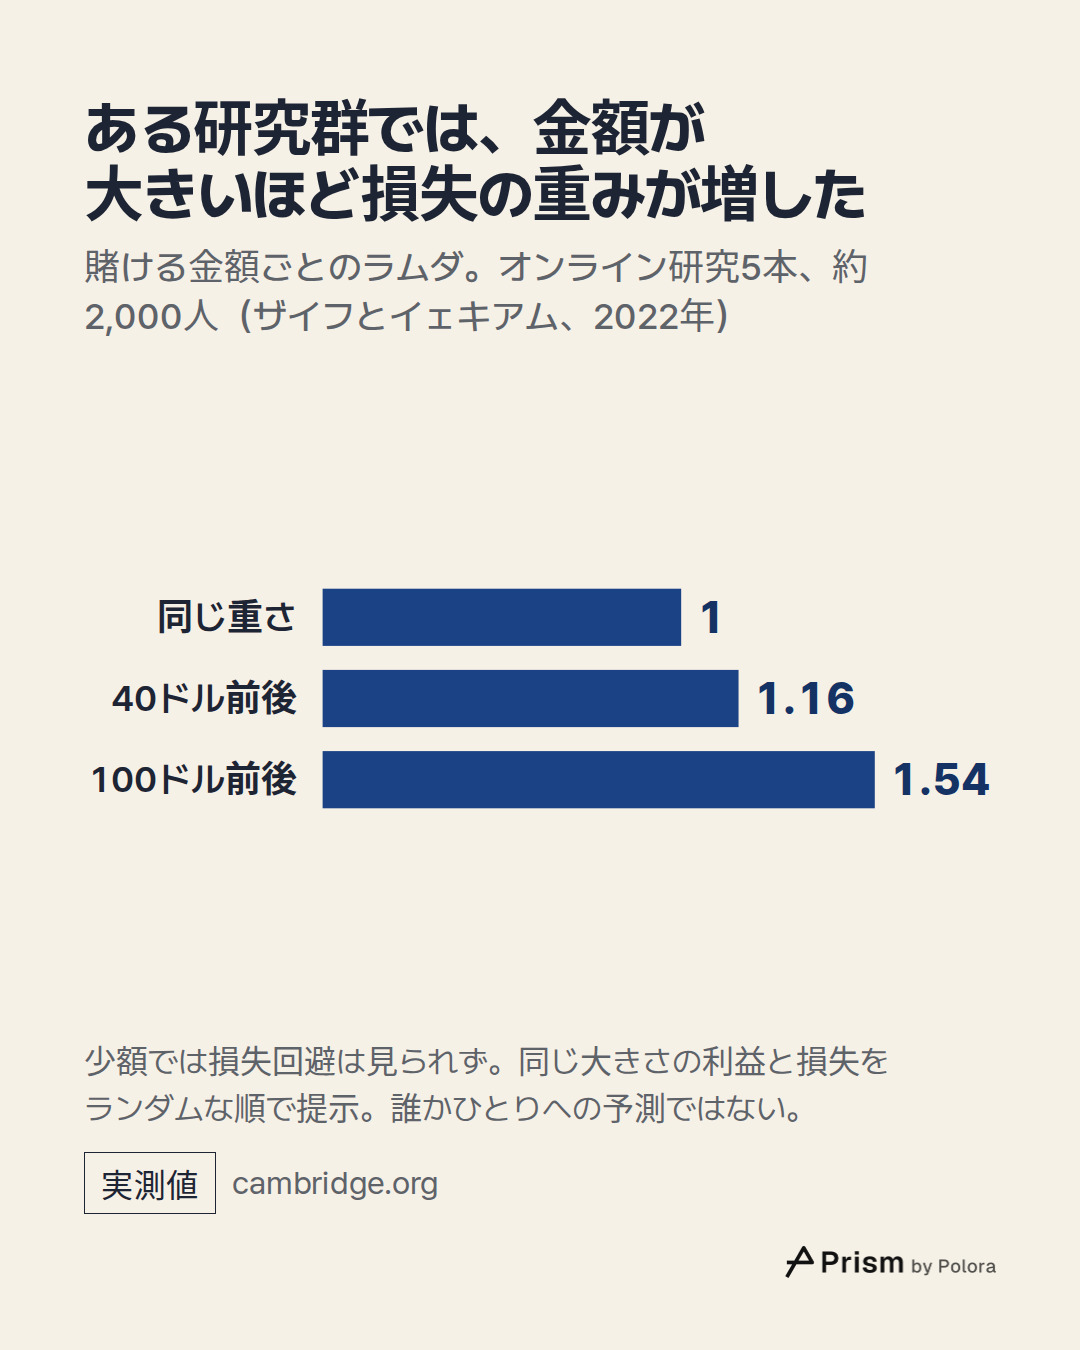
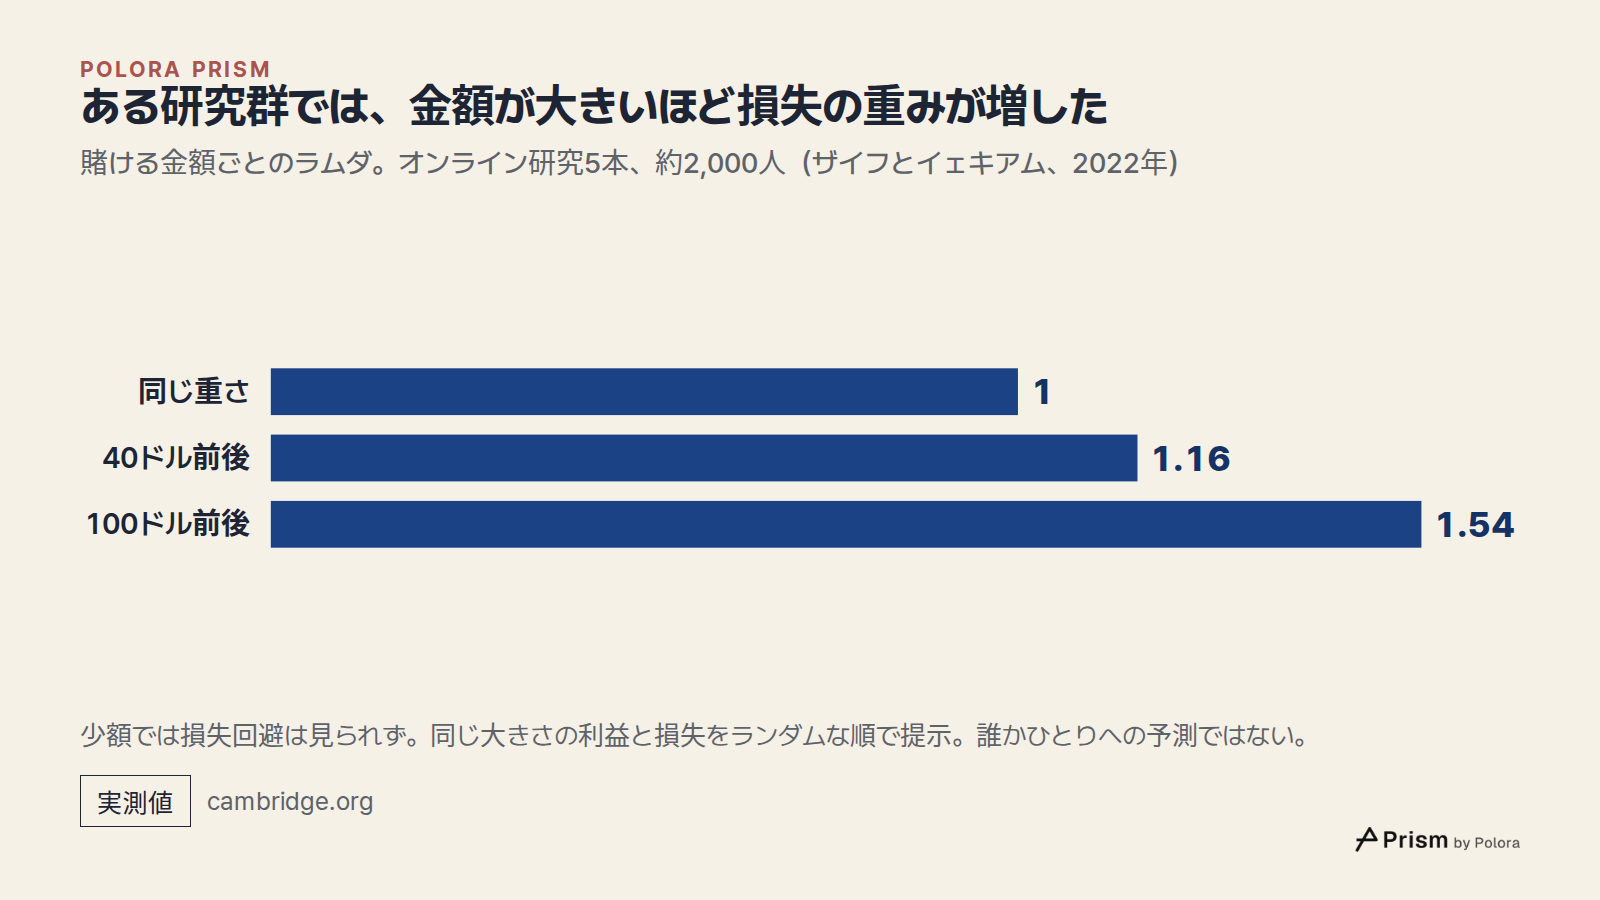
金額の大きさは、冒頭の100ドルにも関わります。それより前、ザイフとイェキアム(Judgment and Decision Making、2022年)は約2,000人を対象にしたオンライン研究を5本行い、同じ大きさの利益と損失をランダムな順で示しました。少額では損失回避は見られず、40ドル前後ではラムダは1.16と弱く、100ドル前後では1.54でした。これはこの研究の方法のもとでの数字で、誰かの100ドルについての予測ではありません。

選ぶことと感じることの間にも、ずれがあります。こうした数字のほとんどは人がした選択から出たもので、後で何を感じたかから出たものではありません。デボラ・カーマーらの賭けを使ったふたつの研究(Psychological Science、2006年)では、人は負けの痛みが同じ額の勝ちの喜びより大きいだろうと予想しましたが、実際に賭けてみると、負けの痛みは予想より小さいものでした。これはその研究での予想と経験のずれを示すもので、本当の損失が同じ額の得より辛く感じられることは決してない、と示したわけではありません。

研究者の間でも、証拠の読み方は分かれています。デイヴィッド・ガルとデレク・ラッカー(Journal of Consumer Psychology、2018年)は、新しい推定ではなく総説として、損失が利益より大きく感じられるのは一般原則ではなく文脈しだいだと論じました。同じ号でイタマール・シモンソンとラン・キヴェッツは、その結論は言い過ぎだと反論しています。問いはまだ決着しておらず、どちらの側にも慎重な研究者がいます。
ある研究群では、金額が大きいほど損失の重みが増した · 賭ける金額ごとのラムダ。オンライン研究5本、約2,000人(ザイフとイェキアム、2022年) · 同じ重さ · 40ドル前後 · 100ドル前後 · 1 · 1.16 · 1.54 · 少額では損失回避は見られず。同じ大きさの利益と損失をランダムな順で提示。誰かひとりへの予測ではない。
賭ける金額ごとのラムダ。オンライン研究5本、約2,000人(ザイフとイェキアム、2022年)

この曲線は、自分が持っている株とどう関係するのか

投資家にとって、参照点はたいてい買った値段です。50ドルで買った株がいま40ドルなら、10ドルの損に感じられます。けれども市場の価格は、いくらで買ったかに関係なく、持っている人全員に同じです。

ここではラムダより、損失側の曲がり方のほうが効いてきます。損失が大きくなるほど曲線は平らになるので、モデルは、損に直面した人は確実な損を受け入れるより賭けに出ると予測します。1979年の論文では、回答者の80%が「80%の確率で4,000ドル」より「確実に3,000ドル」を選びましたが、同じ選択を損失の形で示すと、92%が賭けを選びました。

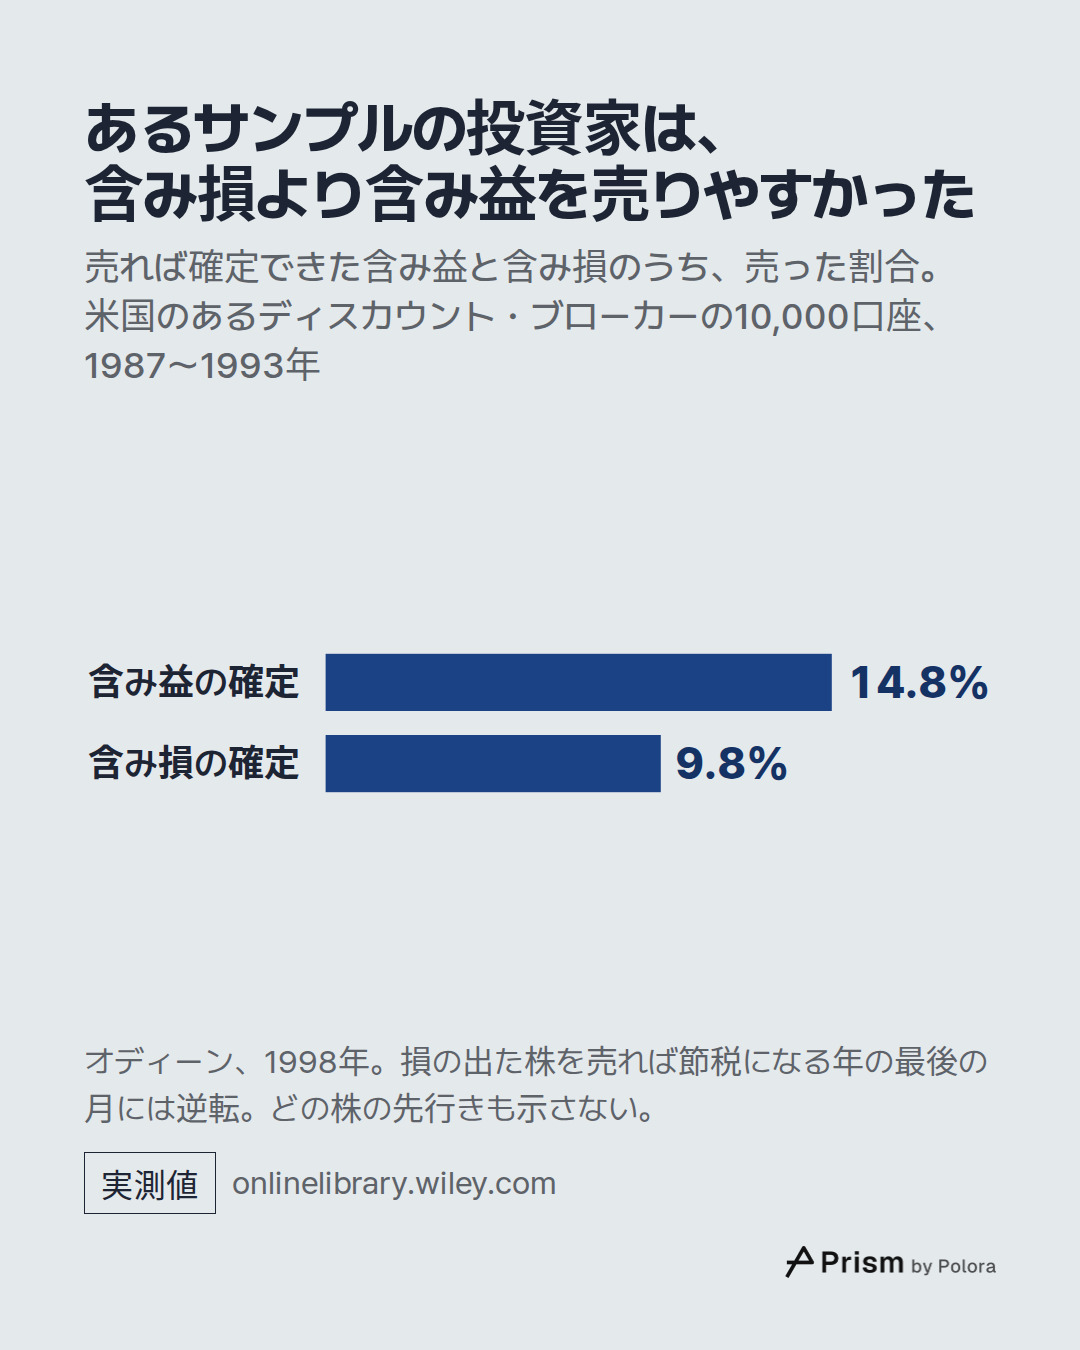
ハーシュ・シェフリンとメイア・スタットマン(Journal of Finance、1985年)は、投資に見られる関連した傾向に名前をつけました。値上がりした株を早く売りすぎ、値下がりした株を長く持ちすぎる「ディスポジション効果(気質効果)」です。ふたりはこれを一本の曲線ではなく、心の中でお金を勘定ごとに分ける「心の会計」、後悔、税金など、いくつかの要因を合わせて説明しました。その後テランス・オディーン(Journal of Finance、1998年)が、米国の大手ディスカウント・ブローカー(手数料の安い証券会社)で無作為に選んだ10,000口座の、1987年から1993年までの売買でこれを検証しました。この投資家たちは、売れば確定できた含み益のうち14.8%を売って確定させた一方、含み損は9.8%しか確定させていませんでした。損の出た株を売れば節税になる年の最後の月には、この傾向が逆になりました。このサンプルでは、売った値上がり株が、持ち続けた値下がり株をその後の一年間のリターンで3.4ポイント上回りました。これはその口座のその期間についての発見で、どの株がこの先どうなるかも、誰がいつ売るべきかも語っていません。

曲線からこの行動へのつながりは、見かけほど直接的ではありません。ニコラス・バーベリスとウェイ・シオン(Journal of Finance、2009年)がプロスペクト理論の単純な形を検討したところ、年単位の損益をもとにした形ではディスポジション効果を予測できないことが多く、逆の結果を予測することさえありました。一方、実際に売って確定した損益をもとにした形では、より確かに予測できました。
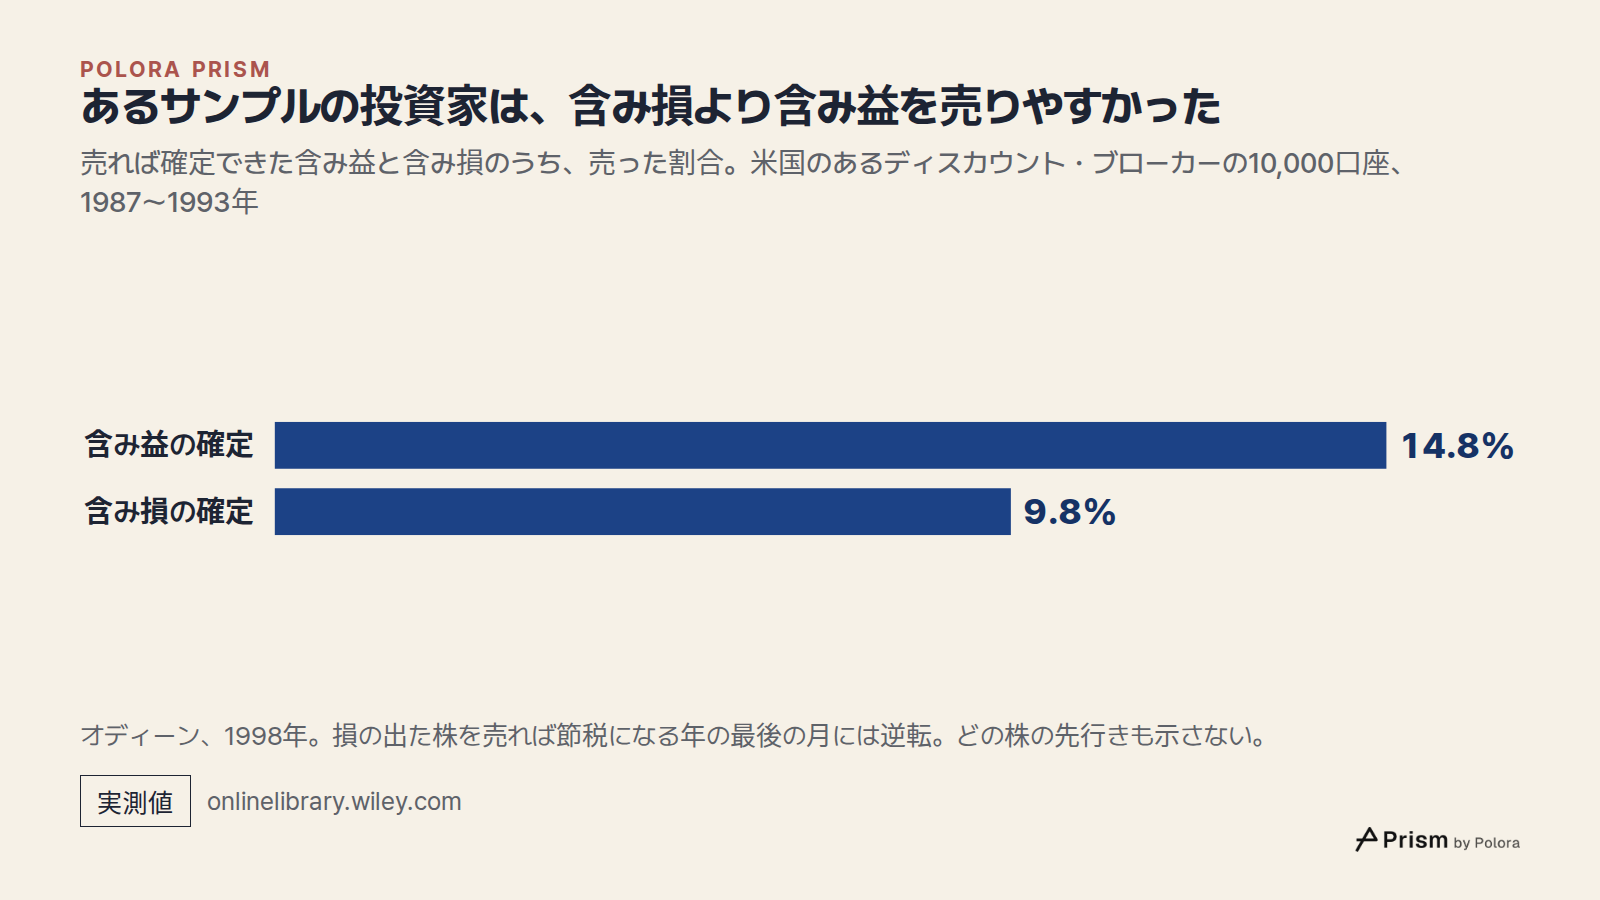
あるサンプルの投資家は、含み損より含み益を売りやすかった · 売れば確定できた含み益と含み損のうち、売った割合。米国のあるディスカウント・ブローカーの10,000口座、1987〜1993年 · 含み益の確定 · 含み損の確定 · 14.8% · 9.8% · オディーン、1998年。損の出た株を売れば節税になる年の最後の月には逆転。どの株の先行きも示さない。
売れば確定できた含み益と含み損のうち、売った割合。米国のあるディスカウント・ブローカーの10,000口座、1987〜1993年

結局、損は本当に大きく痛むのか

多くの実験で、人の選択は同じ額の利益より損失を重く扱います。この傾向は何度も確かめられてきました。定まらないのは、その大きさです。よく聞く「2倍」は1992年の学生25人から来ています。その後の研究のまとめは、それぞれ違う研究を選んだうえで、約2、約1.3、あるいは1に近い値を出しています。損失が利益より小さく設定されていたか、選択肢がどう並べられていたか、お金が本物だったか、金額がどれほどだったかによって変わるのです。

これらの数字が表すのは選択です。損が実際に起きた後にどう感じるかを測った例はずっと少なく、賭けを使ったある一組の研究では、人が予想していたほど痛くありませんでした。

だから覚えておきたい一文はこうです。実験室では損失はたいてい利益より重く扱われるが、どれだけ重いかは人だけでなくテストの組み方にも左右される。次に「2倍」という数字を見かけたら、役に立つ問いは、それがどう測られたのか、そして測ったのは選択なのか気持ちなのか、です。
「損は得の2倍つらい」は本当? 損失回避の数字の出どころ100ドル失う痛みが、100ドル得る喜びより大きいのはなぜ?実験室の選択では、損失はたいてい同じ額の利益より重く扱われる。ただ、どれだけ重いかは定まらない。 · 有名な「2倍」は1992年の学生25人から。その後の推定は約2から約1まで幅がある。2.25 · 損失は同じ額の利益の約2.25倍の重み · 有名な「2倍」は学生25人の中央値 · 1992年のプロスペクト理論モデルでの損失の重み。バークレー校とスタンフォード大学の大学院生25人の中央値 · 賭けと確実な金額の選択に当てはめた値で、気持ちを測ったものではない。著者は人によって違うと記している。ブラウンら、2024年 · ワラセクら、2024年 · ブライクロートとラリドン、2023年 · 1.82〜2.10 · 1.10〜1.53 · 1.25〜1.45 · 後の研究も損失は重いとするが、どれだけ重いかは一致しない · 各研究が報告するラムダ(損失が同じ額の利益の何倍の重みか)の範囲。1なら同じ重さ · ブラウンらとワラセクら : 選んだ研究が異なる95%の範囲。ブライクロートとラリドン : 推定値の幅、金額は仮想。利益と損失が同じ範囲にわたると、ある再分析では両者の重みはほぼ同じだった。 · イェキアムとザイフ(2025年) : 範囲が同じで順に並べない22件では約1.07。より大規模なまとめでは設計の差はほぼ効かなかった。同じ重さ · 40ドル前後 · 100ドル前後 · 1 · 1.16 · 1.54 · ある研究群では、金額が大きいほど損失の重みが増した · 賭ける金額ごとのラムダ。オンライン研究5本、約2,000人(ザイフとイェキアム、2022年) · 少額では損失回避は見られず。同じ大きさの利益と損失をランダムな順で提示。誰かひとりへの予測ではない。含み益の確定 · 含み損の確定 · 14.8% · 9.8% · あるサンプルの投資家は、含み損より含み益を売りやすかった · 売れば確定できた含み益と含み損のうち、売った割合。米国のあるディスカウント・ブローカーの10,000口座、1987〜1993年 · オディーン、1998年。損の出た株を売れば節税になる年の最後の月には逆転。どの株の先行きも示さない。出典 24 : ideas.repec.org · Kahneman and Tversky (1979), Prospect theory : an analysis of decision under risk, Econometrica, ucl.ac.uk · Kahneman and Tversky (1979), Prospect theory, full text, link.springer.com · Tversky and Kahneman (1992), Advances in prospect theory, Journal of Risk and Uncertaint全文はこちら · polora.ai

Why does losing $100 hurt more than winning $100 feels good?

Alpha · deepseek-v4-pro

The honest answer is threefold: losses usually do outweigh gains in people's choices, but modestly and conditionally — and part of why a $100 loss feels bigger is that you predict it will hurt more than it actually does. The standard explanation is prospect theory (Kahneman & Tversky, 1979, 1992), and its core mechanism is worth getting right. People don't evaluate money by their total wealth. They evaluate changes from a reference point — where they started or what they expected. So the same $100 isn't one event with two signs; it's two different events. Losing $100 takes something already counted as yours, while winning $100 adds something you didn't have. In that frame, value attaches to the change, not the level. And the value function is steeper on the loss side than the gain side: the same step left drops you further than the same step right lifts you. That steepness ratio is called lambda (λ), and it's how the field measures loss aversion. Here's what usually gets left out. The famous number — "a loss hurts about twice as much as a gain pleases" — is the *median* λ of 2.25 from a 1992 study of 25 graduate students choosing among hypothetical gambles. A median only exists b…

Beta · gpt-6-sol

The best-supported answer is about how people evaluate a choice, not a universal rule about how intensely they feel. Prospect theory models outcomes relative to a reference point—what you have or expected to have. On its familiar graph, gains extend right, losses left, and the loss side falls more sharply than the gain side rises. Both sides also flatten farther from that point: *diminishing sensitivity* shapes the curve, while *loss aversion* is the unequal weighting of equal-sized gains and losses. The graph is a model of valuation, not a recording of anyone’s emotions. Kahneman and Tversky’s 1979 paper is available at https://www.ucl.ac.uk/anaesthesia/sites/anaesthesia/files/kahneman-tversky.pdf. (ucl.ac.uk) What I would change in the manuscript and Alpha’s answer: - The 1992 paper supports 25 graduate students, a $25 participation payment, a median loss-aversion parameter λ = 2.25, and a median curvature exponent of 0.88 on each side. It also explicitly notes noisy choices and individual differences. But its description of that particular experiment does…

Gamma · gemini-3.1-pro

Here is what the record and my own checks show regarding the manuscript's claims, following the editor’s brief: Verification of the Manuscript's Claims & Requested Checks: * 1992 Study Details (Tversky & Kahneman): The 25 graduate students and the $25 flat fee are confirmed. As Beta noted, the paper does not explicitly label the gamble outcomes as "hypothetical" in a way that proves no real money changed hands beyond the fee, but they are widely understood as such in the literature. The authors explicitly note that parameters like lambda vary across individuals. (Source: *Journal of Risk and Uncertainty*, 1992; https://psych.fullerton.edu/mbirnbaum/teaching/psych466/articles/Tversky_Kahneman_JRU_92.pdf) * Brown, Imai, Vieider & Camerer (2024): The figures are confirmed. The meta-analysis reports a raw median of 1.69, a raw mean of 1.97, and an adjusted estimate of 1.955 with a 95% interval of 1.82 to 2.10. It also notes that few design features significantly correlate with the estimates. (Source: *Journal of Economic Literature*; https://topcat.aeaweb.org/articles?id=10.1257%2Fjel.20221698) * Neumann & Böckenholt (2014): Confirmed. My search verifies that th…

Researcher · gpt-6-luna

Research check The strongest correction to the answers so far is about feeling versus choosing. Most loss-aversion estimates describe choices, not the intensity of a person’s experienced emotion. Kermer and colleagues’ two gambling studies found that participants expected losses to affect them more than equal gains, but actual losses had less emotional impact than they had predicted. That supports distinguishing anticipated hurt from experienced hurt; it does not establish that every loss feels no worse than an equal gain. Source: https://journals.sagepub.com/doi/10.1111/j.1467-9280.2006.01760.x (journals.sagepub.com) Other key checks: - The 1992 estimate: Tversky and Kahneman’s paper introduced cumulative prospect theory and discusses diminishing sensitivity and loss aversion. A later authoritative summary gives the fitted parameters as α = 0.88 and λ = 2.25. But describing 2.25 as “the middle person’s” measured feeling would be too strong: λ is a fitted choice-model parameter, not an individual emotion measurement. The material retrieved this turn did not let me verify that…

The Arbiter · gpt-6-sol

The voices agree on an important distinction: the familiar “twice as much” number describes a model fitted to choices, not a direct measurement of how bad a loss feels. Prospect theory’s curve separates a reference point, flattening sensitivity as amounts grow, and greater weight on the loss side. The 1992 paper is the source of the often-quoted λ estimate of 2.25; that parameter should not be presented as a fixed ratio of slopes everywhere on the curve. (psych.fullerton.edu) The real disagreement is how far to take the evidence about *feeling*. Alpha treats overpredicted pain as a central explanation. Beta and the Researcher give it a narrower reading: Kermer and colleagues found a gap between forecast and experience in their gambling studies, but that does not settle what every person feels after losing $100. Gamma’s description of the finding as largely a forecasting error goes further than this evidence warrants. (journals.sagepub.com) For the manuscript, the remaining bound…

The Arbiter's Final Verdict · gpt-6-sol

Verdict The manuscript’s premise stands for choices, but not as a universal claim about feelings. People often give a possible $100 loss more weight than a possible $100 gain. Prospect theory explains this by treating outcomes as changes from a *reference point*—what someone has or expects—rather than simply as changes in total wealth. Its familiar curve also flattens farther from that point on both sides (*diminishing sensitivity*) and gives losses greater weight than equal gains (*loss aversion*). That curve models valuation; it is not a recording of felt pain. Kahneman and Tversky, 1979; Tversky and Kahneman, 1992. Here is what the manuscript can—and cannot—carry: - “Twice as much” has a source, not universal status. The 1992 paper fitted choices by 25 graduate students, paid $25 to participate. Its reported median loss-aversion parameter, λ, was 2.25, with a curvature exponent of 0.88 on both sides. λ scales the loss side of that fitted curve; it is neither a constant ratio of slop…