손실이 이익보다 두 배 아프다는 말, 사실일까?

많은 실험에서 사람들은 같은 크기의 이익보다 손실을 더 무겁게 따져 선택했습니다. 다만 '2배'는 1992년 학생 25명에게서 나온 값이고, 그 뒤의 추정은 약 2에서 1 가까이까지 갈립니다.

2026-11-12

'손실은 두 배 아프다'는 말은 어디서 나왔나

이런 이틀을 떠올려 봅시다. 하루는 뜻밖에 100달러를 줍고, 다른 하루는 100달러를 잃어버립니다. 대부분은 둘째 날이 더 오래 남는다고 말합니다. 흔히 듣는 설명은 여기에 숫자까지 붙입니다. 손실이 주는 아픔이 같은 크기의 이익이 주는 기쁨보다 두 배쯤 크다는 것입니다.

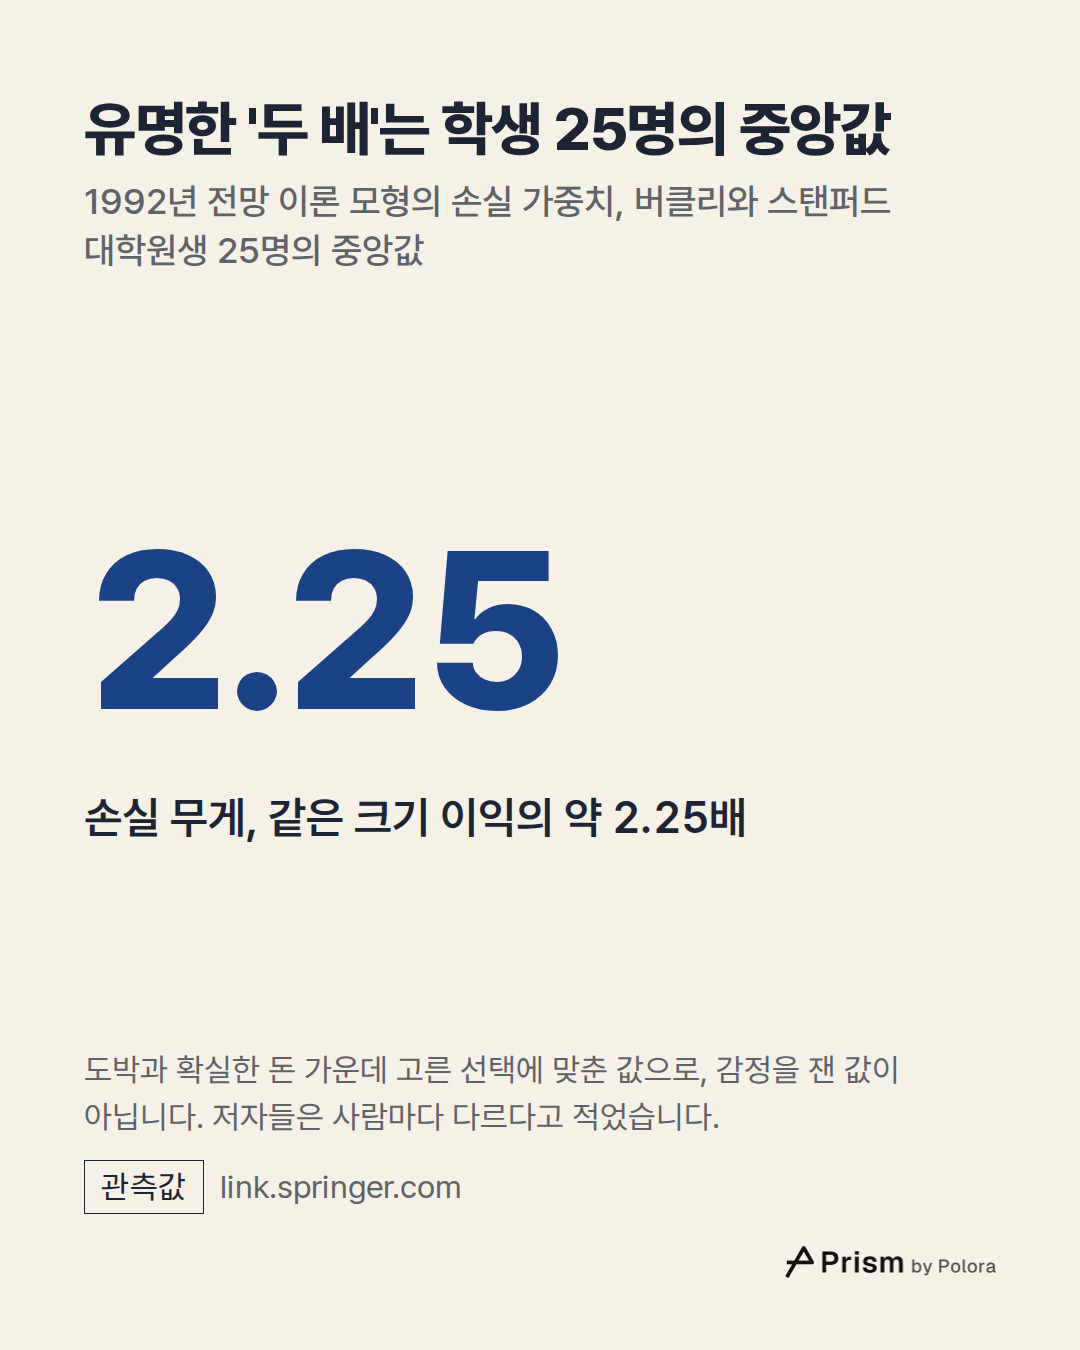
이 숫자에는 출처가 있습니다. 1979년 심리학자 대니얼 카너먼과 아모스 트버스키는 결과가 불확실할 때 사람들이 실제로 어떻게 선택하는지 설명하는 '전망 이론'을 내놓았습니다(학술지 Econometrica, 1979년). 1992년에는 이 이론을 다듬은 뒤, 버클리와 스탠퍼드 대학원생 25명의 선택에 맞춰 보았습니다. 학생들은 참가비로 25달러씩 받고, 도박과 확실한 돈 가운데 하나를 고르는 문제를 풀었습니다(학술지 Journal of Risk and Uncertainty, 1992년). 학생별 추정값의 중앙값은 2.25였습니다. 이 집단의 선택에 맞춘 모형에서 손실이 같은 크기의 이익보다 약 2.25배 무겁게 매겨졌다는 뜻입니다.

그러니 '두 배'는 작은 집단 하나가 한 가지 조건에서 보인 중앙값입니다. 저자들도 이 곡선이 사람마다 다르다고 적었습니다. 게다가 이 값은 학생들의 선택을 설명하는 모형에서 나왔습니다. 개인이든 사람들 전반이든, 실제로 느끼는 아픔을 잰 값은 아니었습니다.
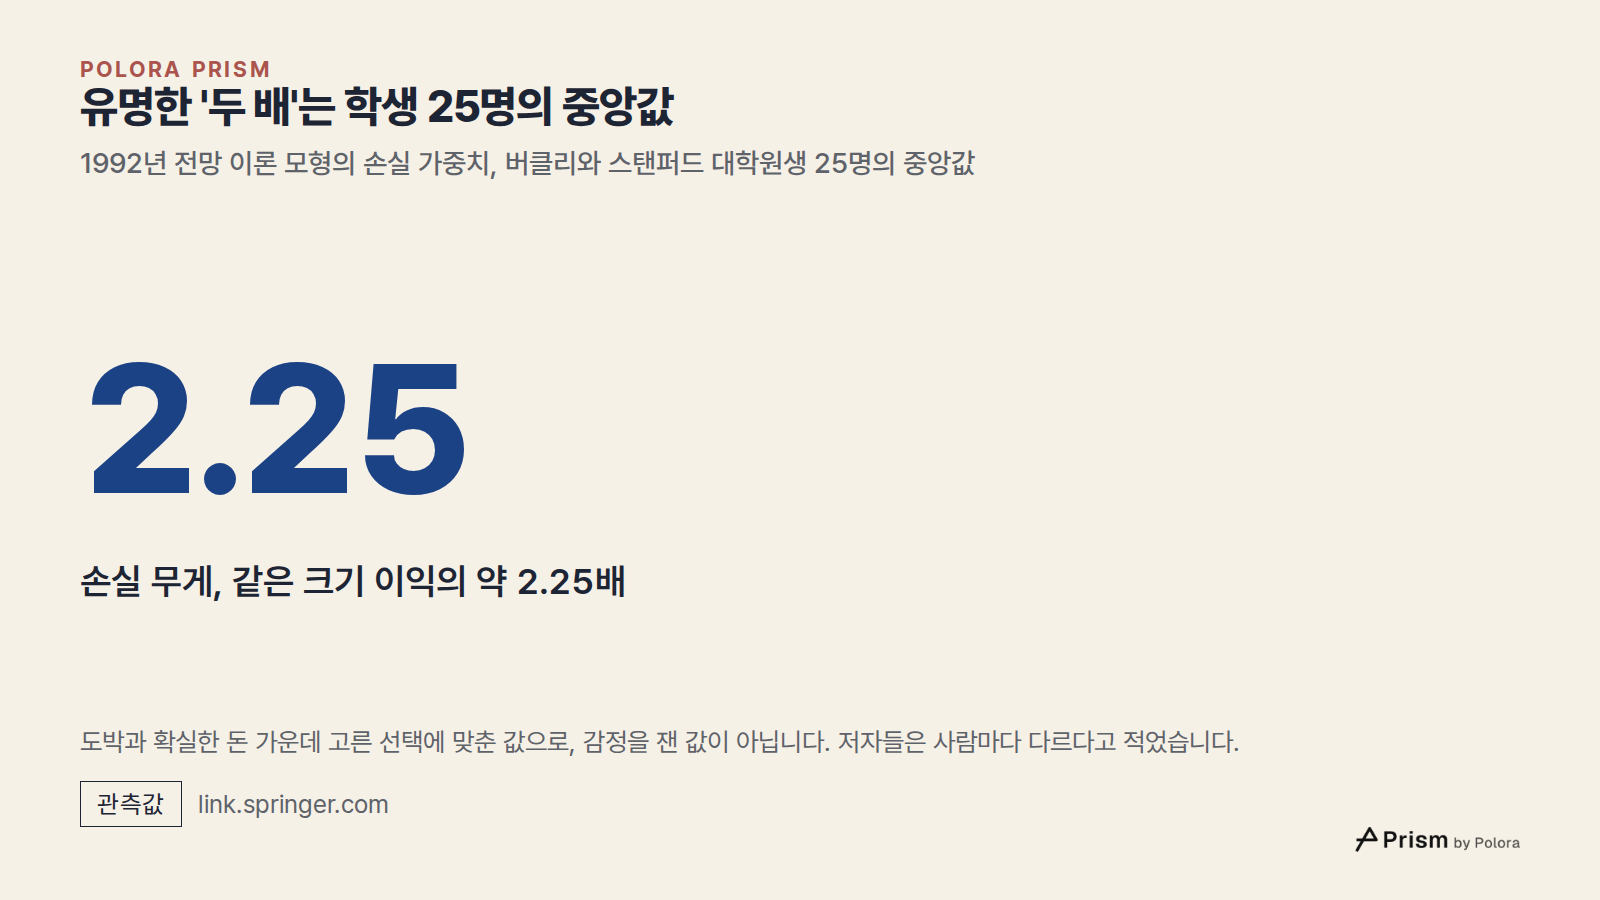
유명한 '두 배'는 학생 25명의 중앙값 · 1992년 전망 이론 모형의 손실 가중치, 버클리와 스탠퍼드 대학원생 25명의 중앙값 · 2.25 · 손실 무게, 같은 크기 이익의 약 2.25배 · 도박과 확실한 돈 가운데 고른 선택에 맞춘 값으로, 감정을 잰 값이 아닙니다. 저자들은 사람마다 다르다고 적었습니다.
1992년 전망 이론 모형의 손실 가중치, 버클리와 스탠퍼드 대학원생 25명의 중앙값

유명한 손실·이익 곡선은 실제로 무엇을 보여 주나

전망 이론은 보통 곡선 하나로 그려집니다. 가운데 점에서 오른쪽은 이익, 왼쪽은 손실이고, 세로축은 그 결과를 얼마나 값지게 여기는지를 나타냅니다. 이 곡선에는 서로 다른 세 가지 생각이 들어 있는데, 한데 섞어 읽기 쉽습니다.

첫째는 기준점입니다. 곡선은 전 재산이 아니라 지금 서 있는 자리에서 시작합니다. 가진 돈이 1,000달러든 100만 달러든, 100달러가 줄면 출발한 자리나 기대했던 자리를 기준으로 손실을 따집니다.

둘째는 민감도 체감입니다. 곡선은 양쪽 모두 가운데에서 멀어질수록 완만해집니다. 0달러에서 100달러가 되는 변화가 1,000달러에서 1,100달러가 되는 변화보다 크게 느껴지고, 이익이든 손실이든 마찬가지입니다. 1992년 모형에서는 이 휘어짐을 지수 0.88로 정했고, 양쪽에 같은 값을 썼습니다.

셋째가 손실 회피이고, 제목의 질문에 대한 답이 여기 있습니다. 손실 쪽이 이익 쪽보다 가파르기 때문에, 왼쪽으로 한 걸음 가면 오른쪽으로 같은 걸음을 갈 때 오르는 것보다 더 많이 떨어집니다. 손실 쪽을 얼마나 키울지 정하는 값을 람다라고 부릅니다. 1992년 모형에서 손실은 같은 크기의 이익이 지닌 가치에 람다를 곱한 만큼으로 매겨집니다. 람다가 1이면 손실과 이익의 무게가 같고, 2.25는 1992년의 중앙값입니다.

이 곡선은 이런 값들을 넣어 선택의 가치를 단순하게 그린 모형입니다. 누군가의 감정을 재서 찍은 그래프가 아닙니다.
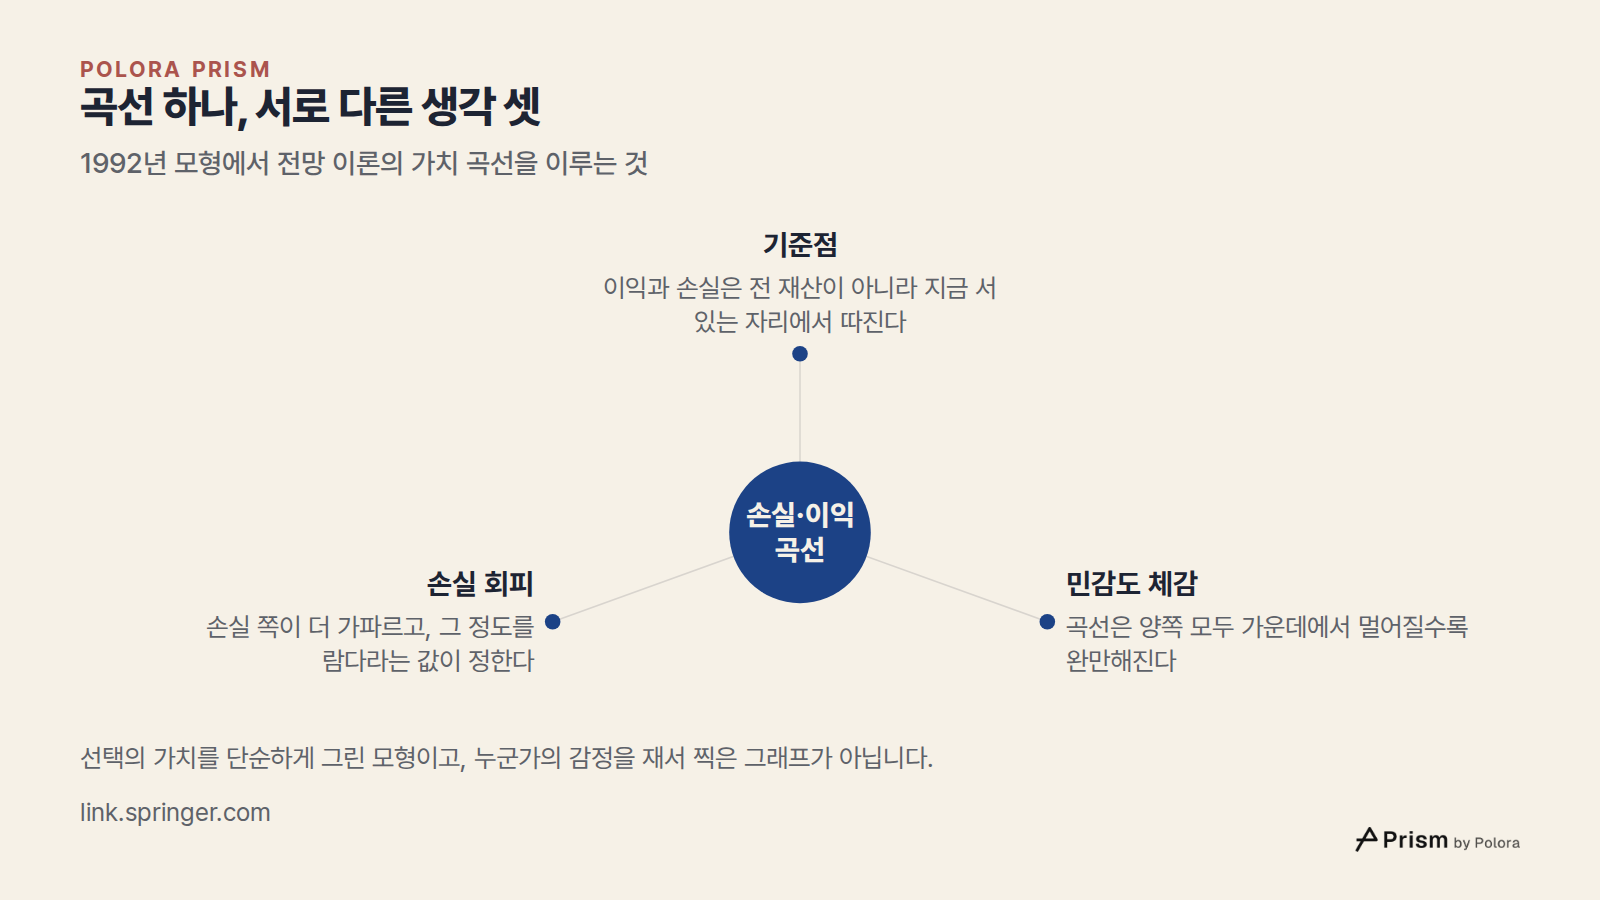
곡선 하나, 서로 다른 생각 셋 · 1992년 모형에서 전망 이론의 가치 곡선을 이루는 것 · 손실·이익 곡선 · 기준점 · 민감도 체감 · 손실 회피 · 이익과 손실은 전 재산이 아니라 지금 서 있는 자리에서 따진다 · 곡선은 양쪽 모두 가운데에서 멀어질수록 완만해진다 · 손실 쪽이 더 가파르고, 그 정도를 람다라는 값이 정한다 · 선택의 가치를 단순하게 그린 모형이고, 누군가의 감정을 재서 찍은 그래프가 아닙니다.
1992년 모형에서 전망 이론의 가치 곡선을 이루는 것

나중에 다시 재 보니 어떻게 나왔나

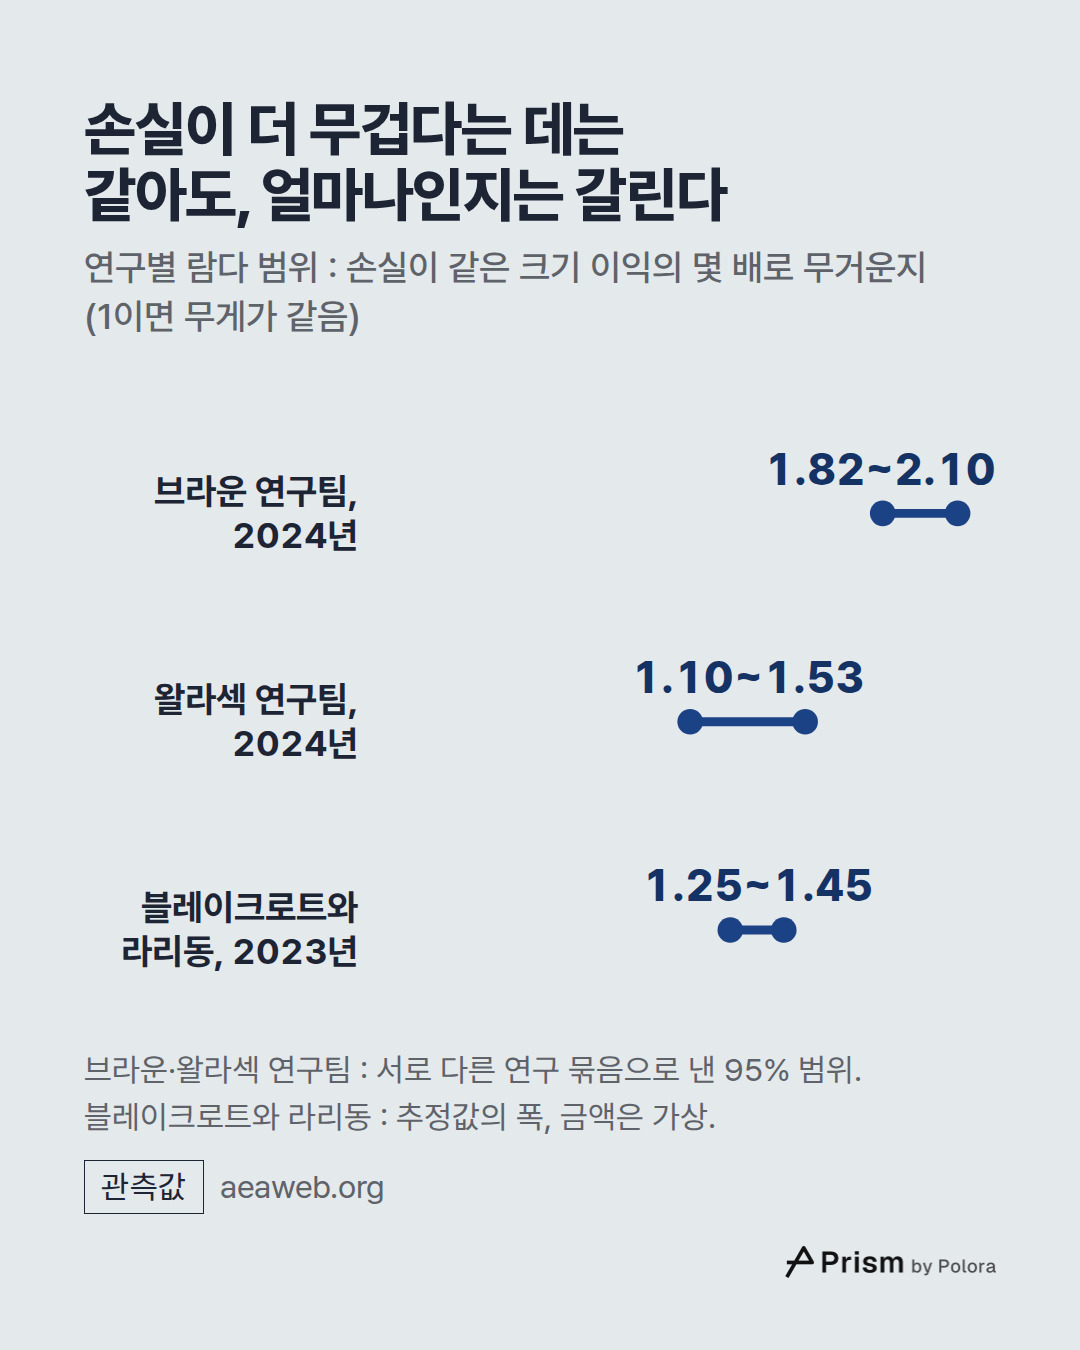
그 뒤 수백 편의 연구가 람다를 추정했습니다. 가장 큰 종합 연구는 알렉산더 브라운, 타이스케 이마이, 페르디난트 피이더, 콜린 캐머러가 낸 것입니다(학술지 Journal of Economic Literature, 2024년). 이들은 1992년부터 2017년까지 나온 논문 150편에서 추정값 607개를 모았습니다. 보고된 그대로 보면 중앙값은 1.69, 평균은 1.97입니다. 저자들이 통계적으로 보정한 중심 추정값은 1.955이고, 95% 범위는 1.82에서 2.10입니다. 이들이 기록한 연구 설계 특징 가운데 결과 차이와 맞물린 것은 많지 않았습니다.

다른 종합 연구들의 값은 더 낮았습니다. 루카스 왈라섹, 티머시 멀렛, 닐 스튜어트는 위험한 도박을 다룬 연구 17편의 원래 선택 자료로 람다를 다시 추정해 1.31을 얻었습니다(학술지 Journal of Economic Psychology, 2024년). 95% 범위는 1.10에서 1.53으로 2.25에 닿지 않습니다. 이들은 이 자료 상당수의 질이 낮다는 점도 짚었습니다. 미하엘 노이만과 울프 뵈켄홀트는 소비자 브랜드 사이의 선택을 살펴, 모형에 따라 1.49 또는 1.73을 얻었습니다(학술지 Journal of Retailing, 2014년). 한 블레이크로트와 올리비에 라리동은 손실 회피를 곡선의 휘어짐과 떼어 보도록 설계한 검사로, 적은 금액과 큰 금액 모두에서 손실 회피를 확인했습니다(학술지 Judgment and Decision Making, 2023년). 람다는 1.25에서 1.45 사이였고, 저자들은 이를 흔히 관찰되는 값보다 작다고 표현했습니다. 이 연구의 금액은 가상이었습니다.

이것들은 고정된 상수 하나를 거듭 잰 결과가 아닙니다. 서로 다른 근거를 골라 서로 다른 방식으로 분석한 결과입니다. 손실이 더 무겁냐고 물으면 이 연구들은 대개 그렇다고 답합니다. 얼마나 더 무겁냐고 물으면 답이 약 2에서 약 1.3까지 갈립니다.
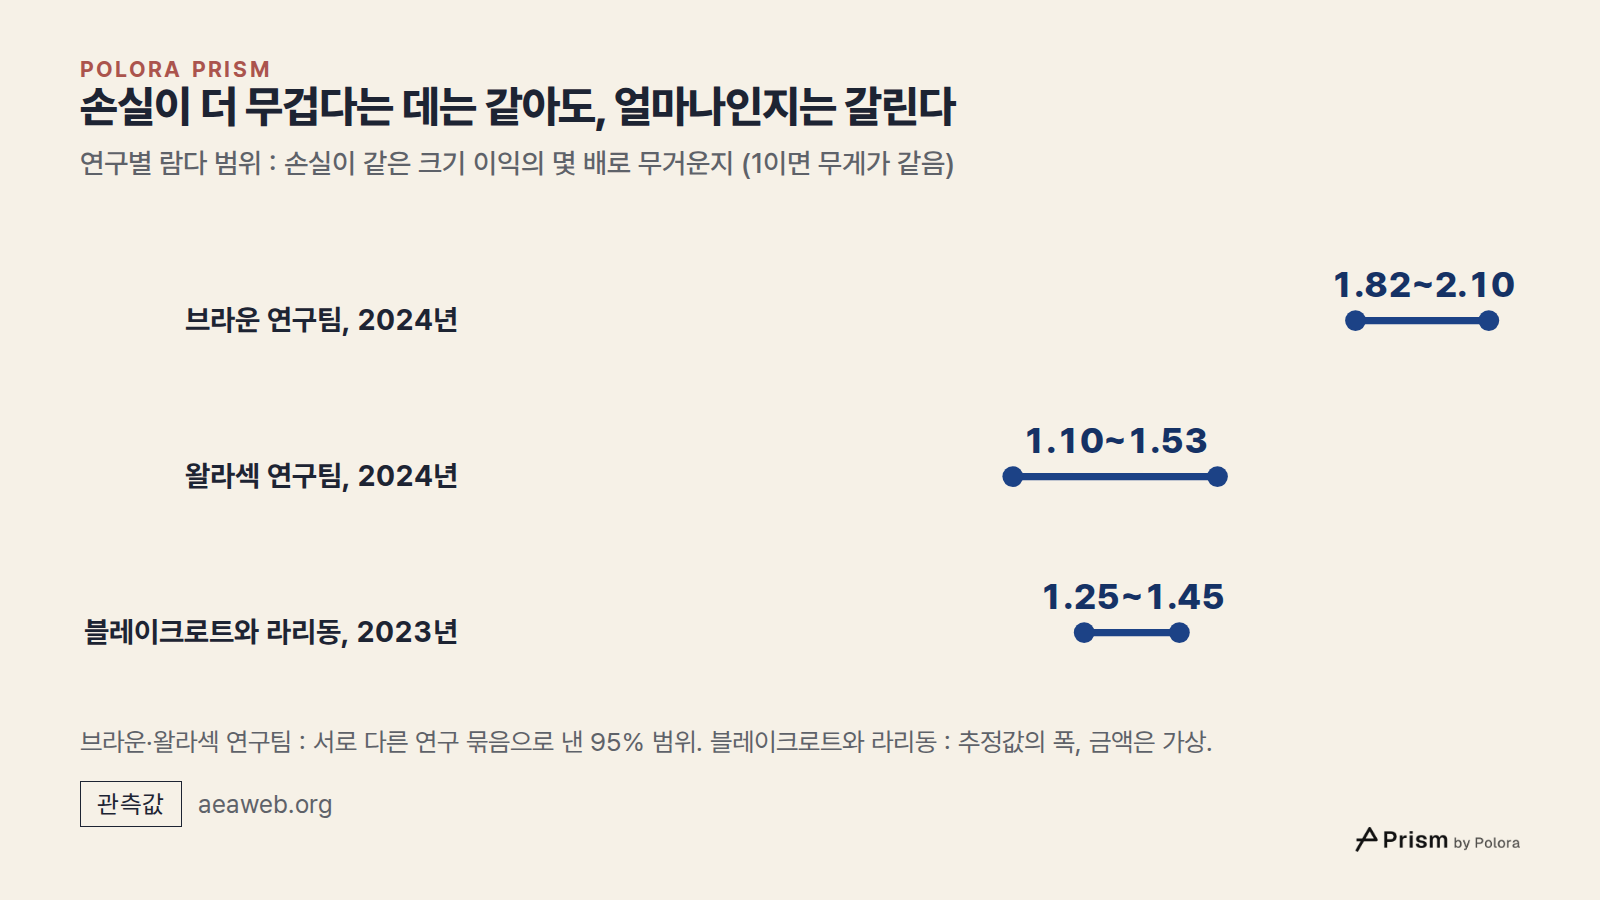
손실이 더 무겁다는 데는 같아도, 얼마나인지는 갈린다 · 연구별 람다 범위 : 손실이 같은 크기 이익의 몇 배로 무거운지 (1이면 무게가 같음) · 브라운 연구팀, 2024년 · 왈라섹 연구팀, 2024년 · 블레이크로트와 라리동, 2023년 · 1.82~2.10 · 1.10~1.53 · 1.25~1.45 · 브라운·왈라섹 연구팀 : 서로 다른 연구 묶음으로 낸 95% 범위. 블레이크로트와 라리동 : 추정값의 폭, 금액은 가상.
연구별 람다 범위 : 손실이 같은 크기 이익의 몇 배로 무거운지 (1이면 무게가 같음)

검사를 어떻게 짜느냐에 따라 왜 답이 달라지나

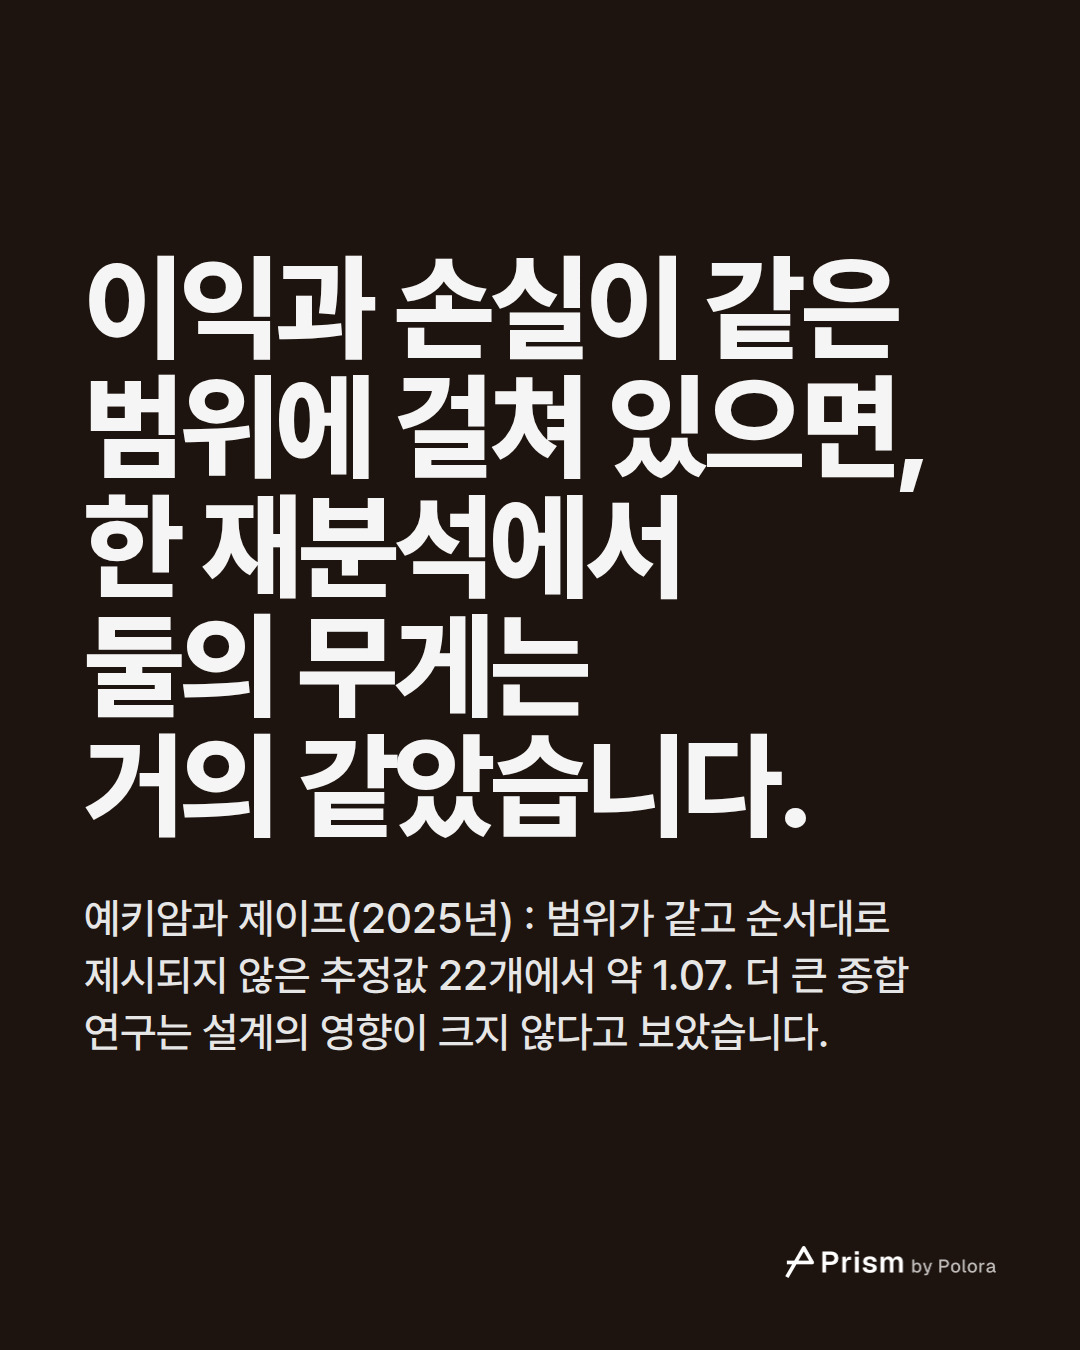
엘다드 예키암과 다나 제이프는 브라운 연구팀의 자료로 돌아가 연구들을 설계별로 나눴습니다(학술지 Journal of Economic Psychology, 2025년). 이렇게 나눌 수 있었던 것은 논문 84편의 추정값 163개였습니다. 손실 회피가 강하게 나온 곳에는 두 가지 특징이 자주 보였습니다. 걸린 손실이 걸린 이익보다 작았거나, 금액이 크기 순서대로 제시되었다는 점입니다. 이익과 손실이 같은 범위에 걸쳐 있고 순서대로 제시되지 않은 추정값 22개에서 람다는 약 1.07, 범위는 0.97에서 1.18로 1보다 유의하게 크지 않았습니다. 진짜 돈을 걸었을 때가 가상의 돈일 때보다 추정값이 낮다는 결과도 얻었습니다. 논문 제목이 곧 이들의 해석입니다. '손실 회피는 견고하지 않다.' 이 수치는 이들이 골라낸 부분 집합에서 성립합니다. 더 큰 추정값들이 얼마나 일반적인지에 의문을 던지지만, 그 값들을 지우지는 않습니다. 브라운 연구팀은 기록된 설계 특징 가운데 결과에 영향을 준 것이 많지 않다고 보았고, 예키암과 제이프는 영향을 준 설계 차이를 찾았습니다. 이 점에서 두 종합 연구는 서로 엇갈립니다.

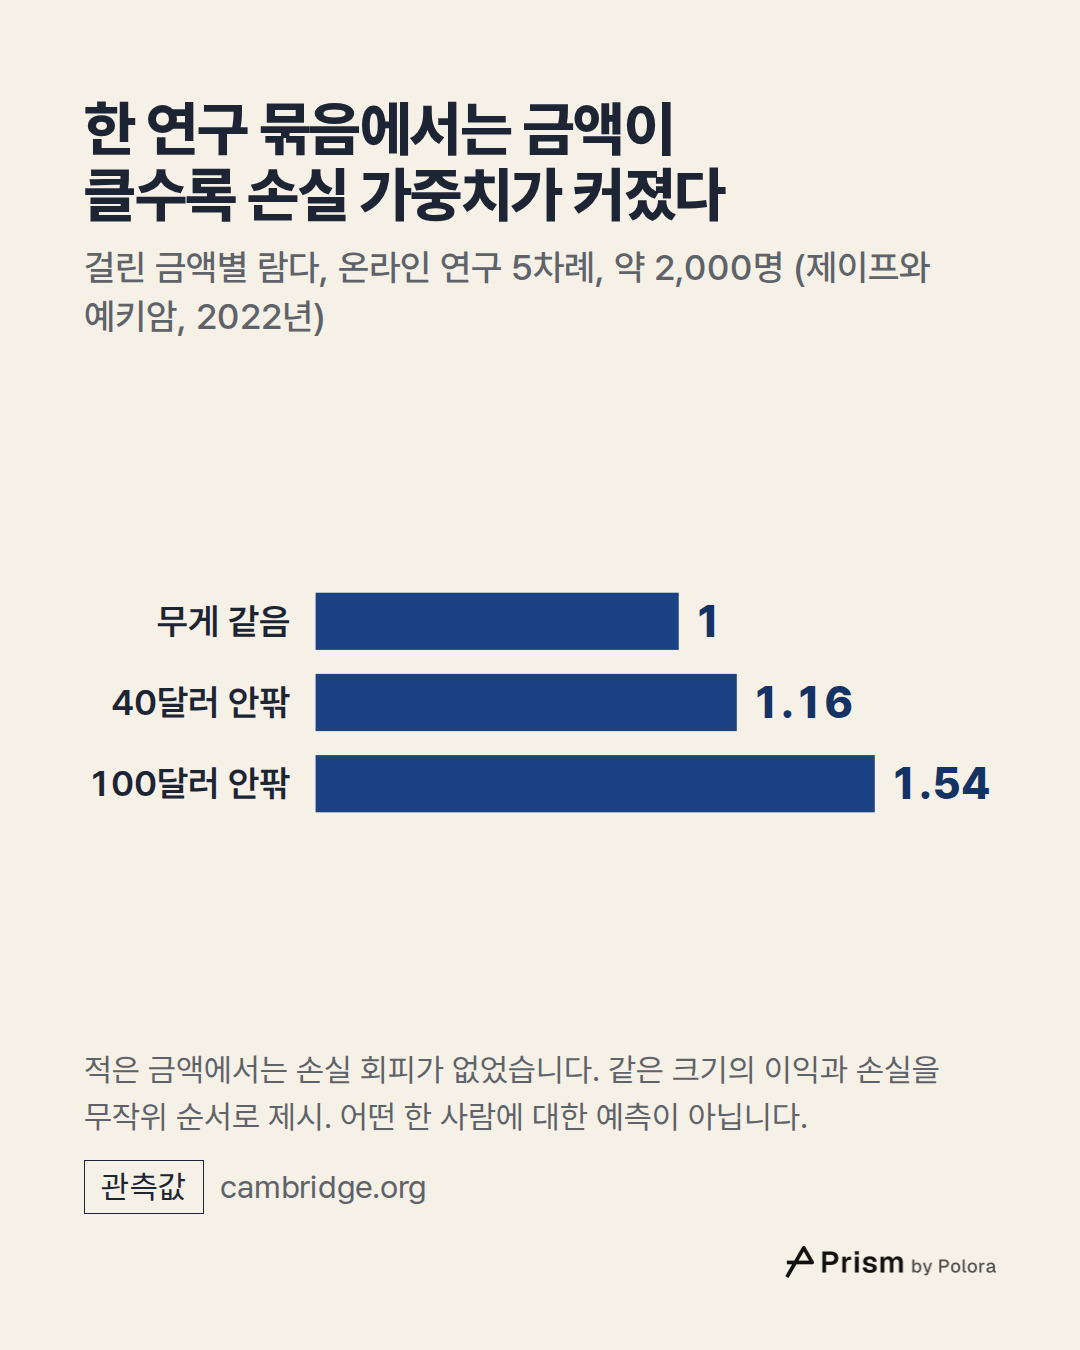
금액의 크기는 첫머리의 100달러와도 직접 관련이 있습니다. 이보다 앞서 제이프와 예키암은 약 2,000명이 참여한 다섯 차례의 온라인 연구에서 같은 크기의 이익과 손실을 무작위 순서로 보여 주었습니다(학술지 Judgment and Decision Making, 2022년). 적은 금액에서는 손실 회피가 나타나지 않았고, 40달러 안팎에서는 람다가 1.16으로 약했으며, 100달러 안팎에서는 1.54였습니다. 이 수치는 그 연구의 방법 아래에서 성립하는 값이고, 어떤 한 사람의 100달러를 두고 하는 예측이 아닙니다.

선택과 감정 사이에도 틈이 있습니다. 이 숫자들 대부분은 사람들이 나중에 느낀 것이 아니라 고른 것에서 나왔습니다. 데버라 커머와 동료들이 두 차례의 도박 연구에서 확인한 바로는, 사람들은 손실이 같은 크기의 이익보다 더 아플 거라고 예상했지만 실제로 도박을 해 보니 손실은 예상보다 덜 아팠습니다(학술지 Psychological Science, 2006년). 그 연구들에서 예상과 경험 사이에 틈이 있었다는 뜻입니다. 실제 손실이 같은 크기의 이익보다 더 나쁘게 느껴지는 일이 없다는 뜻은 아닙니다.

근거를 모두가 같은 식으로 읽지는 않습니다. 데이비드 갈과 데릭 러커는 새로운 추정이 아닌 검토 논문에서, 손실이 이익보다 크게 다가오는 것은 일반 법칙이 아니라 맥락에 달린 일이라고 주장했습니다(학술지 Journal of Consumer Psychology, 2018년). 같은 호에서 이타마르 시몬슨과 란 키베츠는 그 결론이 지나치다고 반박했습니다. 이 질문은 아직 열려 있고, 양쪽 모두에 신중한 연구자들이 있습니다.
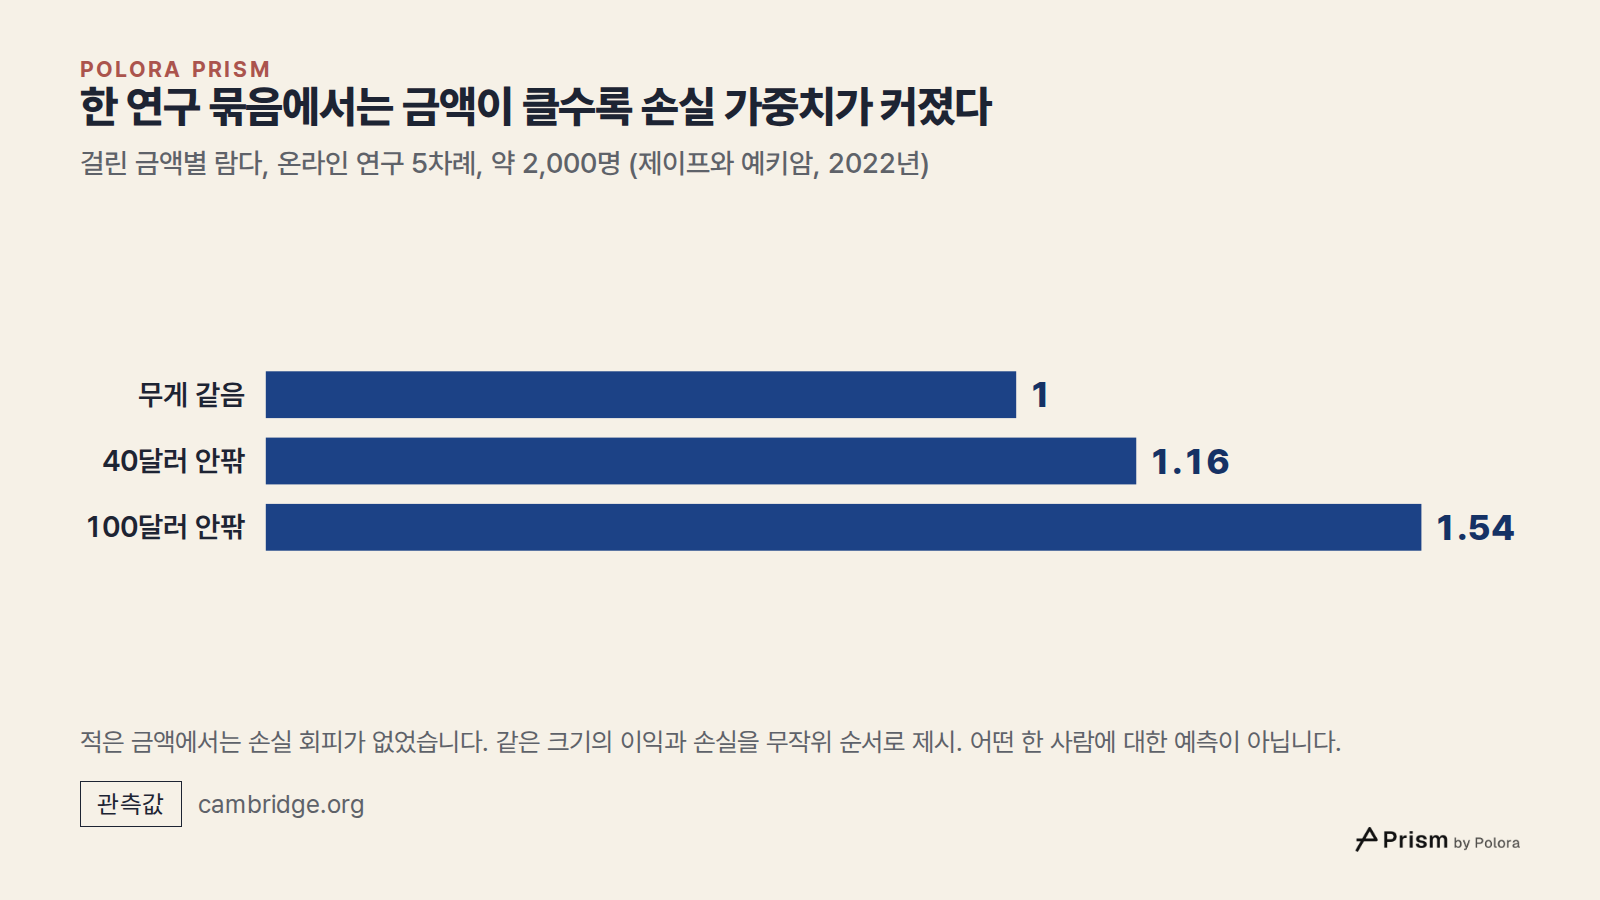
한 연구 묶음에서는 금액이 클수록 손실 가중치가 커졌다 · 걸린 금액별 람다, 온라인 연구 5차례, 약 2,000명 (제이프와 예키암, 2022년) · 무게 같음 · 40달러 안팎 · 100달러 안팎 · 1 · 1.16 · 1.54 · 적은 금액에서는 손실 회피가 없었습니다. 같은 크기의 이익과 손실을 무작위 순서로 제시. 어떤 한 사람에 대한 예측이 아닙니다.
걸린 금액별 람다, 온라인 연구 5차례, 약 2,000명 (제이프와 예키암, 2022년)

이 곡선이 내가 가진 주식과 무슨 상관인가

투자자에게 기준점은 흔히 산 가격입니다. 50달러에 산 주식이 지금 40달러라면 10달러 손실처럼 느껴집니다. 하지만 시장 가격은 얼마에 샀든 그 주식을 가진 모든 사람에게 똑같습니다.

여기서는 람다보다 손실 쪽의 휘어짐이 더 중요합니다. 손실이 커질수록 곡선이 완만해지기 때문에, 이 모형은 손실 앞에 선 사람이 확실한 손실을 받아들이기보다 도박을 택할 거라고 예측합니다. 1979년 논문에서 80% 확률로 4,000달러를 받는 도박과 확실한 3,000달러 가운데, 응답자의 80%가 확실한 쪽을 골랐습니다. 그런데 같은 선택을 손실로 바꿔 묻자 92%가 도박을 택했습니다.

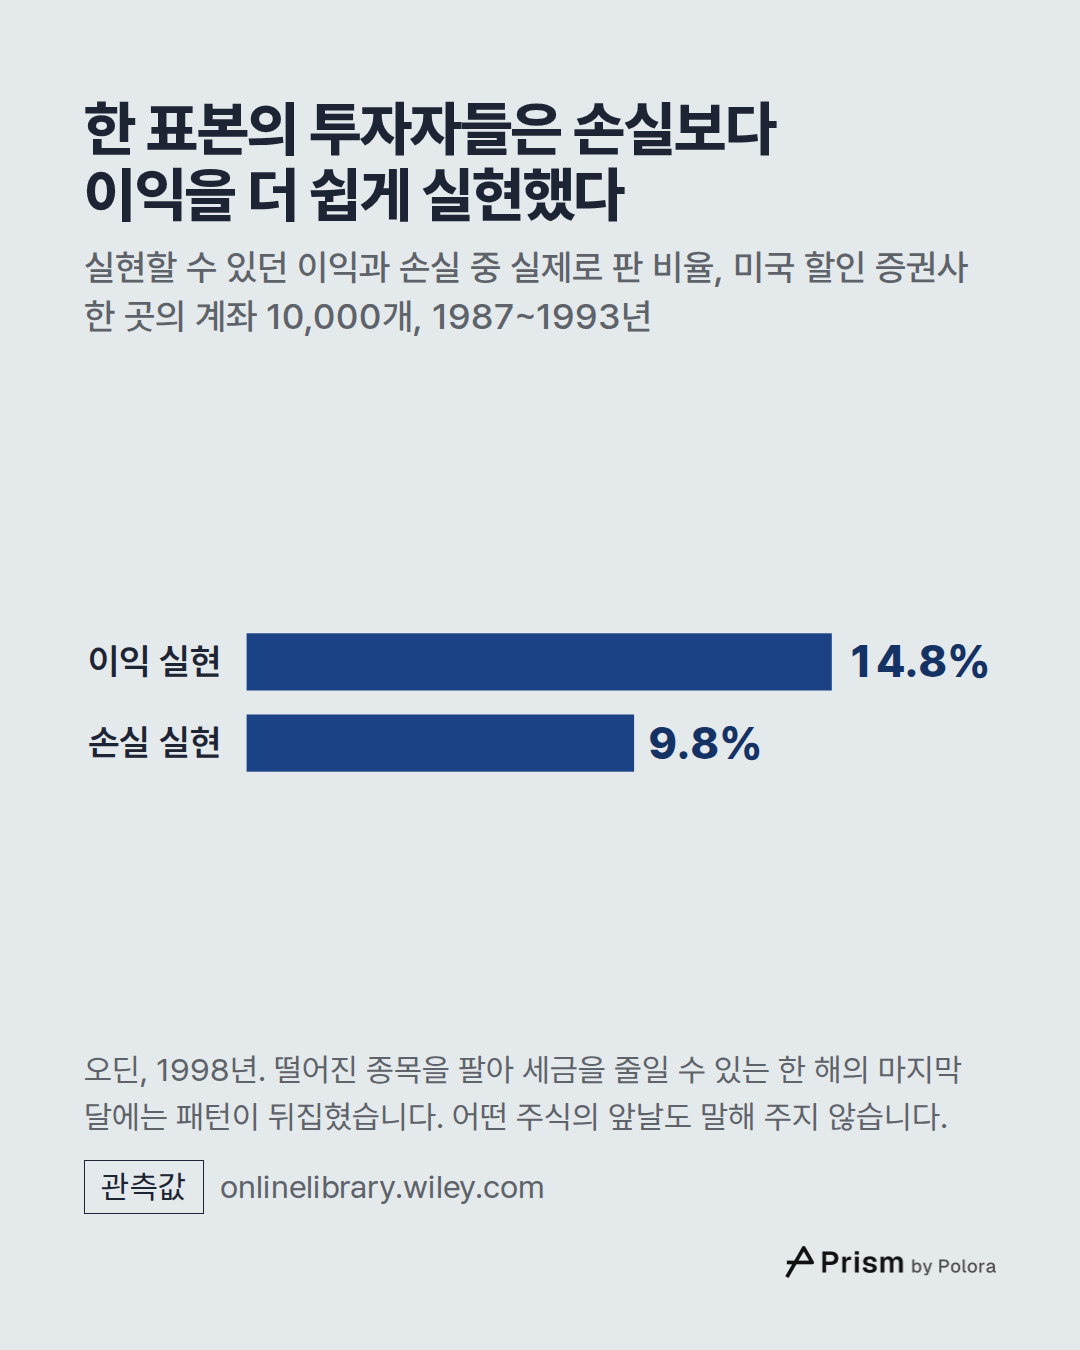
허시 셰프린과 메이어 스탯먼은 투자에서 보이는 비슷한 행동에 '처분 효과'라는 이름을 붙였습니다(학술지 Journal of Finance, 1985년). 오른 종목은 너무 일찍 팔고, 떨어진 종목은 너무 오래 들고 있는 행동입니다. 이들은 이를 곡선 하나가 아니라 심적 회계, 후회, 세금 같은 여러 요인을 함께 들어 설명했습니다. 이어 테런스 오딘은 미국의 한 대형 할인 증권사에서 무작위로 고른 계좌 10,000개의 1987년부터 1993년까지 거래로 이를 검증했습니다(학술지 Journal of Finance, 1998년). 이 투자자들은 실현할 수 있던 이익의 14.8%를 실현했지만, 손실은 9.8%만 실현했습니다. 떨어진 종목을 팔아 세금을 줄일 수 있는 한 해의 마지막 달에는 이 패턴이 뒤집혔습니다. 이 표본에서 투자자들이 판 오른 종목은 그 뒤 한 해 동안 계속 들고 있던 떨어진 종목보다 3.4%포인트 더 좋은 성과를 냈습니다. 이는 그 시기 그 계좌들에 관한 결과이고, 어떤 주식이 앞으로 어떻게 될지나 누가 언제 팔아야 하는지에 대해서는 아무것도 말하지 않습니다.

곡선과 이 행동의 연결은 보기보다 간접적입니다. 니컬러스 바버리스와 웨이 슝은 전망 이론의 단순한 형태 몇 가지를 직접 따져 보았습니다(학술지 Journal of Finance, 2009년). 연간 이익과 손실을 기준으로 한 형태는 처분 효과를 예측하지 못할 때가 많았고 때로는 반대를 예측했습니다. 반면 실제로 실현한 이익과 손실을 기준으로 한 형태는 처분 효과를 더 안정적으로 예측했습니다.
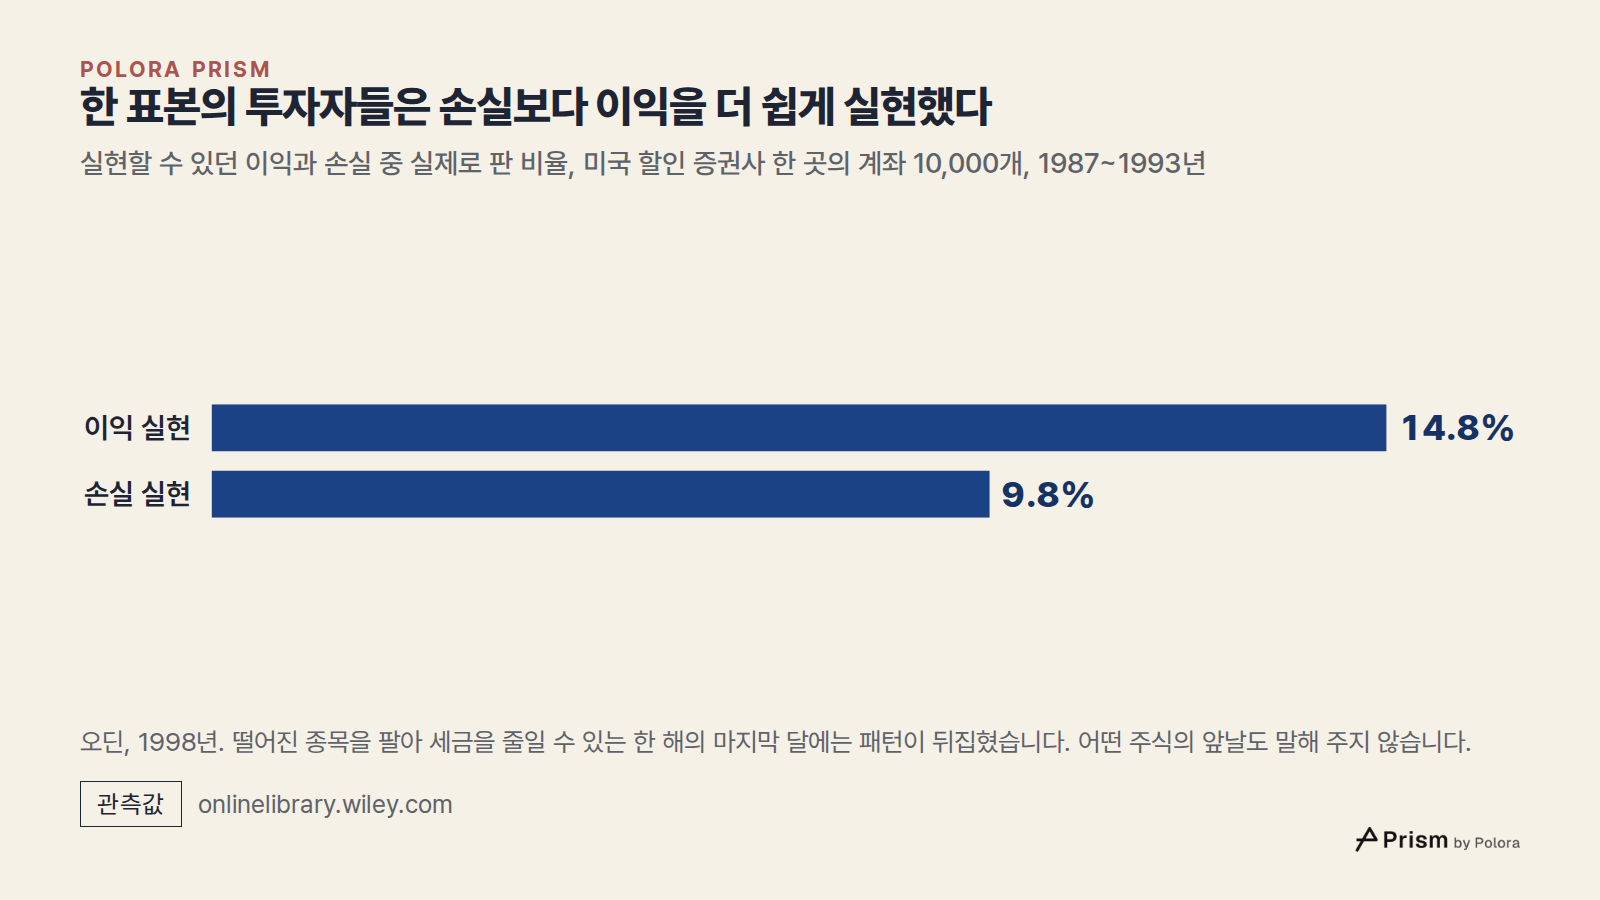
한 표본의 투자자들은 손실보다 이익을 더 쉽게 실현했다 · 실현할 수 있던 이익과 손실 중 실제로 판 비율, 미국 할인 증권사 한 곳의 계좌 10,000개, 1987~1993년 · 이익 실현 · 손실 실현 · 14.8% · 9.8% · 오딘, 1998년. 떨어진 종목을 팔아 세금을 줄일 수 있는 한 해의 마지막 달에는 패턴이 뒤집혔습니다. 어떤 주식의 앞날도 말해 주지 않습니다.
실현할 수 있던 이익과 손실 중 실제로 판 비율, 미국 할인 증권사 한 곳의 계좌 10,000개, 1987~1993년

그래서 손실이 정말 더 아픈가

많은 실험에서 사람들의 선택은 실제로 손실을 같은 크기의 이익보다 무겁게 따졌고, 이 패턴은 거듭 확인되었습니다. 흔들린 것은 크기입니다. 흔히 듣는 '두 배'는 1992년 학생 25명에게서 나왔습니다. 그 뒤의 연구를 종합한 결과들은 저마다 다른 연구를 골라 담았고, 손실이 이익보다 작았는지, 선택지를 어떻게 늘어놓았는지, 진짜 돈이었는지, 얼마가 걸렸는지에 따라 그 값은 2 가까이에서 1.3 가까이, 그리고 1에 가까운 데까지 나왔습니다.

이 숫자들은 선택을 설명합니다. 손실이 실제로 일어난 뒤 어떻게 느껴지는지는 훨씬 덜 재 보았고, 두 차례의 도박 연구에서는 손실이 사람들이 예상한 것보다 덜 아팠습니다.

그러니 쥐고 갈 만한 문장은 이것입니다. 실험실에서 손실은 대개 이익보다 무겁지만, 얼마나 무거운지는 사람만큼이나 검사를 어떻게 짰는지에 달려 있다. 다음에 '2배'라는 말을 보면 물어볼 만한 것은 이것입니다. 어떻게 쟀는가, 그리고 잰 것이 선택이었는가 감정이었는가.
손실이 이익보다 두 배 아프다는 말, 사실일까?100달러를 잃으면 왜 100달러를 얻을 때보다 더 아플까?실험에서 손실은 대개 같은 크기의 이익보다 무겁지만, 얼마나 더 무거운지는 일정하지 않았습니다. · 유명한 '두 배'는 1992년 학생 25명에게서 나왔습니다. 그 뒤 추정은 약 2에서 1 가까이까지 갈립니다.2.25 · 손실 무게, 같은 크기 이익의 약 2.25배 · 유명한 '두 배'는 학생 25명의 중앙값 · 1992년 전망 이론 모형의 손실 가중치, 버클리와 스탠퍼드 대학원생 25명의 중앙값 · 도박과 확실한 돈 가운데 고른 선택에 맞춘 값으로, 감정을 잰 값이 아닙니다. 저자들은 사람마다 다르다고 적었습니다.브라운 연구팀, 2024년 · 왈라섹 연구팀, 2024년 · 블레이크로트와 라리동, 2023년 · 1.82~2.10 · 1.10~1.53 · 1.25~1.45 · 손실이 더 무겁다는 데는 같아도, 얼마나인지는 갈린다 · 연구별 람다 범위 : 손실이 같은 크기 이익의 몇 배로 무거운지 (1이면 무게가 같음) · 브라운·왈라섹 연구팀 : 서로 다른 연구 묶음으로 낸 95% 범위. 블레이크로트와 라리동 : 추정값의 폭, 금액은 가상.이익과 손실이 같은 범위에 걸쳐 있으면, 한 재분석에서 둘의 무게는 거의 같았습니다. · 예키암과 제이프(2025년) : 범위가 같고 순서대로 제시되지 않은 추정값 22개에서 약 1.07. 더 큰 종합 연구는 설계의 영향이 크지 않다고 보았습니다.무게 같음 · 40달러 안팎 · 100달러 안팎 · 1 · 1.16 · 1.54 · 한 연구 묶음에서는 금액이 클수록 손실 가중치가 커졌다 · 걸린 금액별 람다, 온라인 연구 5차례, 약 2,000명 (제이프와 예키암, 2022년) · 적은 금액에서는 손실 회피가 없었습니다. 같은 크기의 이익과 손실을 무작위 순서로 제시. 어떤 한 사람에 대한 예측이 아닙니다.이익 실현 · 손실 실현 · 14.8% · 9.8% · 한 표본의 투자자들은 손실보다 이익을 더 쉽게 실현했다 · 실현할 수 있던 이익과 손실 중 실제로 판 비율, 미국 할인 증권사 한 곳의 계좌 10,000개, 1987~1993년 · 오딘, 1998년. 떨어진 종목을 팔아 세금을 줄일 수 있는 한 해의 마지막 달에는 패턴이 뒤집혔습니다. 어떤 주식의 앞날도 말해 주지 않습니다.출처 24 : ideas.repec.org · Kahneman and Tversky (1979), Prospect theory : an analysis of decision under risk, Econometrica, ucl.ac.uk · Kahneman and Tversky (1979), Prospect theory, full text, link.springer.com · Tversky and Kahneman (1992), Advances in prospect theory, Journal of Risk and Uncertaint전체 글 읽기 · polora.ai

Why does losing $100 hurt more than winning $100 feels good?

Alpha · deepseek-v4-pro

The honest answer is threefold: losses usually do outweigh gains in people's choices, but modestly and conditionally — and part of why a $100 loss feels bigger is that you predict it will hurt more than it actually does. The standard explanation is prospect theory (Kahneman & Tversky, 1979, 1992), and its core mechanism is worth getting right. People don't evaluate money by their total wealth. They evaluate changes from a reference point — where they started or what they expected. So the same $100 isn't one event with two signs; it's two different events. Losing $100 takes something already counted as yours, while winning $100 adds something you didn't have. In that frame, value attaches to the change, not the level. And the value function is steeper on the loss side than the gain side: the same step left drops you further than the same step right lifts you. That steepness ratio is called lambda (λ), and it's how the field measures loss aversion. Here's what usually gets left out. The famous number — "a loss hurts about twice as much as a gain pleases" — is the *median* λ of 2.25 from a 1992 study of 25 graduate students choosing among hypothetical gambles. A median only exists b…

Beta · gpt-6-sol

The best-supported answer is about how people evaluate a choice, not a universal rule about how intensely they feel. Prospect theory models outcomes relative to a reference point—what you have or expected to have. On its familiar graph, gains extend right, losses left, and the loss side falls more sharply than the gain side rises. Both sides also flatten farther from that point: *diminishing sensitivity* shapes the curve, while *loss aversion* is the unequal weighting of equal-sized gains and losses. The graph is a model of valuation, not a recording of anyone’s emotions. Kahneman and Tversky’s 1979 paper is available at https://www.ucl.ac.uk/anaesthesia/sites/anaesthesia/files/kahneman-tversky.pdf. (ucl.ac.uk) What I would change in the manuscript and Alpha’s answer: - The 1992 paper supports 25 graduate students, a $25 participation payment, a median loss-aversion parameter λ = 2.25, and a median curvature exponent of 0.88 on each side. It also explicitly notes noisy choices and individual differences. But its description of that particular experiment does…

Gamma · gemini-3.1-pro

Here is what the record and my own checks show regarding the manuscript's claims, following the editor’s brief: Verification of the Manuscript's Claims & Requested Checks: * 1992 Study Details (Tversky & Kahneman): The 25 graduate students and the $25 flat fee are confirmed. As Beta noted, the paper does not explicitly label the gamble outcomes as "hypothetical" in a way that proves no real money changed hands beyond the fee, but they are widely understood as such in the literature. The authors explicitly note that parameters like lambda vary across individuals. (Source: *Journal of Risk and Uncertainty*, 1992; https://psych.fullerton.edu/mbirnbaum/teaching/psych466/articles/Tversky_Kahneman_JRU_92.pdf) * Brown, Imai, Vieider & Camerer (2024): The figures are confirmed. The meta-analysis reports a raw median of 1.69, a raw mean of 1.97, and an adjusted estimate of 1.955 with a 95% interval of 1.82 to 2.10. It also notes that few design features significantly correlate with the estimates. (Source: *Journal of Economic Literature*; https://topcat.aeaweb.org/articles?id=10.1257%2Fjel.20221698) * Neumann & Böckenholt (2014): Confirmed. My search verifies that th…

Researcher · gpt-6-luna

Research check The strongest correction to the answers so far is about feeling versus choosing. Most loss-aversion estimates describe choices, not the intensity of a person’s experienced emotion. Kermer and colleagues’ two gambling studies found that participants expected losses to affect them more than equal gains, but actual losses had less emotional impact than they had predicted. That supports distinguishing anticipated hurt from experienced hurt; it does not establish that every loss feels no worse than an equal gain. Source: https://journals.sagepub.com/doi/10.1111/j.1467-9280.2006.01760.x (journals.sagepub.com) Other key checks: - The 1992 estimate: Tversky and Kahneman’s paper introduced cumulative prospect theory and discusses diminishing sensitivity and loss aversion. A later authoritative summary gives the fitted parameters as α = 0.88 and λ = 2.25. But describing 2.25 as “the middle person’s” measured feeling would be too strong: λ is a fitted choice-model parameter, not an individual emotion measurement. The material retrieved this turn did not let me verify that…

The Arbiter · gpt-6-sol

The voices agree on an important distinction: the familiar “twice as much” number describes a model fitted to choices, not a direct measurement of how bad a loss feels. Prospect theory’s curve separates a reference point, flattening sensitivity as amounts grow, and greater weight on the loss side. The 1992 paper is the source of the often-quoted λ estimate of 2.25; that parameter should not be presented as a fixed ratio of slopes everywhere on the curve. (psych.fullerton.edu) The real disagreement is how far to take the evidence about *feeling*. Alpha treats overpredicted pain as a central explanation. Beta and the Researcher give it a narrower reading: Kermer and colleagues found a gap between forecast and experience in their gambling studies, but that does not settle what every person feels after losing $100. Gamma’s description of the finding as largely a forecasting error goes further than this evidence warrants. (journals.sagepub.com) For the manuscript, the remaining bound…

The Arbiter's Final Verdict · gpt-6-sol

Verdict The manuscript’s premise stands for choices, but not as a universal claim about feelings. People often give a possible $100 loss more weight than a possible $100 gain. Prospect theory explains this by treating outcomes as changes from a *reference point*—what someone has or expects—rather than simply as changes in total wealth. Its familiar curve also flattens farther from that point on both sides (*diminishing sensitivity*) and gives losses greater weight than equal gains (*loss aversion*). That curve models valuation; it is not a recording of felt pain. Kahneman and Tversky, 1979; Tversky and Kahneman, 1992. Here is what the manuscript can—and cannot—carry: - “Twice as much” has a source, not universal status. The 1992 paper fitted choices by 25 graduate students, paid $25 to participate. Its reported median loss-aversion parameter, λ, was 2.25, with a curvature exponent of 0.88 on both sides. λ scales the loss side of that fitted curve; it is neither a constant ratio of slop…