같은 문서 하나를 일곱 개 회사의 AI에 똑같이 넣어 봤습니다. 돌아온 청구서를 보니 '입력 토큰 수'가 회사마다 전부 달랐습니다. 글자 하나 바꾸지 않은 똑같은 문서였는데도 그랬습니다.
토큰은 AI가 글을 끊어 읽는 단위이고, 요금도 토큰 개수로 매겨집니다. 어디서 끊을지는 사람이 정한 문법이 아니라, 학습에 쓰인 방대한 글에서 자주 붙어 다니던 덩어리를 기준으로 정해집니다. 그래서 대략 낱말이나 낱말 조각쯤 되는 단위라고 생각하면 크게 틀리지 않습니다.
토큰을 세는 잣대가 회사마다 다르다
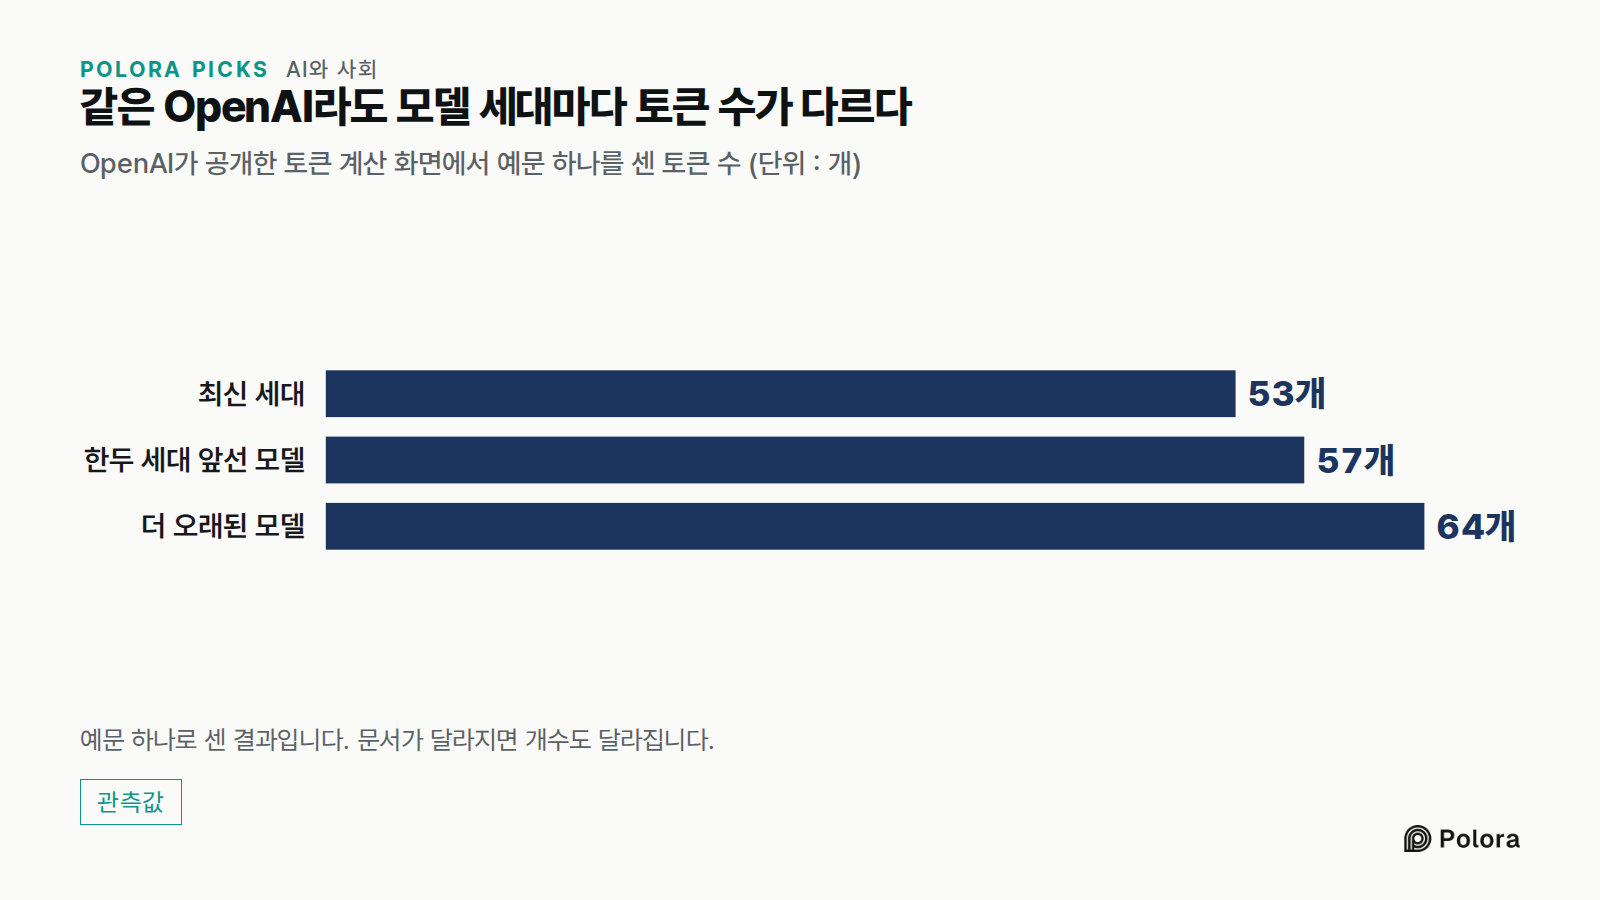
문제는 글을 어떤 덩어리로 끊을지 정한 목록, 곧 토큰을 세는 잣대(토크나이저)를 회사마다 따로 만든다는 데 있습니다. 게다가 같은 회사라도 모델 세대가 바뀌면 목록을 새로 짜기도 합니다. OpenAI가 공개한 토큰 계산 화면에 예문 하나를 넣고 세어 보면 최신 세대에서는 53개, 한두 세대 앞선 모델에서는 57개, 더 오래된 모델에서는 64개가 나옵니다. 한 회사 안에서도 이만큼 벌어지니, 회사끼리는 말할 것도 없습니다.
길이에는 미터, 무게에는 그램이라는 공통의 잣대가 있습니다. 토큰에는 그런 잣대가 없습니다. 저마다 다른 잣대로 같은 글을 재고 있는 셈입니다.
AI 단가는 그대로인데 청구서만 커진 일
이 문제를 처음 눈여겨본 건 클라우드와 AI 비용을 추적하고 관리하는 실무 분야인 FinOps의 한 행사 발표에서였습니다. 발표자는 AI를 쓰는 비용을 산정하기가 왜 그렇게 까다로운지 짚으면서, 토큰을 세는 방식이 달라 같은 가격표라도 실제로 나가는 돈은 크게 벌어진다고 했습니다.
실제 사례도 있습니다. 지난 4월 Anthropic은 새 모델을 내면서 토큰을 세는 방식을 바꿨습니다. 가격표의 단가는 직전 모델과 똑같았는데, 같은 글에서 토큰이 최대 35%까지 더 나왔습니다. 단가는 한 푼도 오르지 않았는데 청구서만 커진 겁니다.
한국어 문서로 일곱 회사, 열여섯 모델의 토큰 수를 재보다
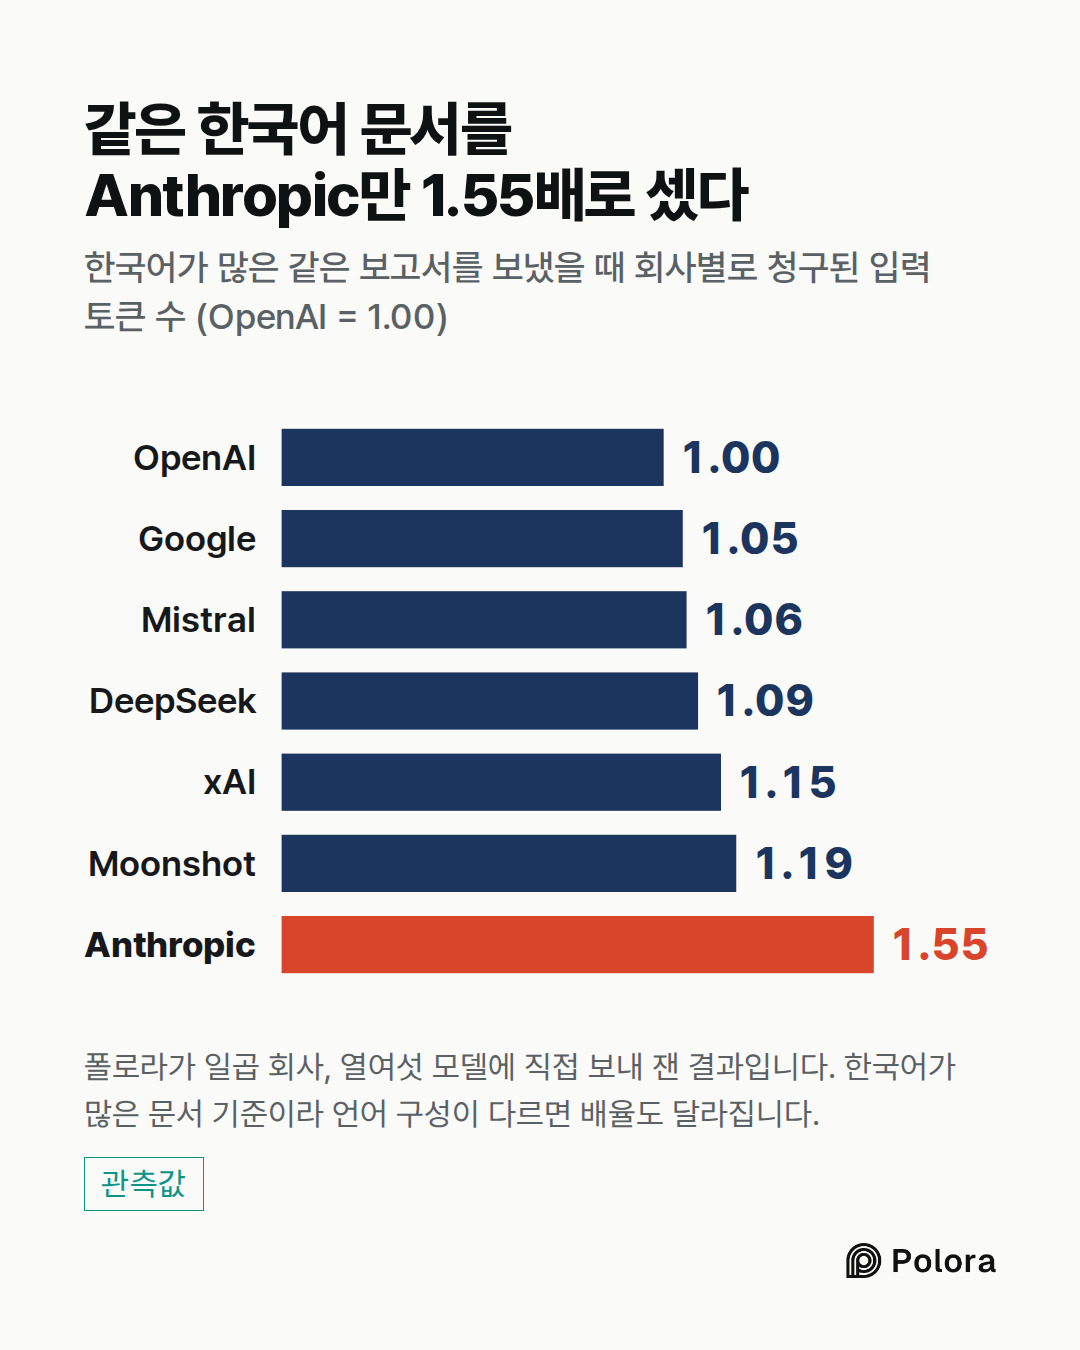
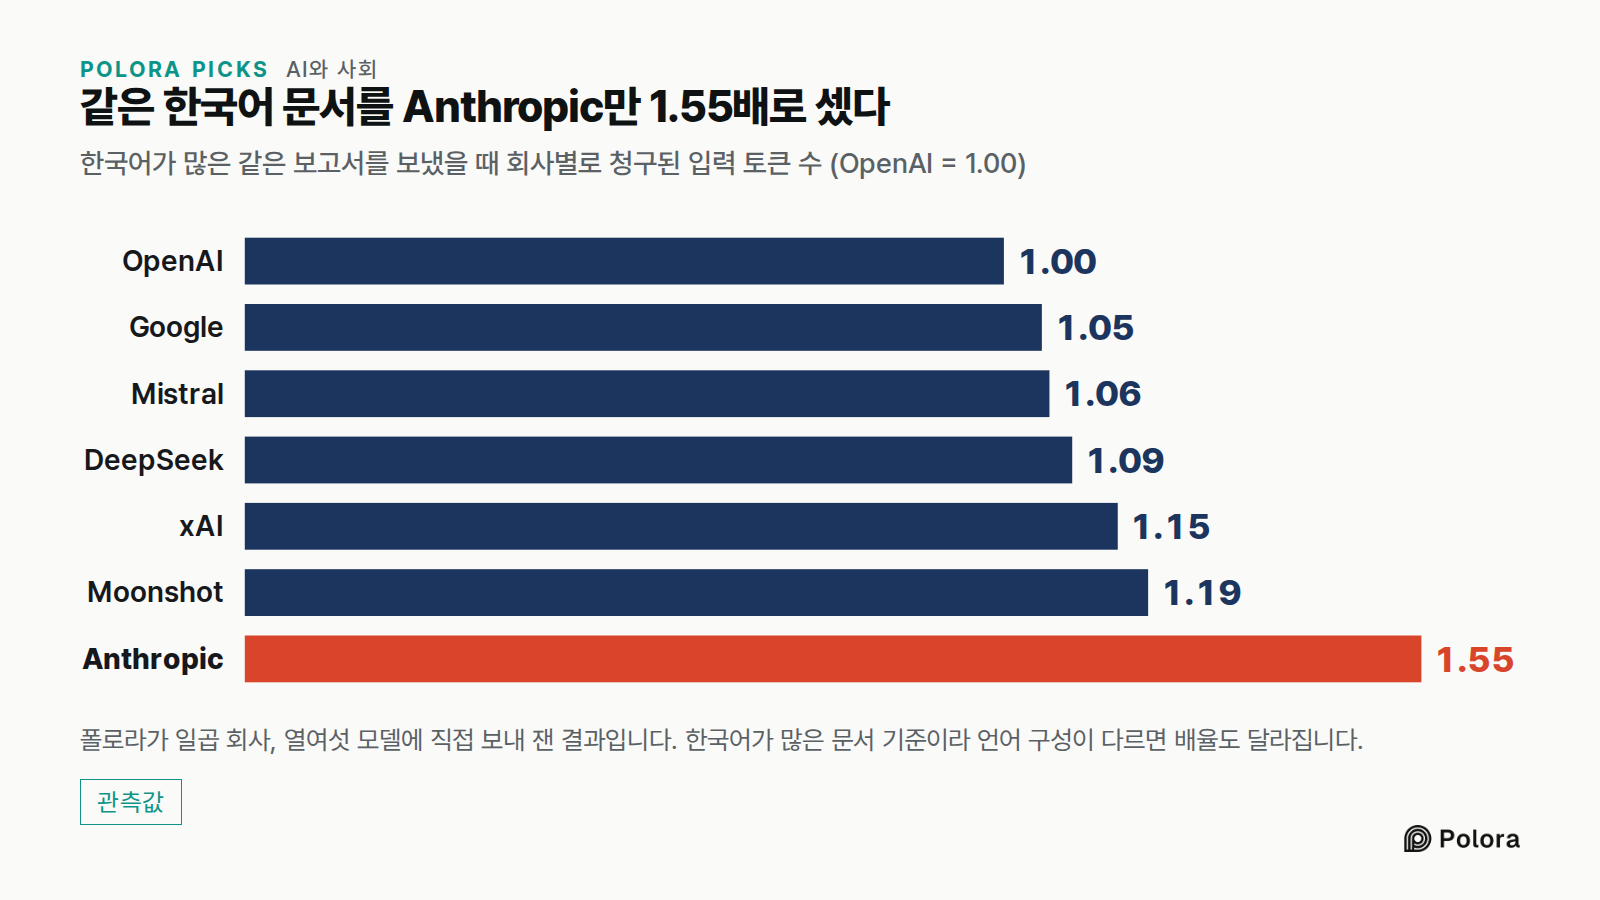
그래서 폴로라에서 직접 재 봤습니다. 한국어가 많은 같은 보고서를 붙인 똑같은 질문을 일곱 개 회사의 열여섯 개 모델에 여러 번 나눠 보내고, 각 회사가 청구 근거로 돌려준 토큰 수를 모았습니다.
OpenAI가 센 개수를 1.00으로 놓으면 Google 1.05, Mistral 1.06, DeepSeek 1.09, xAI 1.15, Moonshot 1.19로 서로 엇비슷했습니다. 그런데 Anthropic만 1.55로, 홀로 멀찍이 떨어져 있었습니다.
이 수치는 보낼 때마다 달라지는 우연이 아닙니다. 같은 회사, 같은 세대의 두 모델에 같은 입력을 121번 넣었는데, 토큰 수는 매번 한 치도 다르지 않았습니다.
AI의 진짜 가격은 단가에 토큰 수를 곱해야 보인다
토큰 수 차이가 곧 돈 문제인 것은 AI 가격표의 단위가 토큰이기 때문입니다. 두 회사가 똑같이 '100만 토큰당 2달러'라고 적어 두어도, 한쪽이 같은 글을 1.55배로 센다면 실제로 내는 돈도 1.55배입니다. 환율을 빼놓고 통화가 다른 두 나라의 가격표를 비교해 온 셈입니다.
이것이 품질과 곧바로 이어지는 이야기는 아닙니다. 글을 잘게 나누는 방식이 성능에 유리한 면도 있고, 회사들도 그 점을 감안해 단가를 정했을 수 있습니다. 요점은 단가만 나란히 놓아서는 안 되고, 내 문서를 각 회사가 몇 개로 세는지까지 곱해야 실제로 낼 돈이 보인다는 것입니다. 다만 이번 측정은 한국어가 많은 문서를 기준으로 한 것이라, 언어 구성이 다르면 배율도 달라집니다.
견적서를 받으면 단가를 따지는 것만큼이나 수량을 세는 기준이 서로 같은지부터 맞춰 봐야 비교가 됩니다. 한국어 문서로 잰 이번 측정에서도 같은 글을 두고 회사마다 센 개수가 갈렸습니다. AI 요금에도 길이의 미터 같은 공통의 잣대가 필요해질 때가 오는 듯합니다.
다음 글에서는 같은 질문을 영어로 물을 때와 한국어로 물을 때 요금이 얼마나 벌어지는지 재 본 결과를 다룹니다. 한국어로 쓰는 사람에게는 조금 억울한 숫자가 나옵니다.