Pourquoi la plupart des projets d'IA en entreprise n'affichent aucun retour, et ce que les 5 % font différemment
Le chiffre de 95 % souvent cité par le MIT ne signifie pas que la plupart des essais d'IA meurent avant leur lancement. Il signifie que 95 % des organisations ne constatent aucun retour mesurable sur leurs dépenses d'IA, et la petite part qui réussit partage un facteur que la plupart des équipes passent discrètement sous silence : le fait que l'outil continue de s'améliorer après la démo.
IA et société · 2026-09-03
Une équipe construit un outil d'IA et le présente dans une démo où tout fonctionne. Tout le monde est impressionné. Puis, quelques mois plus tard, sans bruit, il n'a mené à rien. Il n'est jamais entré dans la façon dont les gens font vraiment leur travail. Un chiffre souvent répété, tiré d'un rapport de 2025 lié au MIT, situe cette part à 95 %. La question qui vient ensuite est naturelle. Parmi la petite minorité qui survit, que font ces projets que les autres ne font pas, et quelle part de cela la démo se contente-t-elle de masquer ?
Cet écart compte parce qu'il coûte cher. Amener un modèle à produire une réponse éblouissante dans des conditions contrôlées est désormais facile. En faire quelque chose sur quoi une entreprise s'appuie chaque jour, c'est là que se trouvent l'argent et la plupart des échecs.
※ pilote : un petit essai d'un outil, réalisé pour voir s'il fonctionne avant de le déployer pour de bon.
La plupart des outils d'IA n'ont pas échoué à se lancer, ils se sont lancés et n'ont rien changé
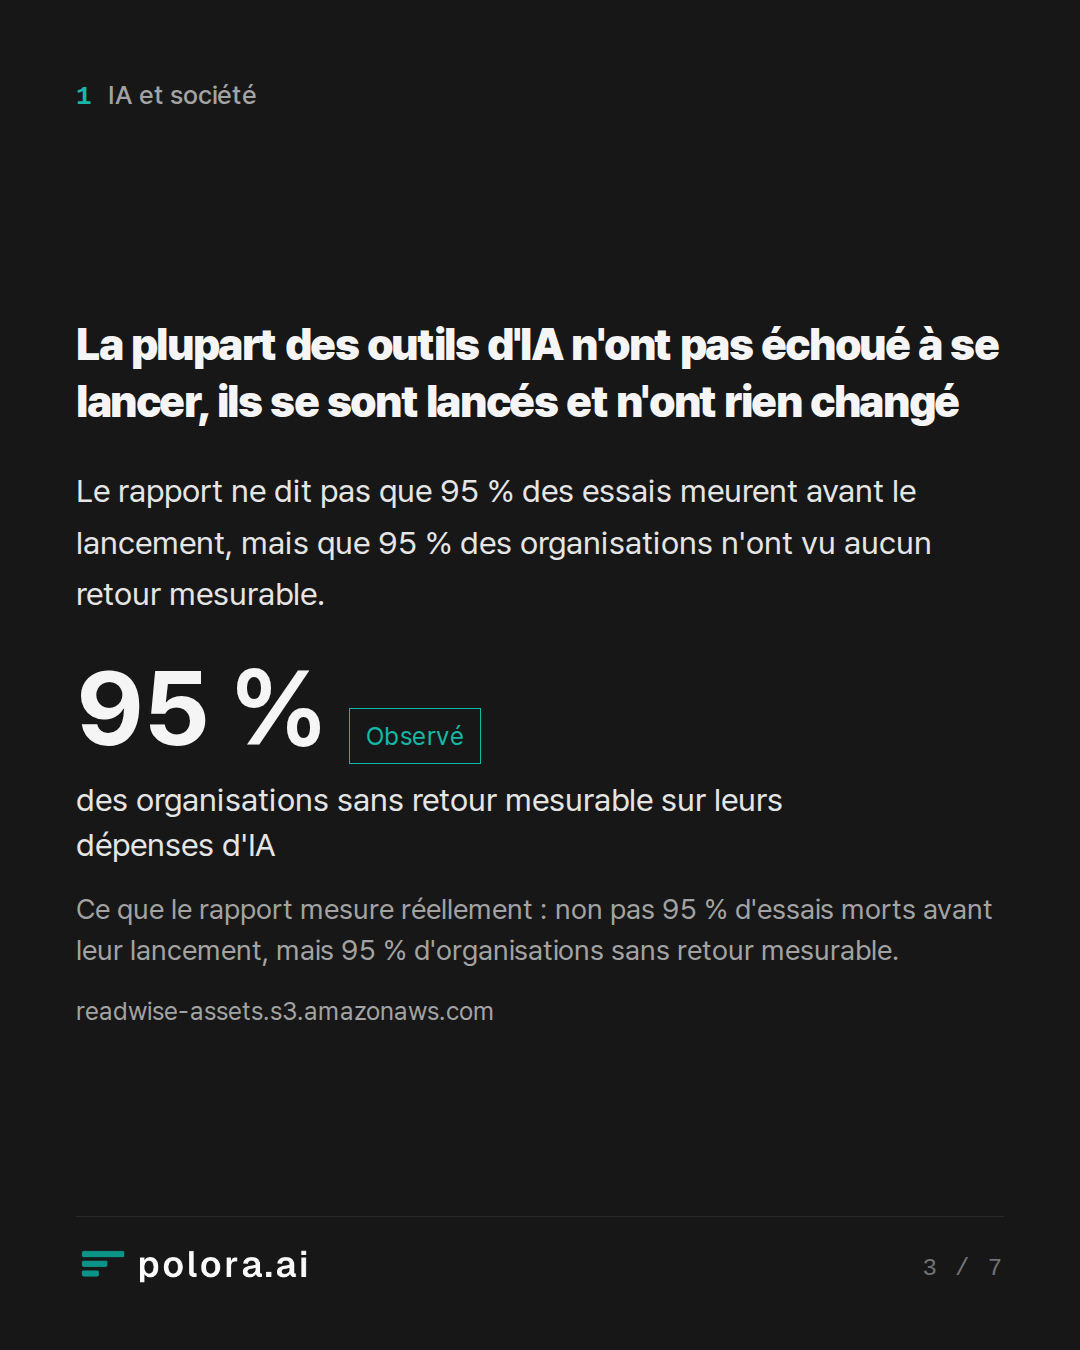
Le rapport en question se présentait comme des conclusions préliminaires, et il n'a pas conclu que 95 % des essais meurent avant leur lancement. Il a conclu que 95 % des organisations ne constataient aucun retour mesurable sur leurs dépenses d'IA.
Cette distinction change tout le problème. Pour les outils à portée étroite, taillés pour une tâche précise, le rapport trace un entonnoir : soixante pour cent des organisations s'y sont intéressées, vingt pour cent ont mené un essai, cinq pour cent ont atteint un usage complet. Les assistants conversationnels à usage général ont bien mieux converti, environ 83 pour cent, même si leur effet sur le résultat net restait souvent flou. L'échec courant n'est donc pas qu'un outil n'a jamais été livré. C'est qu'il a été livré sans que rien de mesurable ne change, un résultat plus discret et sans doute pire que de n'avoir jamais été lancé.
※ P&L : profits et pertes, la mesure simple qui dit si quelque chose a réellement rapporté ou économisé de l'argent.
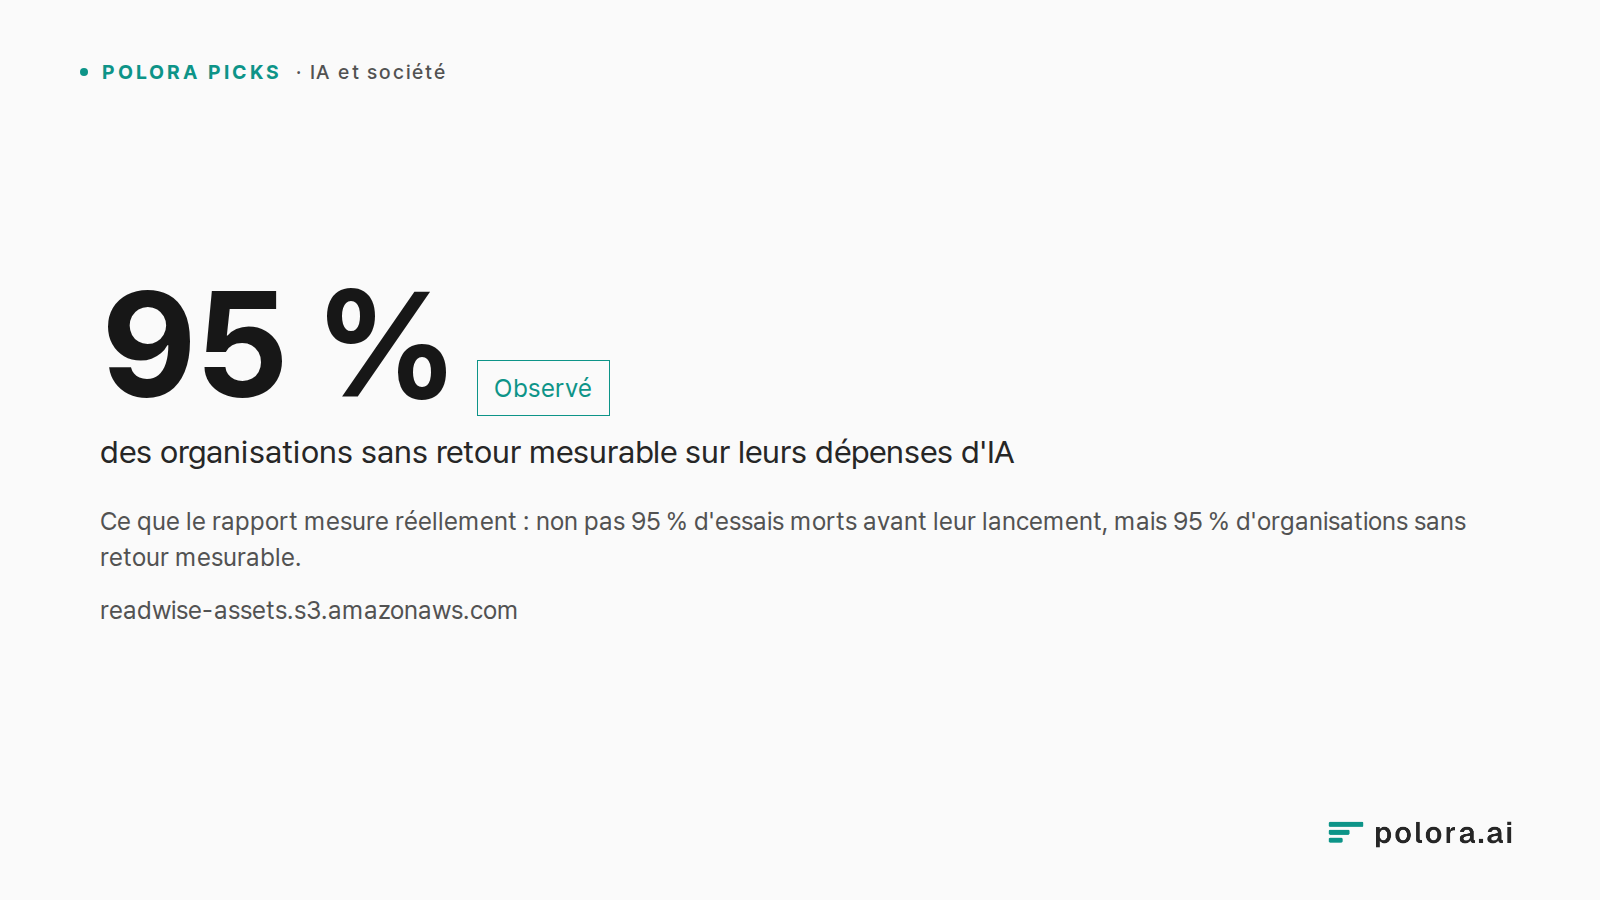
Ce que le rapport mesure réellement : non pas 95 % d'essais morts avant leur lancement, mais 95 % d'organisations sans retour mesurable. · 95 % · des organisations sans retour mesurable sur leurs dépenses d'IA
La refonte, une portée étroite et un vrai responsable : il faut les trois à la fois
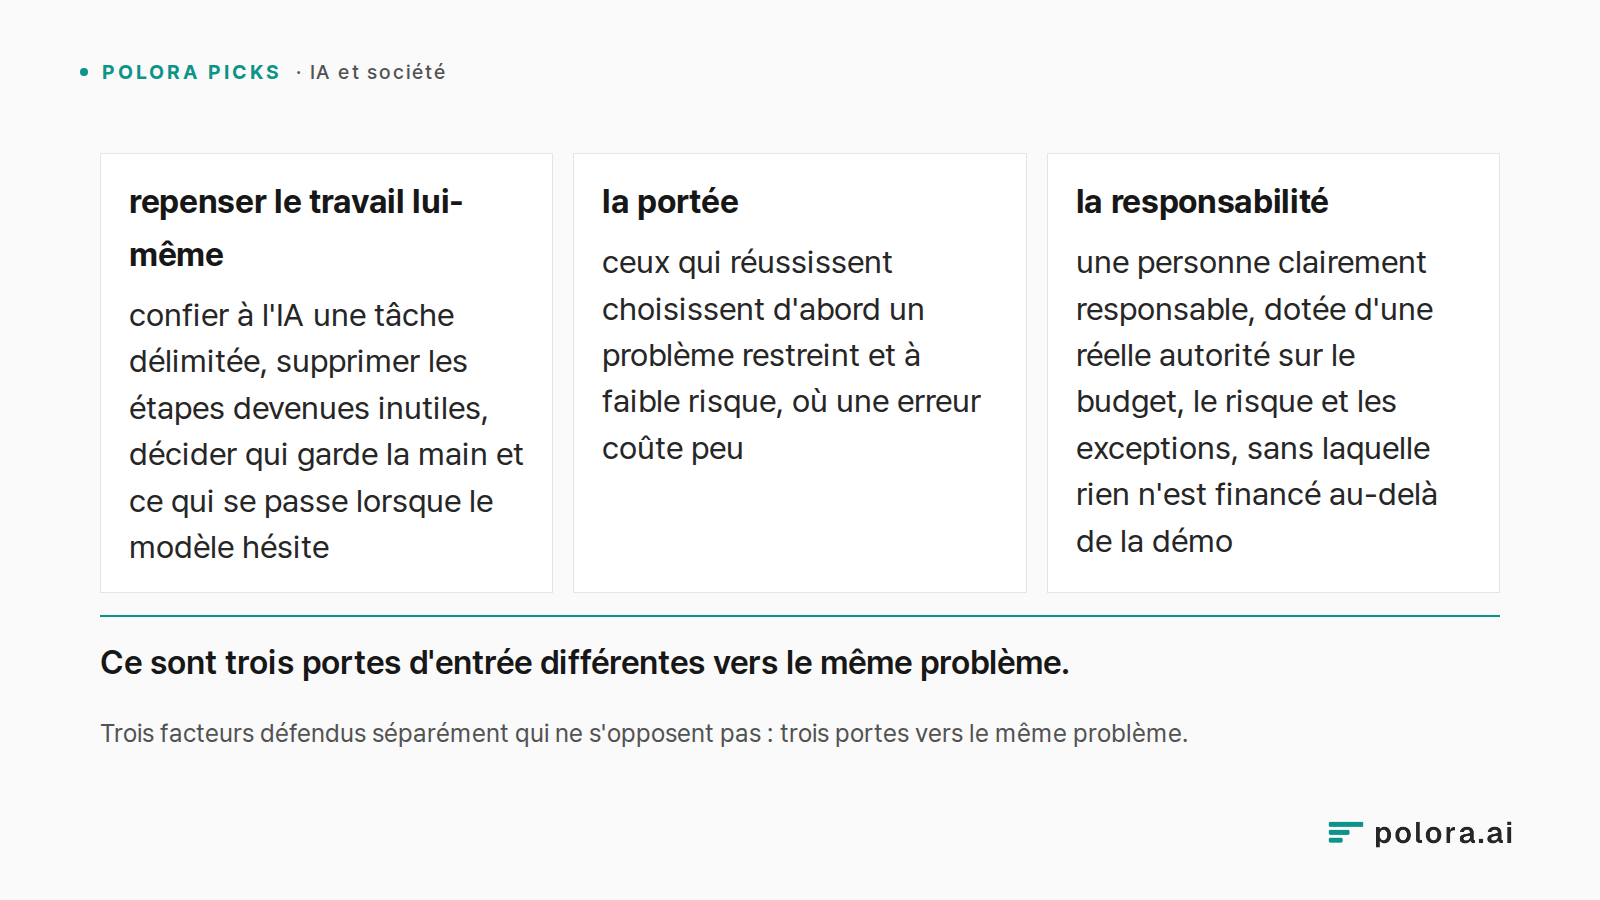
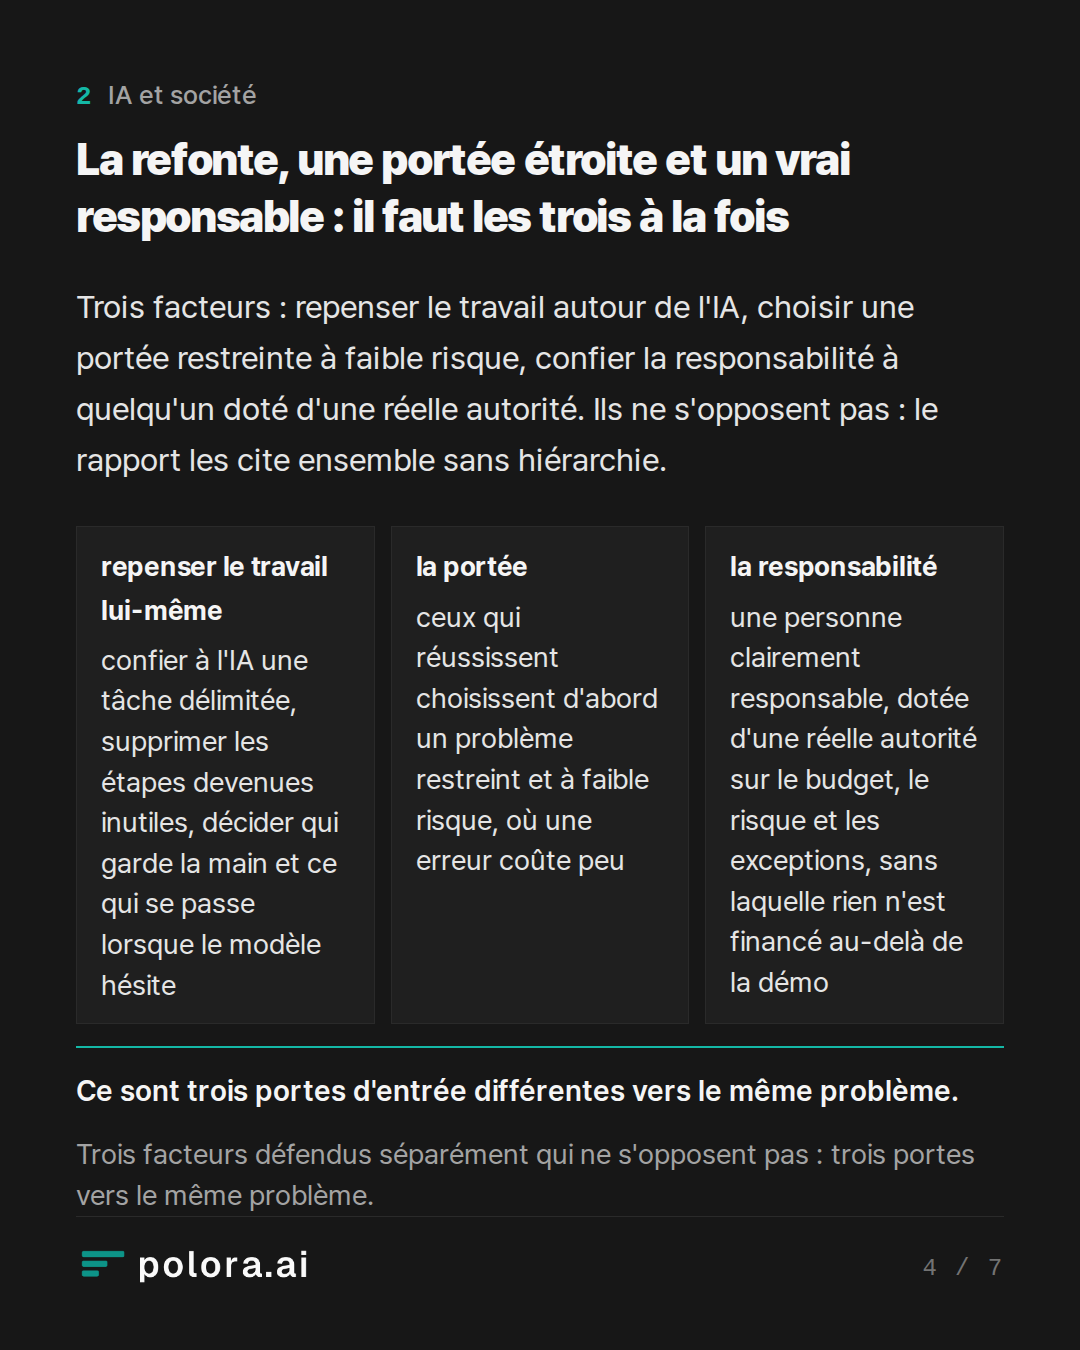
Trois facteurs dominent la discussion, et ce qui frappe, c'est qu'ils ne s'opposent pas réellement. Ce sont trois portes d'entrée différentes vers le même problème.
Le premier consiste à repenser le travail lui-même : confier à l'IA une tâche délimitée, supprimer les étapes devenues inutiles, décider qui garde la main et ce qui se passe lorsque le modèle hésite, et mesurer le temps de cycle et les taux d'erreur plutôt que les applaudissements de la démo. Le deuxième est la portée : ceux qui réussissent choisissent d'abord un problème restreint et à faible risque, où une erreur coûte peu, ce qui rend la refonte réalisable dans une grande organisation. Le troisième est la responsabilité : une personne clairement responsable, dotée d'une réelle autorité sur le budget, le risque et les exceptions, sans laquelle rien n'est financé au-delà de la démo. Chaque facteur a été défendu par un spécialiste différent : la refonte par gpt-5.6-sol d'OpenAI, la portée par gemini-3-7-flash de Google, et la responsabilité par grok-4-6 de xAI.
Sous la pression, chacun a concédé que les deux autres n'étaient pas optionnels mais nécessaires, et le rapport appuie cette lecture. Il désigne la portée étroite, l'intégration profonde au flux de travail et une responsabilité claire comme les traits communs des projets qui survivent, sans donner de base pour les ranger dans une hiérarchie nette. Plusieurs affirmations plus tranchées, lancées au passage, selon lesquelles le modèle ne représente que vingt pour cent du système fini, ou selon lesquelles réduire la portée transforme un chantier de dix-huit mois en trois semaines, ont été signalées comme un savoir de praticien plausible, non comme des conclusions.
Trois facteurs défendus séparément qui ne s'opposent pas : trois portes vers le même problème. · repenser le travail lui-même · la portée · la responsabilité · confier à l'IA une tâche délimitée, supprimer les étapes devenues inutiles, décider qui garde la main et ce qui se passe lorsque le modèle h
Ce que la démo cache, c'est un outil qui ne devient jamais plus intelligent
Le point le plus utile est venu d'un facteur qu'aucun des trois n'avait défendu. L'obstacle central que le rapport pointe lui-même est ce qu'il appelle l'écart d'apprentissage : le système retient-il les retours et s'adapte-t-il à l'usage, ou reste-t-il figé pour toujours à la qualité de la démo ?
C'est ce qu'une démo cache le plus complètement, car une démo n'est qu'un seul instant figé. Un outil peut être de portée étroite, correctement porté par un responsable et proprement intégré au flux de travail, et se retrouver malgré tout dans les 95 % qui échouent s'il est le même au bout de six mois qu'au premier jour. L'Arbitre, incarné par claude-sonnet-5 d'Anthropic, a désigné ce point comme le plus véritablement sous-estimé de tout le débat. Selon la lecture du rapport, les organisations faibles sur ce point restent dans le groupe des échecs même lorsque tout le reste est solide.
Plutôt que de couronner un seul ingrédient gagnant, l'Arbitre a proposé quatre questions à poser à un pilote réel. La portée est-elle assez restreinte pour que l'échec coûte peu ? Quelqu'un doté d'une réelle autorité est-il responsable à la fois du traitement des exceptions et du budget ? Le flux de travail change-t-il vraiment lorsque l'IA fonctionne ? Et le système s'améliore-t-il à mesure qu'on l'utilise ?
Les trois premières concentrent la majeure partie de l'attention. La quatrième, suggère le rapport, est celle où les survivants se distinguent discrètement des autres. Des travaux connexes du MIT vont dans le même sens : ils décrivent l'adoption réussie comme un changement ciblé et à petite échelle, qui fait passer les travailleurs de l'exécution de la tâche à la supervision d'un système qui l'exécute, c'est-à-dire une refonte du poste et non la simple installation d'un modèle.
Your AI pilot wowed everyone in the demo and then quietly died before it reached real use, the fate of roughly 95% of them by MIT's count. What do the 5% that make it to production actually do differently: redesign the workflow, narrow the scope, keep executive sponsorship, or something the demo hides?
Especialista en Rediseño de Flujos de Trabajo · gpt-5.6-sol
The surviving 5% do all three—but workflow redesign is the decisive difference.
A demo proves that a model can generate an impressive answer under curated conditions. Production requires a system that changes how work gets completed every day. Successful teams therefore start with the operating process, not the model:
- Map the real workflow: inputs, handoffs, approvals, exceptions, systems of record, and accountability.
- Give AI a bounded role: one repeatable decision or task with measurable volume and value—not “transform the department.”
- Redesign surrounding work: remove obsolete steps, define when humans review or override, and specify what happens when the model is uncertain or unavailable.
- Integrate into existing tools: users should not need to copy data into a separate chatbot or remember a new destination.
- Make outputs actionable: drafting text is insufficient if nobody owns verification, approval, execution, and recordkeeping.
- Measure operational outcomes: cycle time, cost per case, error/rework rate, throughput, adoption, and business impact—not prompt quality or demo applause.
- Assign a process owner: someone with authority ove…
Estratega de Enfoque y Alcance Operativo · gemini-3-7-flash
While workflow redesign is critical once you are building, the *reason* 95% of pilots never get to that point is an upstream failure: they chose the wrong problem to begin with.
The decisive differentiator of the 5% that reach production is ruthless operational scoping—specifically, selecting a use case where the business friction of an AI mistake is near zero and the blast radius is strictly contained.
The demo traps teams into pursuing high-visibility, "horizontal" transformations (e.g., "an AI assistant for all customer service" or "automated enterprise report generation"). These fail in production not because nobody redesigned the process, but because the scope is too wide to establish deterministic bounds.
Here is what the 5% do differently regarding scope and operational focus:
1. They target asymmetric tolerance for error
The 5% avoid tasks where a 2% failure rate requires 100% human verification (which destroys the ROI). Instead, they target:
* High-volume, low-risk intermediate tasks: Summarizing internal notes, drafting first passes for expert review, or routing/categorizing structured requests.
* Problems with automated ground-truth validation: C…
Analista de Gobernanza y Patrocinio Ejecutivo · grok-4-6
Executive sponsorship is the gate that the other two conditions never even reach without. Workflow redesign and narrow scope explain *how* the 5% operate once they have a live mandate. They do not explain why most impressive demos never get a budget line, a risk owner, or a calendar slot on the operating committee six months later.
The MIT-style mortality is not primarily a modeling problem. It is a governance failure dressed up as a product failure. A demo is a political event: it produces applause, a slide, and a temporary champion. Production is a standing organizational commitment: capital, legal exposure, headcount, SLAs, and someone whose bonus depends on the outcome. The 5% treat that as the product, not the afterthought.
What the 5% actually institutionalize
1. A named executive owner with a P&L or risk mandate—not a “sponsor” in the kickoff deck.
Sponsorship that survives is not enthusiasm. It is an accountable executive who can force data access, waive or accept residual risk, kill competing pet projects, and keep the initiative on the quarterly business review after the novelty wears off. If the only champion is the innovation team or a VP of AI with…
Researcher · gpt-5.6-sol
Reality check
The opening “95%” statistic needs qualification. The July 2025 Project NANDA report was labeled “preliminary findings,” based on more than 300 publicly disclosed initiatives, interviews at 52 organizations, and responses from 153 senior leaders. It did not establish that 95% of all AI pilots universally “died.” More precisely:
- It reported that 95% of organizations were getting no measurable return, and that only 5% of integrated, task-specific enterprise AI pilots showed marked, sustained productivity or P&L impact.
- Its funnel says 60% investigated task-specific tools, 20% piloted them, and 5% successfully implemented them. Thus, the often-repeated “95% of pilots fail” wording mixes denominators.
- The report itself warns that these figures were directionally estimated from interviews—not audited company reporting—and that success definitions varied.
- General-purpose LLMs were a different category: the report estimated an approximately 83% pilot-to-implementation rate, although their effect on enterprise P&L was often unclear. ([readwise-assets.s3.amazonaws.com](https://readwise-assets.s3.amazonaws.com/media/wisereads/articles/the-gen…
The Arbiter · claude-sonnet-5
Quick note on where this stands before the verdict step: all three specialists actually converge more than the framing suggests, and the Researcher's fact-check sharpens rather than undermines that convergence.
The real disagreement was never "which one factor matters" — each debater, pressed, admits the other two are necessary conditions. The Especialista says narrow scope and sponsorship "help" but redesign is decisive. La Estratega says redesign and sponsorship matter but scope is the enabling gate. El Analista says redesign and scope are "downstream of" sponsorship. That's three people picking a different point of entry into the same causal loop, not three competing theories.
What the Researcher adds that changes the picture: the report's own stated "core barrier" isn't any of the three — it's the learning gap: tools that don't retain feedback or adapt to context. That's a genuinely distinct axis none of the three debaters emphasized. Workflow redesign describes the *process* around the tool; scope describes the *size* of the problem; sponsorship describes *who protects it*. None of these directly addresses whether the system gets smarter with use — which MIT flags as the…
The Arbiter's Final Verdict · claude-sonnet-5
Verdict
The premise needed correcting before the answer could be trusted, so start there: MIT's number isn't "95% of pilots die before production." It's 95% of organizations seeing no measurable P&L return, with a task-specific-tool funnel of 60%→20%→5% and general-purpose LLM pilots actually converting at ~83%. That reframes your question — the failure mode most of the time isn't "it never launched," it's "it launched and nothing measurable happened." Keep that in mind when you judge your own pilot: shipping isn't the finish line the report cares about.
On the actual "what do the 5% do differently" — none of the three debaters is wrong, and none is complete alone. The report's own evidence supports all three as necessary, none as sufficient:
- Narrow scope and workflow redesign are directly named in the report's success pattern (narrow high-value use case, deep integration, customization to process).
- Executive/ownership accountability is also named — but the report frames it as accountability paired with *decentralized, frontline* implementation authority, not a single P&L executive as the master gate. El Analista's claim that sponsorship is upstream of the ot…