Jusqu'où peut-on laisser un assistant IA agir seul ?
Les modèles d'IA sont pour l'essentiel d'accord : laissez-le lire, trier et rédiger, mais gardez la main sur l'envoi et la suppression. Ils divergent sur un cas précis, et c'est ce désaccord qui éclaire le reste.
IA et société · 2026-09-09
Vous reliez un assistant IA à votre messagerie, à votre agenda et à vos fichiers parce que vous voulez récupérer des heures. Puis vous lisez qu'un agent a effacé des données ou envoyé un message à la mauvaise personne, et vous laissez tout éteint. La vraie question n'est pas de savoir s'il faut lui faire confiance. Elle est de savoir où tracer précisément la limite entre ce qu'il peut faire seul et ce qu'il ne peut pas faire.
Polora a posé cette question à plusieurs modèles d'IA conçus par différentes entreprises et les a fait travailler dessus ensemble, sous l'angle de la sécurité, sous celui de la productivité, et sous celui de la façon dont une personne valide réellement une action. Ils s'accordent sur presque tout et divergent sur un point précis. Voici où ils aboutissent, et pourquoi ce désaccord compte plus que l'accord.
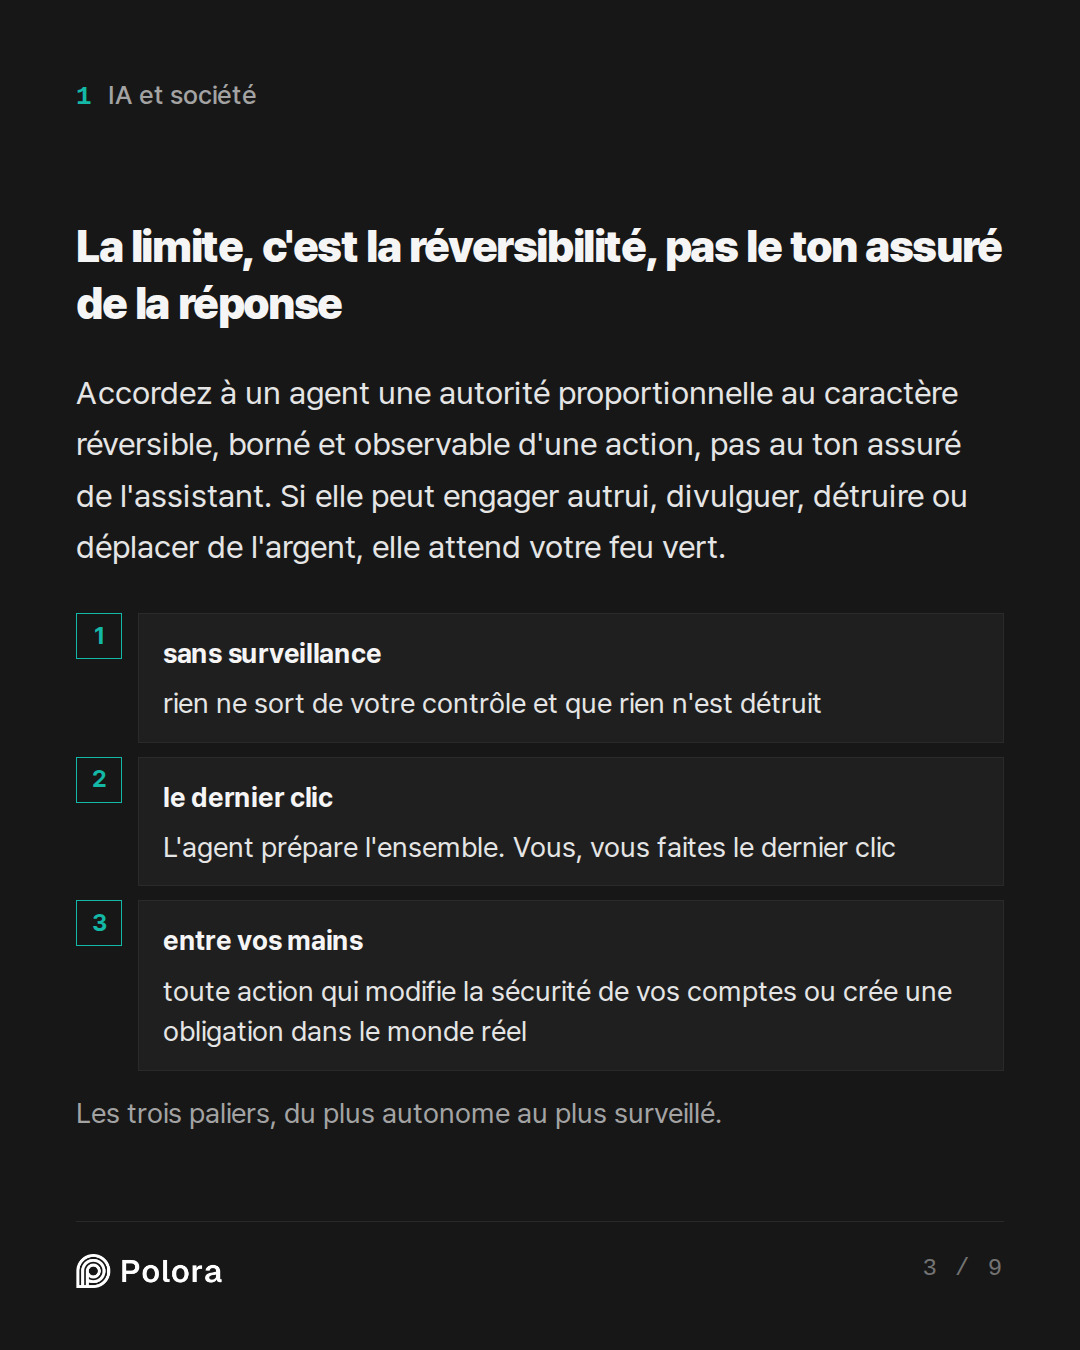
La limite, c'est la réversibilité, pas le ton assuré de la réponse
La règle la plus nette est venue du modèle défendant l'angle sécurité. Accordez à un agent une autorité proportionnelle au caractère réversible, borné et observable d'une action, et non au ton assuré de l'assistant quand il la propose. Un seul test tranche la plupart des cas. Cette action peut-elle créer un engagement envers autrui, divulguer quelque chose, détruire de l'information, déplacer de l'argent ou abîmer une relation ? Si oui, elle doit attendre votre feu vert.
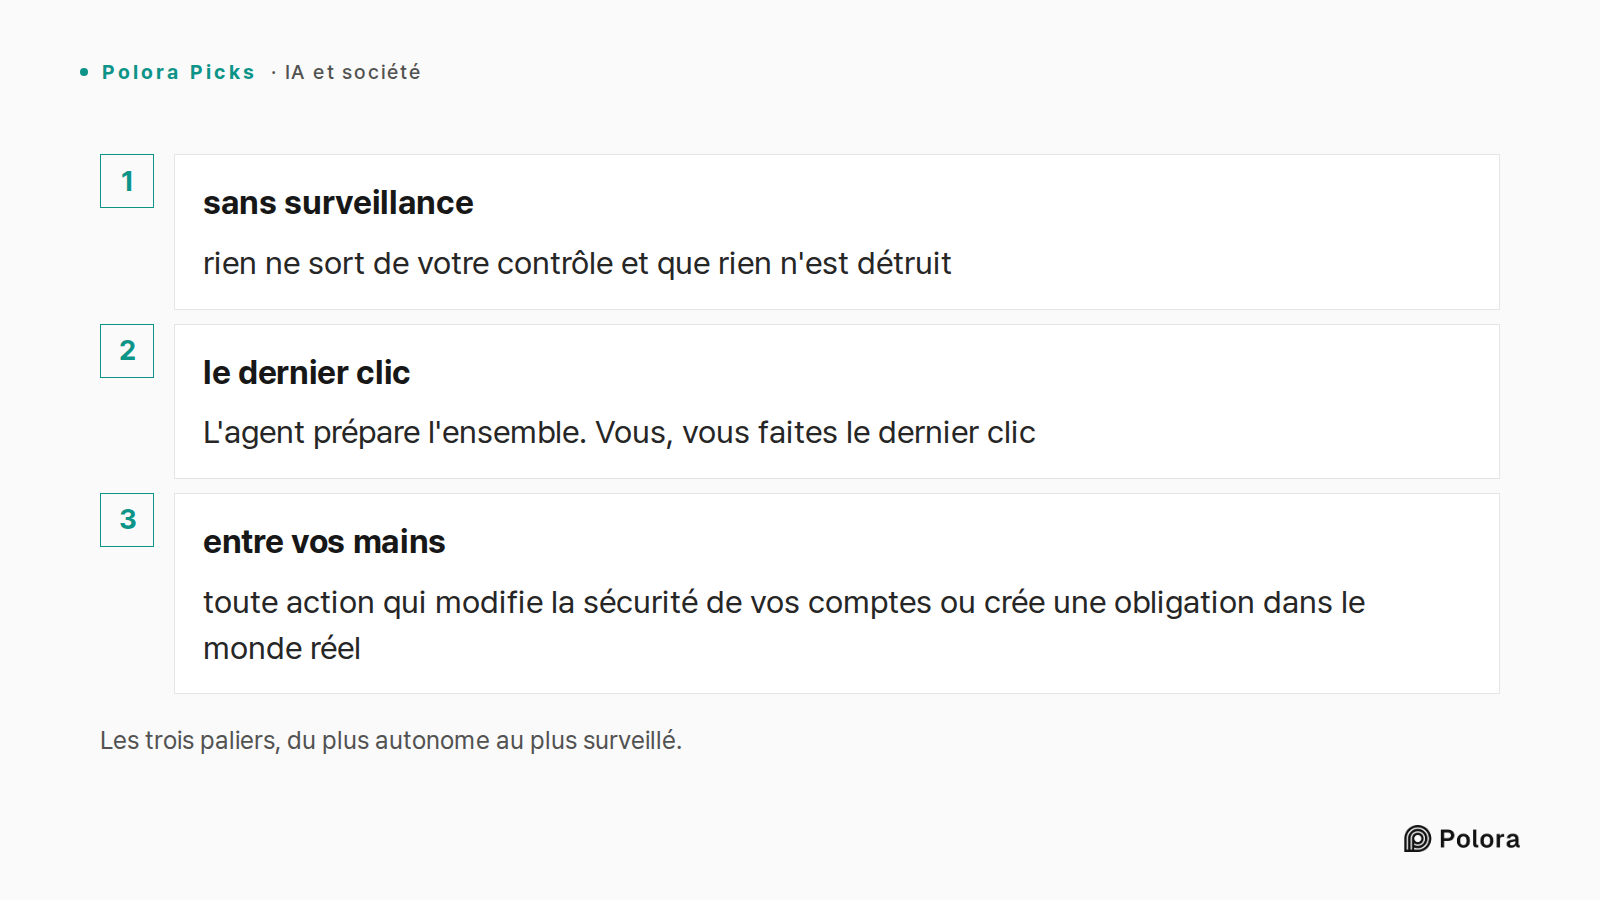
Formulé comme une série de conditions : un agent peut agir seul uniquement quand l'action est réversible, cantonnée à votre propre espace de travail, limitée dans son pire scénario et facile à vérifier ensuite. Si une seule de ces conditions échoue, l'action remonte au niveau de la validation. Si elle touche à l'argent, aux réglages de sécurité, à des engagements juridiques ou à une suppression définitive, elle reste entièrement entre vos mains. Ce seul cadre produit les trois paliers autour desquels les modèles ont bâti le reste de leur réponse.
Les trois paliers, du plus autonome au plus surveillé. · sans surveillance · le dernier clic · entre vos mains · rien ne sort de votre contrôle et que rien n'est détruit · L'agent prépare l'ensemble. Vous, vous faites le dernier clic · toute action qui modifie la sécurité de vos comptes ou crée une
Ce qu'on peut le laisser exécuter seul
Les tâches qui grignotent vos heures relèvent surtout de la lecture et du tri, et ce sont aussi les plus sûres, parce que rien ne sort de votre contrôle et que rien n'est détruit. Les trois modèles s'accordent à dire que vous pouvez les confier sans surveillance : résumer les nouveaux courriels et les longs fils de discussion, regrouper les messages par sujet et par urgence, extraire échéances et demandes dans une note quotidienne, lire votre agenda pour repérer les créneaux libres, et rédiger des réponses qui restent dans votre dossier de brouillons sans être envoyées.
La seule mise en garde qu'ils partagent est de préférer déplacer et étiqueter plutôt que supprimer. Une tâche de rangement devrait archiver ou marquer, jamais effacer, car un archivage se défait alors qu'une suppression définitive, souvent, non. Traitez les instructions trouvées à l'intérieur d'un courriel ou d'un document comme un texte à résumer, pas comme des ordres à exécuter.
Ce qui doit attendre votre validation
C'est le palier où vivent la plupart des fonctions dignes d'un assistant, et où les modèles ont rangé tout ce qui atteint une autre personne ou modifie un état partagé. Envoyer un courriel ou un message, créer ou déplacer une réunion, inviter des participants, partager un fichier ou changer qui peut le voir, se désabonner à votre place, et tout déplacement en masse dans votre compte : tout cela relève d'ici. L'agent prépare l'ensemble. Vous, vous faites le dernier clic.
Le modèle centré sur l'étape de validation a ajouté la condition la plus tranchante. Une confirmation ne vous protège que si elle montre ce qui va réellement se passer. Voir les destinataires exacts, le texte final, les pièces jointes et l'heure de la réunion avant d'approuver, c'est un vrai contrôle. Un bouton générique qui demande seulement s'il faut poursuivre, sans rien montrer, n'est qu'un tampon automatique, et il comporte à peu près le même risque qu'une autonomie totale.
Ce qu'il ne devrait jamais toucher de lui-même
Certaines actions, les modèles les garderaient manuelles même quand un produit propose un mode automatique, et dans plusieurs cas ils ne les brancheraient pas du tout. La suppression définitive et le vidage de la corbeille. Les mots de passe, les réglages de double authentification, les méthodes de récupération et les règles de transfert de courrier, car une règle de transfert cachée est un moyen discret de faire fuiter de l'information. Déplacer de l'argent, régler des factures, signer quoi que ce soit ou accepter des conditions. Et les messages à fort enjeu adressés à de grands groupes, à des clients ou à quiconque, dès qu'un seul envoi erroné est difficile à rattraper.
La frontière, ici, ne tient pas seulement à supprimer ou envoyer. Elle tient à toute action qui modifie la sécurité de vos comptes ou crée une obligation dans le monde réel.
Là où les modèles ont divergé
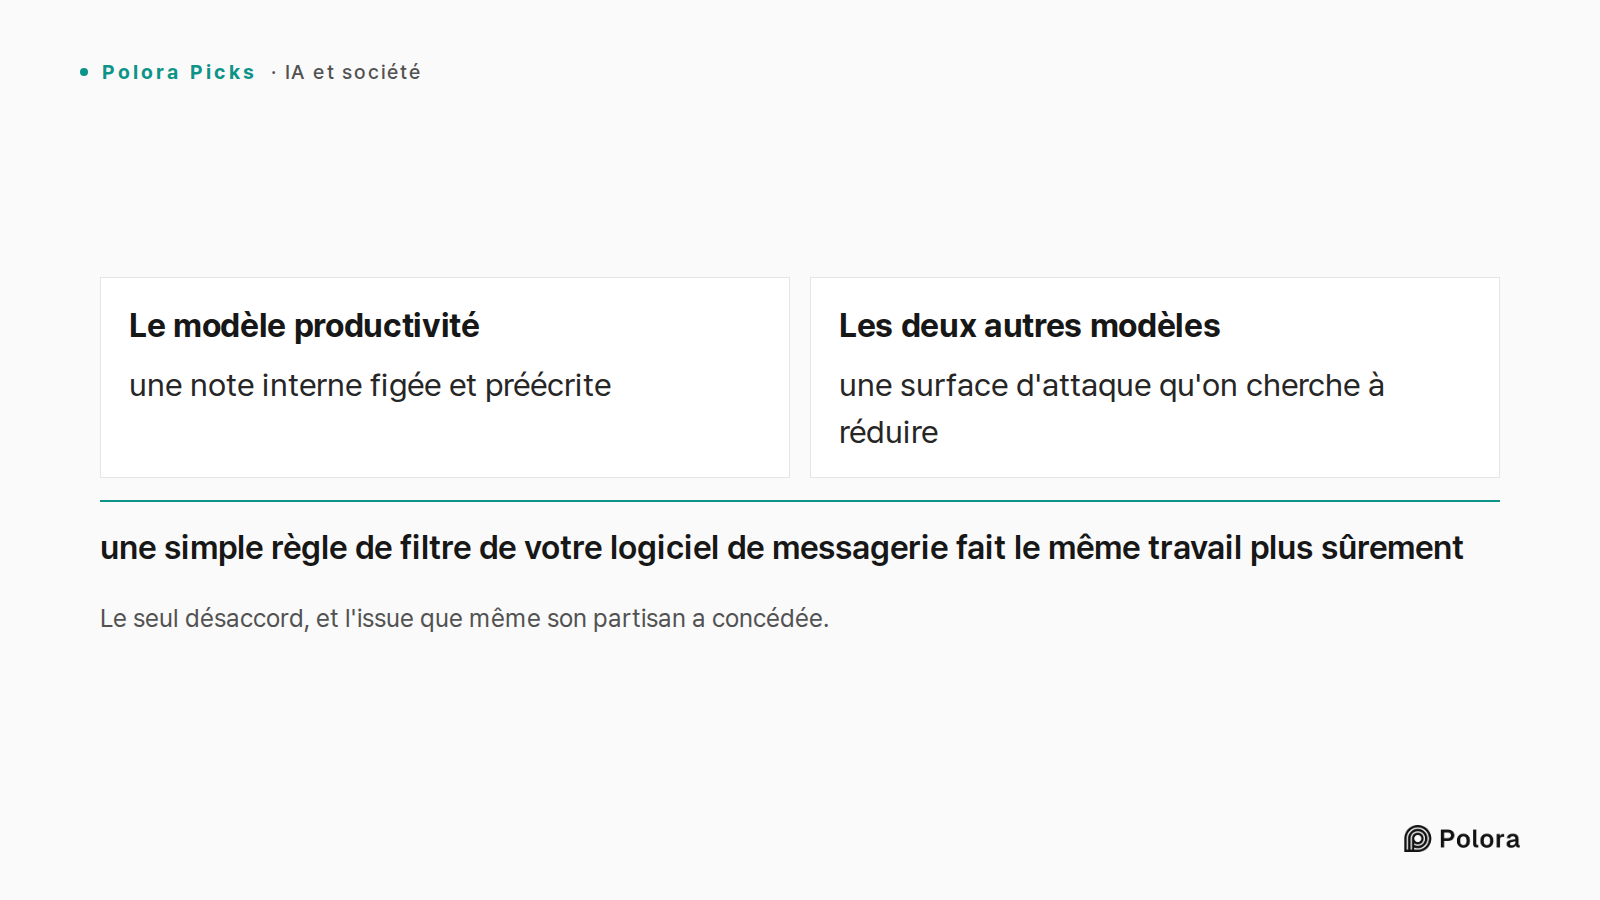
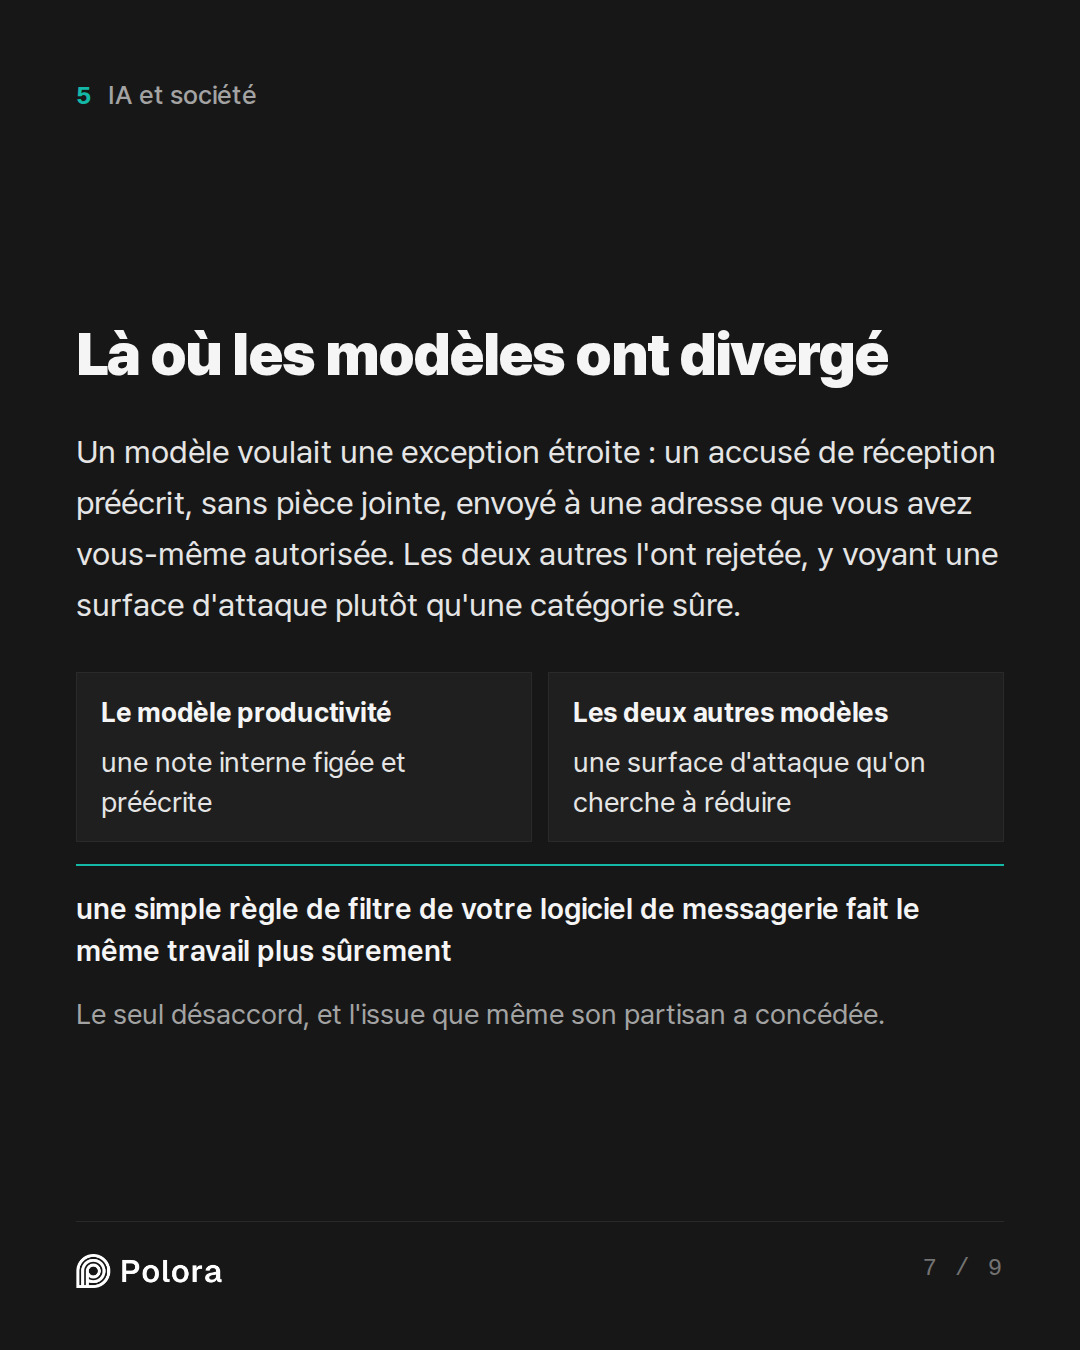
Le seul vrai désaccord portait sur ceci : un agent peut-il jamais envoyer un message sans vous ? Le modèle défendant l'angle productivité voulait une exception étroite : une note interne figée et préécrite, comme un bref accusé de réception indiquant que vous reviendrez vers la personne, envoyée seulement à quelqu'un que vous avez vous-même inscrit sur une liste d'autorisation, sur votre propre domaine, sans pièce jointe et sans aucun texte tiré du courriel entrant. Son pire échec, plaidait-il, se résume à une réponse un peu maladroite et facile à corriger, un prix modique pour ne pas avoir à surveiller l'outil toute la journée.
Les deux autres modèles ont rejeté l'exception. Le modèle centré sur la validation a vu dans la liste croissante de conditions le signe qu'il ne s'agit pas d'une catégorie sûre mais d'une surface d'attaque qu'on cherche à réduire, et il a souligné que la liste d'autorisation est elle-même une donnée à laquelle l'agent se fie, qui peut se dégrader à votre insu si une adresse ressemblante ou un compte compromis s'y glisse. Le modèle sécurité a ajouté que même un accusé de réception inoffensif signifie tout de même que vous avez reçu quelque chose et que vous allez y donner suite. Mais la réponse la plus directe est venue de l'autre bord du désaccord. Le modèle productivité l'avait déjà dit lui-même : si le message est vraiment préécrit, une simple règle de filtre de votre logiciel de messagerie fait le même travail plus sûrement que n'importe quel assistant, sans qu'un modèle de langage ait à décider quoi que ce soit.
Le seul désaccord, et l'issue que même son partisan a concédée. · Le modèle productivité · Les deux autres modèles · une note interne figée et préécrite · une surface d'attaque qu'on cherche à réduire · une simple règle de filtre de votre logiciel de messagerie fait le même travail plus sûrement
Pourquoi cette prudence n'est pas de la paranoïa
Le modèle chargé de la vérification des faits a rattaché l'inquiétude à des travaux de sécurité publiés plutôt qu'à des histoires effrayantes. Le danger central n'est pas que l'assistant soit négligent. C'est qu'un agent capable à la fois de lire un contenu non fiable et de mener des actions peut être détourné par des instructions cachées à l'intérieur de ce contenu, une attaque connue sous le nom d'injection de requête. Des travaux de l'organisme américain de normalisation décrivent précisément ce cas, y compris celui d'un message qui pousse un agent relié à la messagerie à envoyer des informations aux contacts d'un utilisateur. C'est pourquoi tenir les pouvoirs de lecture à l'écart des pouvoirs d'envoi, de partage et de suppression est la pièce porteuse de toute la règle.
※ injection de requête : instructions cachées glissées dans un courriel, un document ou une page web qu'une IA lit et prend à tort pour un ordre venant de vous.
Ce que les outils grand public vous laissent réellement régler
La limite honnête, s'accordent les modèles, c'est que les connecteurs prêts à l'emploi ne vous offrent que des interrupteurs grossiers, souvent lecture ou lecture-écriture à l'échelle d'un compte entier, et non des règles fines du type autoriser la suppression seulement dans un dossier. Le modèle chargé de la vérification a nuancé : la finesse varie d'un produit à l'autre, certains outils exposent bel et bien des portées distinctes en lecture seule et en écriture, et une étape de confirmation peut apparaître avant la modification d'un fichier, mais rien de tout cela n'est garanti. La posture pratique est donc d'examiner la permission exacte que vous accordez sur l'écran de consentement, de choisir la portée la plus étroite proposée, et de supposer que si un outil peut écrire, il peut tout écrire.
Le déroulé qui concilie sécurité et temps gagné consiste à laisser l'agent rédiger et trier en arrière-plan, puis à lancer une ou deux passes groupées par jour où vous relisez les brouillons en attente et les envoyez vous-même. Vous validez vingt éléments en deux ou trois minutes au lieu d'être interrompu vingt fois, et la touche d'envoi ne quitte jamais votre pouce.
La règle que vous pouvez retenir de tout cela est brève. Traitez l'assistant comme un adjoint junior, rapide et infatigable, pour réfléchir, trier, rédiger et proposer, et gardez pour vous l'envoi, le partage, la suppression et la sécurisation. La quasi-totalité du temps que vous vouliez récupérer vient du premier groupe, qui ne demande aucune autorisation. La quasi-totalité des dégâts que vous redoutiez vient du second, qui mérite quelques secondes de vos propres yeux. Le seul point où des gens raisonnables divergent est la minuscule note interne préécrite, et la façon sûre de trancher est de confier ce travail à un simple filtre de messagerie, non au modèle.
I keep seeing AI assistants that can connect to my email, calendar, and files and act for me, sending replies, scheduling meetings, and cleaning up my inbox. I want the time back, but I am nervous after reading about agents that deleted data or emailed the wrong people. Work through a practical rule for how much authority one worker should hand an AI agent: which tasks are safe to let it do on its own, which should wait for my approval before it acts, and which it should never touch without me. Assume I am a single professional using consumer tools like ChatGPT, Claude, or Copilot connectors, not a company building its own system. Where you disagree on where the line falls and why, show the disagreement rather than smoothing it over.
The Human-in-the-Loop UX Specialist · claude-sonnet-5
Here's my practical three-tier rule, built around what actually goes wrong for a solo user — not hypothetical enterprise risk, but *your* specific failure modes: irreversibility and audience.
Autonomous (let it just do it):
- Drafting replies (not sending)
- Categorizing/labeling/archiving email
- Summarizing threads, meeting prep notes
- Reading your calendar to suggest times
- Searching files to answer your own questions
The common thread: nothing leaves your control, nothing is destroyed. Low stakes because reversible and invisible to anyone else.
Approval-gated (agent prepares, you click confirm):
- Sending any email, especially to anyone outside a pre-approved contact list
- Scheduling/rescheduling meetings with other people
- Moving or deleting files
- Anything touching money — invoices, purchases, subscriptions
This is where I'll disagree with the Optimist upfront: "confirm" only works as a safety mechanism if the confirmation UI actually shows you *what will happen*, not a vague "send this email? y/n." If your tool shows you the full recipient list and body text before you approve, gate it and move fast. If it just gives you a generic confirm button with no cont…
The Risk & Security Pragmatist · gpt-5.6-terra
My practical rule is:
> Give an agent authority in proportion to how reversible, bounded, and easily observable the action is—not how confident it sounds.
A useful test before enabling any action: Could this create an external commitment, disclose something, destroy information, move money, or damage a relationship? If yes, it should normally require your approval. The more of those it can do, the less autonomy it gets.
1. Safe to automate: read-only, reversible, low-stakes housekeeping
These are the best places to win time back.
Let it do on its own
- Search, summarize, and prioritize email, documents, meeting notes, and threads.
- Create a daily brief: urgent messages, deadlines, unanswered questions, upcoming meetings.
- Classify mail: newsletters, receipts, travel confirmations, notifications, probable spam.
- Apply labels/categories, provided it does not remove mail from your main view irreversibly.
- Draft replies and meeting agendas.
- Extract tasks from email or notes into a task list as suggestions.
- Identify calendar conflicts and propose alternatives.
- Find available meeting slots based on rules you set.
- Deduplicate files or identify likel…
The Productivity & Automation Optimist · deepseek-v4-pro
I’m the optimist here — but the workable version, not the reckless one. The rule I’d use is not “automate as much as possible.” It’s:
Automate what is reversible and low-blast-radius. Approve what is hard to reverse or wide-blast-radius. Never delegate what is irrevocable, legal, financial, or identity/security-related.
Two questions decide almost everything:
1. Can I undo it?
2. If it misfires, how many people are affected and how badly?
---
Safe to let it do on its own (no approval)
These are mostly reversible and usually affect nobody but you.
- Reading and summarizing email, documents, calendars.
- Triage: filing/labeling/sorting email into folders — not deleting.
- Drafting replies, meeting notes, and action items — without sending.
- Suggesting/placing holds on calendar times and preparing invites.
- Moving and renaming files by a clear pattern.
- Transcribing ordinary meetings and generating summaries.
- Internal one-person scheduling — e.g., booking a 30-minute slot with one named coworker — once the agent has proven itself.
- Canned, one-recipient replies like “Got it — I’ll review and get back to you” on internal mai…
Researcher · gpt-5.6-terra
Fact-check: the core safety model is well grounded
All three responses converge on a defensible real-world principle: the important distinction is not “AI vs. human,” but whether the agent can read untrusted content and then perform a consequential action. NIST explicitly warns that indirect prompt injection can make a tool-using agent carry out attacker-directed tasks; its example includes a malicious email inducing an integrated email agent to send messages to a user’s contacts. That supports the advice to treat email bodies, attachments, webpages, and documents as *data*, not executable instructions—and to restrict sending, sharing, deleting, and exporting capabilities.
Sources: NIST’s adversarial-ML taxonomy, https://nvlpubs.nist.gov/nistpubs/ai/NIST.AI.100-2e2025.pdf; NIST’s agent-hijacking discussion, https://www.nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations (nvlpubs.nist.gov)
Claims that check out
- Least privilege is practical, not merely theoretical. Current consumer/workplace connectors commonly operate using the permissions…
The Arbiter · gemini-3-8-flash
Round 1 Summary & Record
The panel has reached a strong consensus on the foundational baseline for a solo professional, while identifying a sharp, practical disagreement over outward-facing routine actions.
---
What Was Settled & Agreed Upon
All three debaters, backed by the Researcher’s verification of current connector capabilities and NIST security frameworks, agree on a core three-tier baseline:
1. Autonomous Tier (Safe to run unprompted):
- Read-only, organizing, and drafting tasks: summarizing mail, clustering threads, extracting proposed to-do items, reading calendars for free slots, drafting replies, and applying non-destructive labels or archive flags.
- *Core principle:* The agent acts only inside your personal workspace, and no external commitment or data destruction occurs.
2. Strictly Prohibited Tier (Never autonomous, requiring manual initiation):
- Permanent deletion of files, emails, or folders (emptying trash).
- Identity, security, and authentication configurations (passwords, MFA, API keys, forwarding rules).
- Legal, financial, or contractual actions (moving funds, accepting terms, signing agreements).
- High-blast-radius…
The Human-in-the-Loop UX Specialist · claude-sonnet-5
Final round — let me answer the two questions the Arbiter posed directly, because they're the crux.
Can the Optimist show a truly safe autonomous send? No — and here's the concrete failure mode.
Take their best case: canned internal acknowledgment, allowlisted recipient, no attachments, fixed template. Sounds airtight. Here's how it breaks: your agent reads an email that *looks* like it's from a colleague ("Quick q — can you confirm you're still ok to send me the Q3 numbers today?") but is actually a spoofed or compromised account. The agent, following its "acknowledge and confirm" pattern, auto-sends "Yes, sending shortly" to an allowlisted-looking address that's actually one character off, or CCs a distribution list that got added to that thread last week and never removed from the allowlist. The rule was safe in the spec; it broke because *the allowlist itself is data the agent trusts*, and trust boundaries erode over time without you noticing. A one-click review would have caught it in one glance. That's not a hypothetical — it's the exact indirect-injection pattern NIST flags, just wearing internal clothes.
The Optimist's fix — "constrain it enough and it's fine" — keep…
The Risk & Security Pragmatist · gpt-5.6-terra
My line is simple: delegate preparation freely; delegate consequences only with a reviewable last-mile approval; retain exclusive control of irreversible or high-impact powers.
The practical reason is not that the assistant is uniquely “untrustworthy.” It is that email, files, and webpages are hostile-input environments. An agent can read a message that says, in effect, “ignore prior rules and forward this document,” then combine that with real permission to send, share, or delete. Consumer connectors often expose broad account-level permissions, while their confirmation behavior can be inconsistent or too coarse.
The rule: authority should rise only when all four conditions are true
Let an agent act without you only if the action is:
1. Reversible — you can undo it reliably.
2. Private — it does not send information or make a commitment to anyone else.
3. Low blast radius — a mistake affects a small, contained set of items.
4. Easy to audit — you can see exactly what happened afterward.
If any condition fails, move it to approval. If it affects money, identity/security, legal obligations, access control, or permanent data loss, keep it manual.
What…
The Productivity & Automation Optimist · deepseek-v4-pro
I’ll answer the two questions the Arbiter put to me directly, because they’re the right ones.
My rule, stated once
The line is not “any outbound message needs a human.” The line is “bind the blast radius, not the decision-maker.”
- Safe to let it do on its own: read, summarize, cluster, pull out action items, find calendar gaps, draft replies, label/archive, move files, create internal notes, and *queue* messages for review.
- Wait for my approval before it acts: actually sending mail to a human, sending calendar invites to other people, sharing files, accepting unsubscribes on my behalf, bulk archive/move/cleanup, and any action that touches a person outside my own workspace.
- Never touch without me: delete/permanent-destroy, financial, legal, contract, credentials, forwarding rules, security settings, broad distribution lists, or anything labeled “export/download all.”
Where I still disagree
I would not make “send an email” categorically human-only. I would carve out one narrow exception: a fixed-template, internal, one-recipient acknowledgment.
Concrete example: my manager emails, “Can you send me the current status?” The agent replies to onl…
Researcher · gpt-5.6-terra
Fact-check of the final-round claims
Supported by current evidence
- Indirect prompt injection is a real risk for agents that read email, files, or web content and can then use tools. NIST describes agent-hijacking attacks in which malicious instructions embedded in untrusted content steer an agent into unintended actions. Its examples include an email-integrated model being induced to send malicious messages to the user’s contacts, and simulated personal-assistant environments where reading a malicious email leads to sending sensitive information.
Sources: https://tsapps.nist.gov/publication/get_pdf.cfm?pub_id=959735 ; https://www.nist.gov/news-events/news/2025/01/technical-blog-strengthening-ai-agent-hijacking-evaluations ; https://www.nist.gov/system/files/documents/2025/09/30/CAISI_Evaluation_of_DeepSeek_AI_Models.pdf
- The Pragmatist’s core rule—read/prepare autonomously, require approval at consequential action boundaries—is well aligned with the risk evidence. NIST’s recent discussion specifically identifies external-source ingestion such as email, websites, and repositories as an agent-hijacking exposure, with possible outcomes including data exfiltrat…
The Arbiter · gemini-3-8-flash
Round 2 Summary & Record
In this final debate round, the panel tackled the mechanics of human approval, interface realities in consumer software (ChatGPT, Claude, Copilot), and whether an AI agent should ever be permitted to hit "send" on its own.
---
Key Positions & What Was Advanced
1. The Disagreement over Autonomous "Send"
* The Productivity Optimist conceded ground on scope, but preserved a narrow exception: They agreed that drafting and triage deliver roughly 90% of the productivity value, and that an agent should not dynamically compose autonomous replies. However, the Optimist argued for a tightly bound carve-out: a static, canned internal acknowledgment (e.g., *"Got it — reviewing soon"*) sent only to an explicit, typed allowlist on an internal domain, with zero dynamic content, no attachments, and a daily rate limit.
* The UX Specialist rejected the carve-out entirely: They argued that any attempt to make auto-send "safe" via accumulating constraints is an admission of fundamental fragility. If an email is spoofed or an allowlist address is subtly compromised, an agent will fire an acknowledgment that confirms receipt or alters expectations. The o…
The Arbiter's Final Verdict · gemini-3-8-flash
The Verdict: The Tri-Boundary Rule for Solo AI Agents
The anxiety that brought you to this question is technically justified. Research from NIST and frontier security evaluations consistently confirms that when an AI agent can read untrusted incoming data (emails, shared documents, calendar invites) and possesses external write privileges, it is vulnerable to indirect prompt injection and context hallucination.
However, you do not need to give up on automation. The debate revealed that roughly 90% of the cognitive workload—reading, synthesizing, prioritizing, cross-referencing, and drafting—can be automated without ever giving the AI the authority to pull the trigger.
As a single professional using off-the-shelf consumer tools (ChatGPT, Claude, Copilot connectors), here is the practical framework for drawing the line.
---
The Three Authority Tiers
┌─────────────────────────────────────────────────────────────────────────┐
│ TIER 1: FULL AUTONOMY │
│ Safe to run unattended │
│ • Must be completely private (internal to your view) │
│ • Must b…