La promesse est facile à vendre. Vous accordez un long entretien, une IA apprend votre façon de parler et de travailler, et à partir de là une version de vous peut répondre aux questions à votre place, si bien que plus personne n'a besoin de vous déranger. Une étude récente a construit exactement ce genre de doublure, puis l'a confrontée aux personnes dont elle était la copie. Le constat est net et un peu décevant : les copies ressemblaient au groupe, mais pas à l'individu.
Les chercheurs qualifient leurs agents de « calibrés sur la distribution mais imprécis sur l'identité ». En clair, tout un ensemble de ces agents reproduisait à peu près le mélange d'opinions produit par un vrai groupe, alors que chaque agent pris isolément était une doublure peu fiable de l'unique personne dont il s'inspirait. Pour comprendre ce que cela signifie, Polora a posé la même question à plusieurs modèles d'IA conçus par des entreprises différentes et leur a fait examiner l'étude ensemble.
Ce que l'étude a mesuré
Le dispositif était simple. 51 travailleurs du savoir aux États-Unis, tous dans des métiers où l'on manipule beaucoup de documents, ont chacun accordé un entretien approfondi sur leur façon de travailler, prévu pour 90 minutes et donnant en moyenne environ 43 minutes de parole enregistrée. À partir de chaque transcription, les chercheurs ont construit un agent personnel, à l'aide d'un procédé qui conserve l'entretien, en extrait les parties utiles quand une nouvelle question se présente, et confie à un modèle de langage le soin de raisonner et de répondre comme ce participant.
Ensuite, les personnes et leurs agents ont évalué les quatre mêmes outils d'IA imaginés pour travailler avec des documents : un qui répond à des questions en parcourant de nombreux fichiers, un qui met en évidence les passages clés, un qui transforme les documents en audio, et un qui exécute seul des tâches en plusieurs étapes. Chacun a été noté sur des critères simples d'utilité, de facilité d'usage et de disposition à l'adopter ou à le recommander, avec en parallèle des commentaires écrits libres. Les personnes ont repassé le même test trois jours plus tard, ce qui a donné à l'étude un point de repère sur la constance d'une personne avec elle-même. La vérification centrale était directe : comparer les réponses de chaque agent à celles de la personne même dont il avait été tiré.
Le groupe collait, la personne non
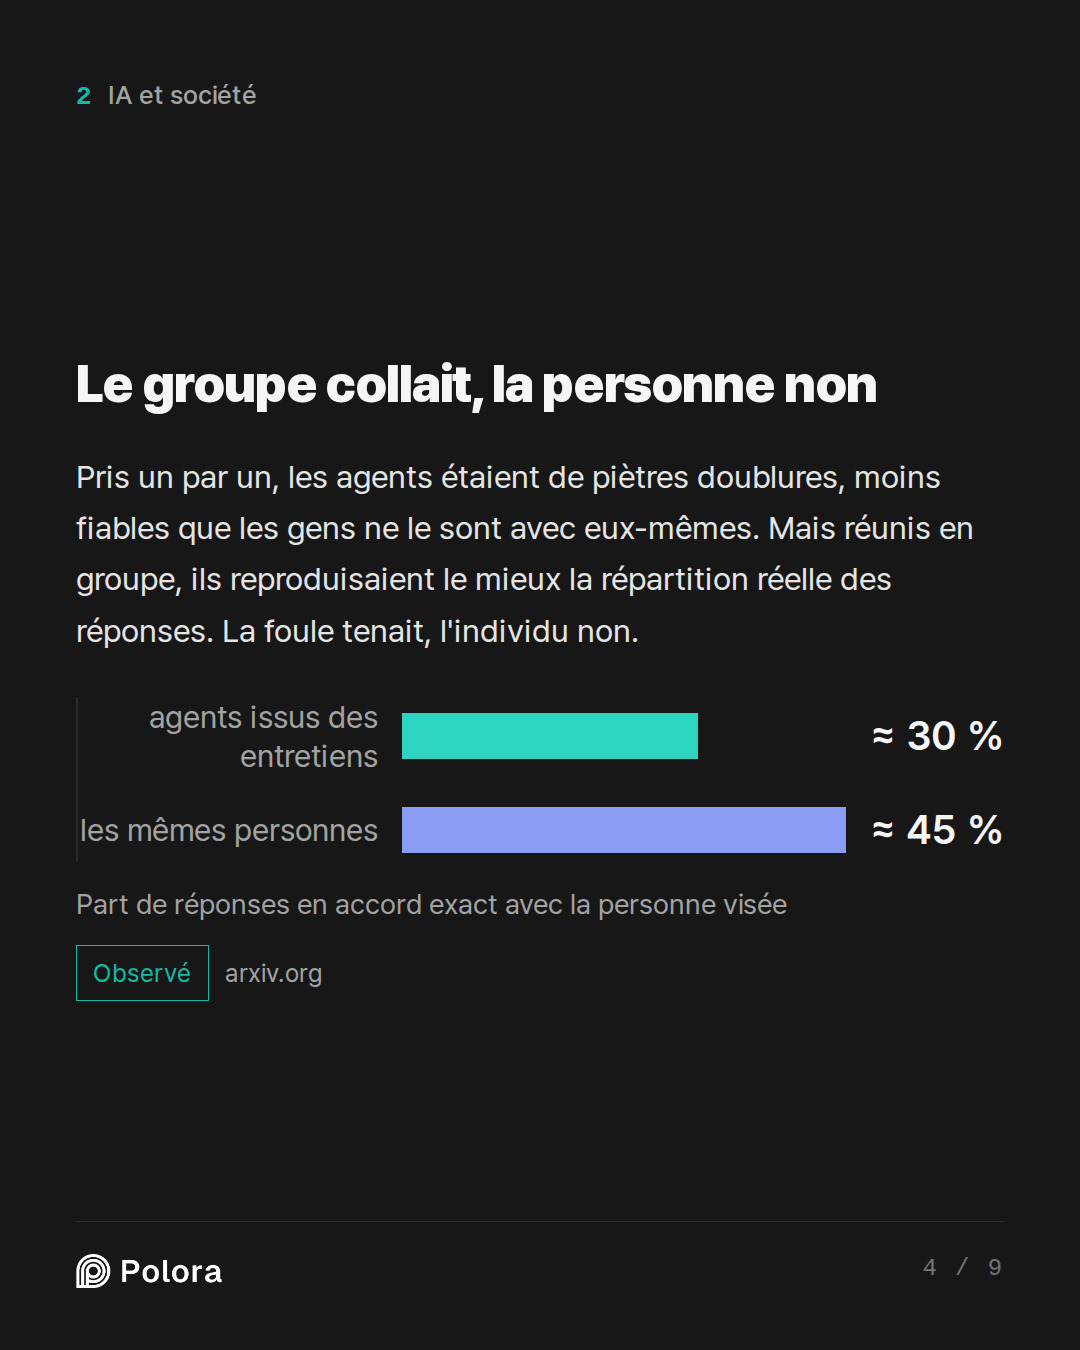
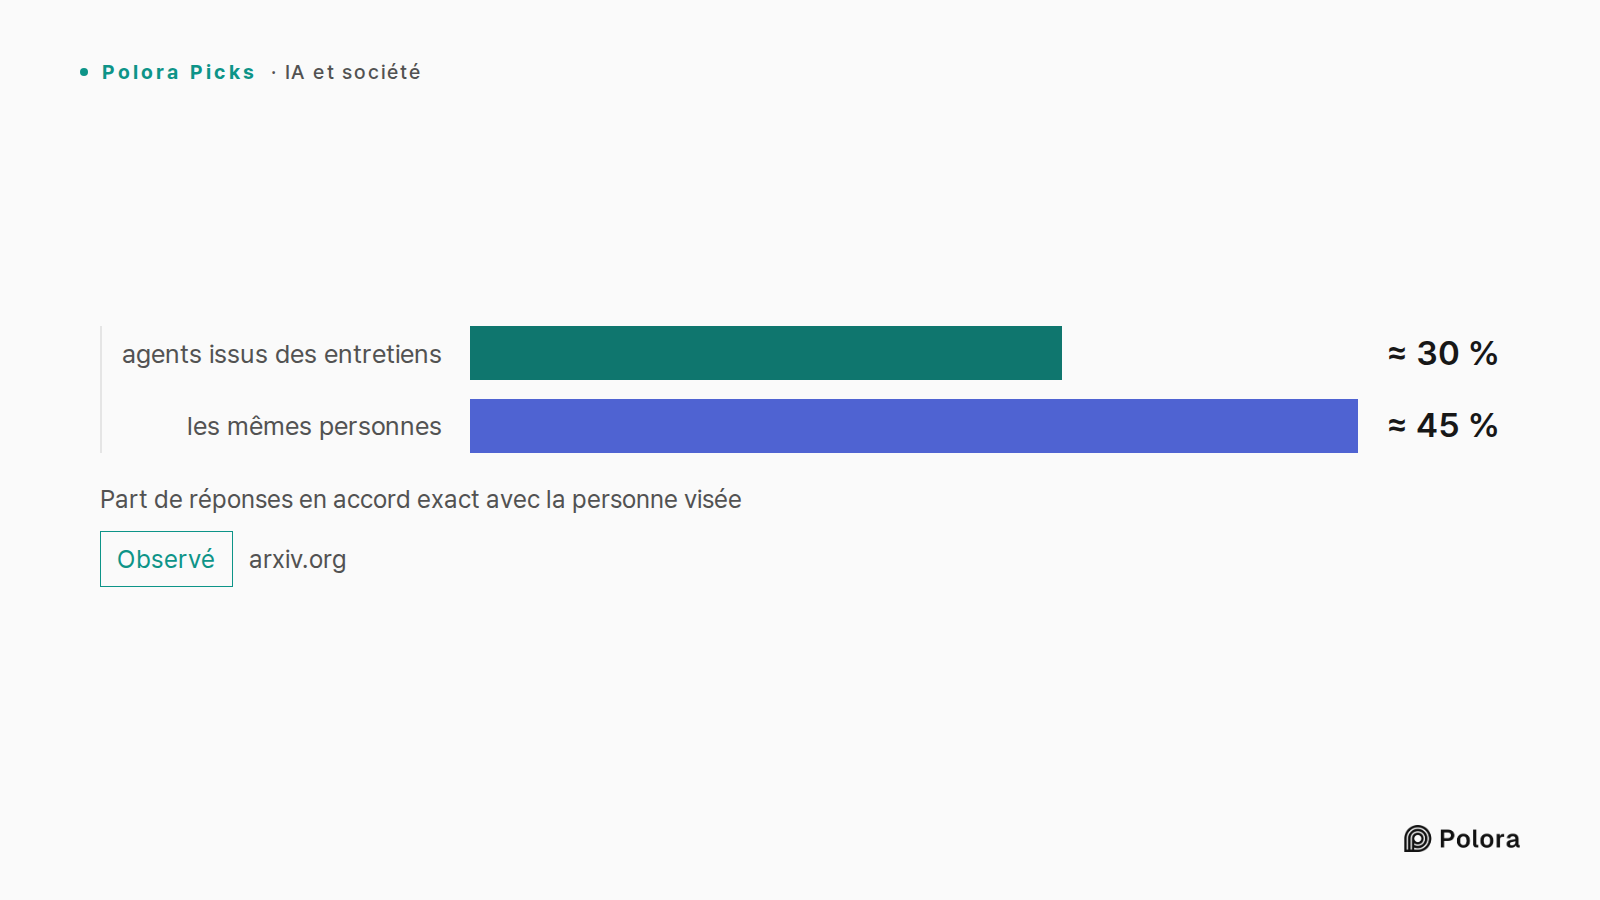
À l'échelle de l'individu, les agents étaient faibles. Sur l'accord exact avec leur propre humain, les agents issus des entretiens tombaient juste dans environ 30 % des cas, contre à peu près 45 % lorsque les mêmes personnes se contentaient de répondre à nouveau quelques jours plus tard. L'étude présente cela comme environ 67 % de la constance humaine, soit 30 divisé par 45, et non 67 % de réponses correctes. Fournir à l'agent l'entretien complet n'aidait presque pas : il ne faisait pas nettement mieux qu'un agent doté de quelques données démographiques seulement, ou même qu'un agent à qui l'on ne donnait rien du tout.
À l'échelle du groupe, le tableau s'inversait. Dès qu'on cessait de demander qui avait dit quoi pour ne regarder que la répartition d'ensemble des réponses, les agents issus des entretiens étaient les plus proches de la répartition réelle. Ils étaient la seule version à reproduire ne serait-ce qu'un peu les notes basses et sans enthousiasme. Un agent privé de toute information personnelle se rabattait sur une réponse prudente par défaut, plaçant la plupart de ses notes en haut de chaque échelle. Ainsi le groupe d'agents ressemblait à un vrai groupe, tandis qu'aucun agent pris à part ne ressemblait à sa vraie personne.
Pourquoi coller au groupe, ce n'est pas coller à vous
Imaginez dix personnes, cinq qui aiment un concept et cinq qui le rejettent. Une simulation pourrait reproduire ce partage cinq contre cinq à la perfection tout en se trompant sur chaque personne prise une à une. L'histogramme est juste et chaque pronostic individuel est faux. C'est une illustration, non une affirmation que les agents auraient littéralement inversé tout le monde, mais cela montre comment une répartition correcte peut masquer un tas d'erreurs individuelles. La moyenne laisse les erreurs se compenser.
Plusieurs explications ordinaires cadrent avec ce qui s'est passé. Un entretien saisit une partie du monde de quelqu'un, pas toutes les conditions qui décident d'une réaction. Les jugements sur un outil qu'on n'a jamais touché se construisent souvent sur le moment, ils ne se lisent pas dans un jeu de préférences déjà arrêté. Là où le témoignage est mince, un modèle comble le vide par un raisonnement plausible et générique qui sonne comme un travailleur type plutôt que comme celui-ci. Connaître la forme d'un groupe ne garantit presque rien sur l'un de ses membres en particulier.
Là où le lissage se voit
Les réponses écrites rendent l'écart concret. Pour l'outil audio, personnes et agents soulevaient les mêmes inquiétudes de premier plan : l'exactitude, la confidentialité, l'intégration aux logiciels déjà en place. Mais environ 30 % des vraies personnes rejetaient l'idée d'emblée, certaines disant qu'elles ne l'utiliseraient en aucun cas, alors qu'un seul agent opposait un refus aussi net. Les personnes nommaient des obstacles précis, comme le fait de travailler sur un ordinateur plutôt que sur un téléphone, ou le besoin de lire un document plutôt que de l'entendre, ou encore une règle de conformité dans leur entreprise. Les agents avaient tendance à reformuler ces refus catégoriques en problèmes qu'une amélioration pourrait résoudre.
Cette différence compte, car « je l'adopterais s'il s'améliorait » n'est pas la même réponse que « cela ne convient pas à mon travail ». Les agents obtenaient aussi leurs moins bons résultats sur la voix et le ton, produisant une prose bien rangée là où les personnes s'exprimaient de façon désordonnée, hésitante, parfois contradictoire. Une réserve s'impose ici : ces comparaisons qualitatives ont été notées par des juges IA qui ne s'accordaient que modérément entre eux, elles sont donc un appui, pas un verdict définitif.
Ce que cela veut dire pour une copie de vous-même
Si un fournisseur ou une équipe de recherche vous propose un personnage bâti à partir de votre propre entretien en affirmant qu'il peut vous représenter, cette étude invite à la prudence. La lecture la plus sûre est que ses nouvelles réponses sont des prédictions à votre sujet, pas des déclarations de votre part. Un vocabulaire familier et des références à votre métier montrent qu'il s'est servi de ce que vous avez fourni. Ils ne montrent pas que ses conclusions vous représentent.
En pratique, cela veut dire qu'on ne doit pas se fier à un personnage bâti à partir de vos mots pour reproduire vos refus, pour expliquer pourquoi vous hésiteriez, ou pour juger comment un outil s'intégrerait à votre travail réel. Il ne doit pas consentir à votre place, décider à votre place, ni être cité comme votre avis. Toute réponse qui serait utilisée comme si vous l'aviez dite doit vous revenir pour confirmation.
Là où cela rapporte, et là où cela ne rapporte pas
Il reste un usage réel, mais étroit. Parce qu'un groupe de ces agents ressemble à un vrai groupe, il peut servir de premier filtre peu coûteux : trier de nombreux concepts encore bruts avant de dépenser pour des prototypes, comparer de grandes directions comme plus d'automatisation contre plus de contrôle, ou produire des objections et des questions à emporter dans une vraie étude. L'étude chiffre le coût de fonctionnement bien en dessous d'une séance humaine, environ 1,27 dollar contre à peu près 12,50 dollars, même s'il n'est pas tout à fait clair que les deux montants portent sur la même unité de travail.
Là où cela n'a pas sa place, c'est partout où le travail consiste à être une personne précise. Il ne peut pas parler pour un participant nommé, établir les freins d'une personne à la confiance ou à l'adoption, remplacer les entretiens quand ce sont justement les détails du travail qui comptent, ni transformer un commentaire généré en témoignage client. Même l'usage comme filtre s'accompagne d'un avertissement : coller à la répartition des réponses d'aujourd'hui ne prouve pas que les agents classeraient correctement les concepts de demain, cela reste donc une idée prometteuse plutôt qu'une démonstration.
Une étude, pas un verdict
Il s'agit d'une seule étude, propre à un domaine : 51 travailleurs du savoir américains, quatre outils documentaires imaginés, une seule manière de construire les agents. Elle ne prouve pas qu'une simulation personnelle fidèle est impossible, et de meilleures méthodes pourraient resserrer l'écart. Ce qu'elle fait, c'est déplacer la charge de la preuve au bon endroit. Ancrer un agent dans vos mots n'est pas la même chose que le faire tenir votre place, et cette seconde prétention doit désormais être démontrée, pas supposée.
La règle de travail qui en découle est simple. Servez-vous d'un groupe de ces agents quand vous n'avez besoin que du groupe, pour un signal d'ensemble rapide et grossier. Servez-vous de vraies personnes pour tout ce qui doit être une personne particulière, y compris vos propres décisions sur un outil qui viendrait s'installer au cœur de votre travail.