D'où vient l'idée qu'une perte fait deux fois plus mal ?
Imaginez deux journées. La première, vous trouvez 100 dollars que vous n'attendiez pas. La seconde, vous perdez 100 dollars. La plupart des gens disent que la seconde journée leur reste plus longtemps en tête, et l'explication répandue y ajoute un chiffre : une perte ferait environ deux fois plus mal qu'un gain égal ne fait plaisir.
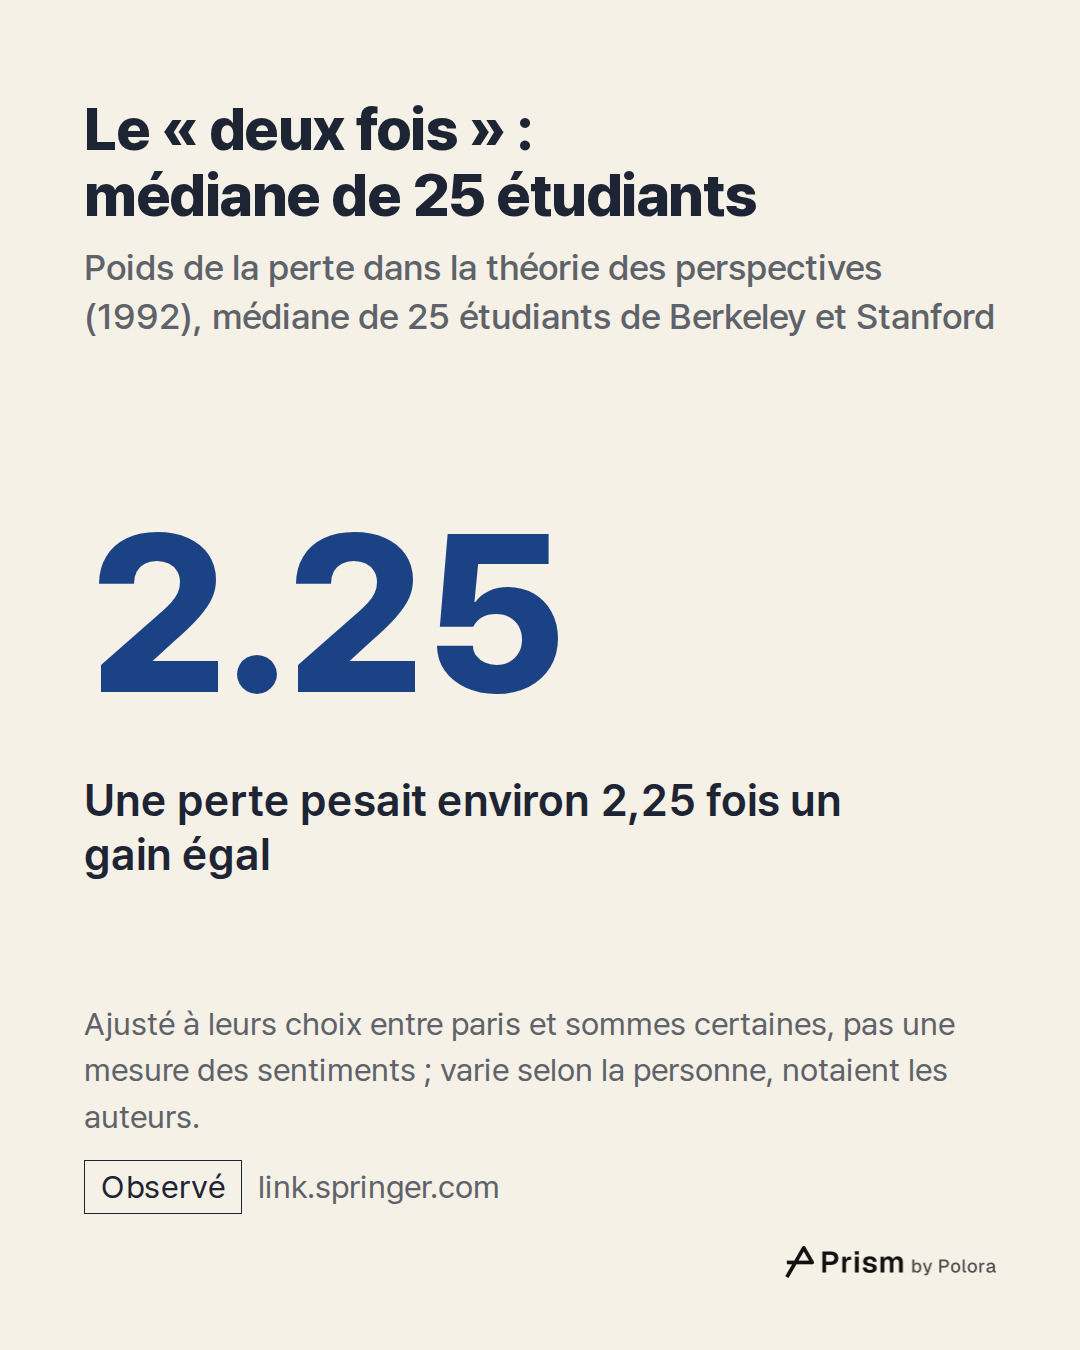
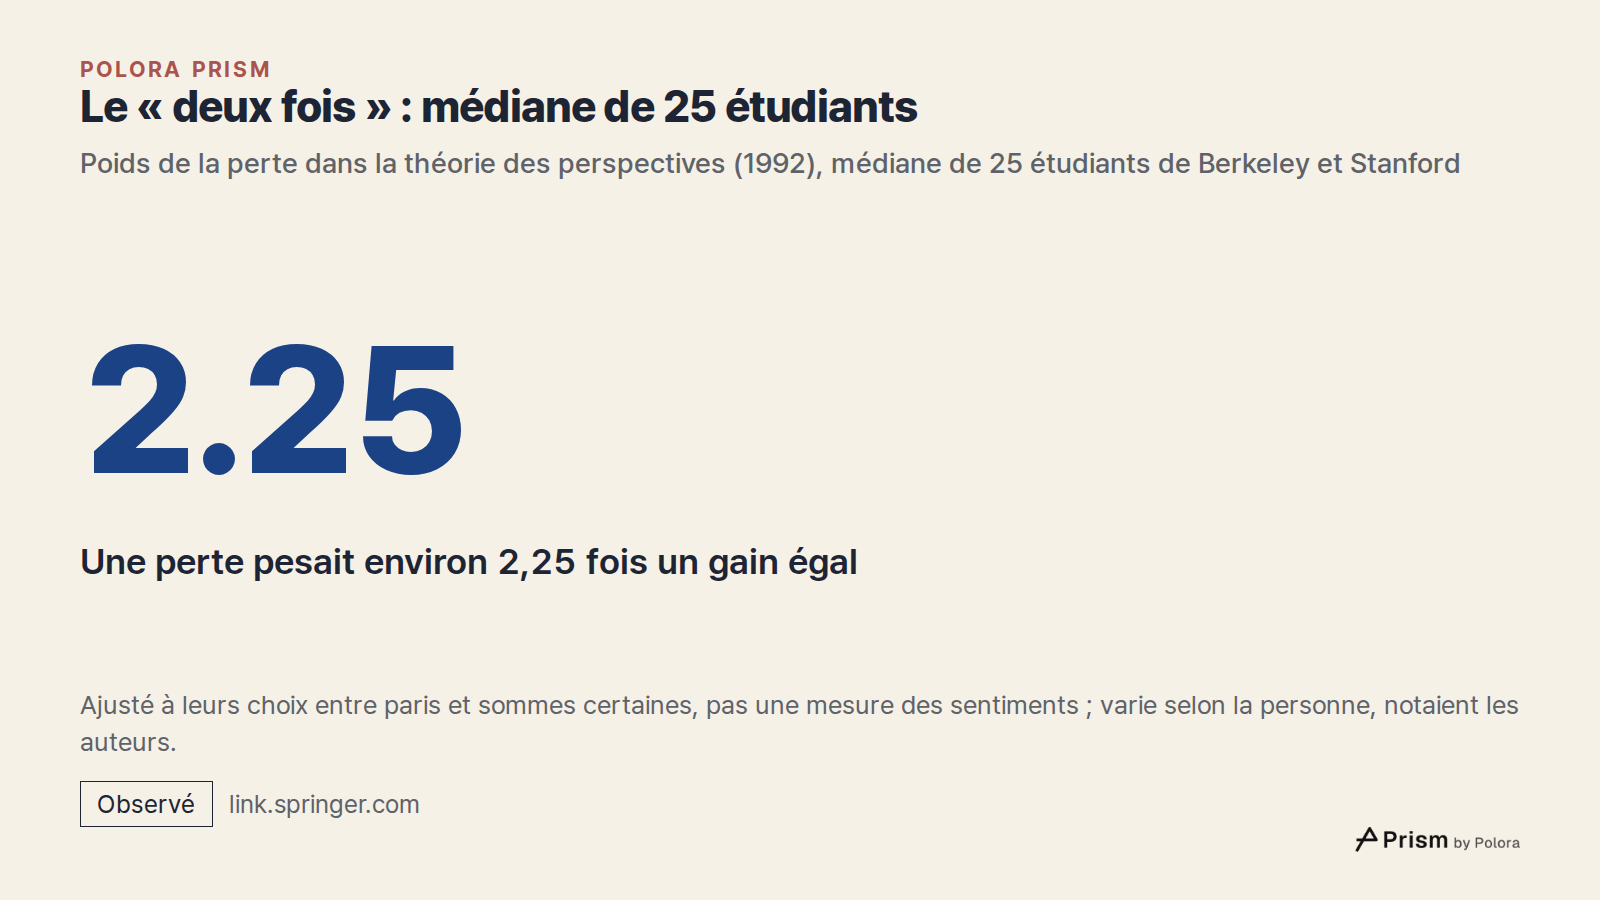
Ce chiffre a une origine précise. En 1979, les psychologues Daniel Kahneman et Amos Tversky ont proposé la théorie des perspectives, qui décrit la façon dont les gens choisissent réellement quand l'issue est incertaine (Econometrica, 1979). En 1992, ils l'ont affinée et l'ont ajustée aux choix de 25 étudiants de troisième cycle de Berkeley et de Stanford. Payés chacun 25 dollars pour participer, ces étudiants devaient choisir entre des paris et des sommes d'argent certaines (Journal of Risk and Uncertainty, 1992). La médiane de leurs estimations était de 2,25 : dans le modèle ajusté aux choix de ce groupe, une perte pesait environ 2,25 fois plus lourd qu'un gain de même montant.
Le « deux fois » est donc la médiane d'un petit groupe, obtenue dans des conditions précises. Les auteurs eux-mêmes notaient que la courbe varie d'une personne à l'autre. Enfin, ce chiffre est tiré d'un modèle des choix de ces étudiants. Il n'a jamais mesuré ce que ressent une personne en particulier, ni ce que ressentent les gens en général.
- Kahneman and Tversky (1979), Prospect theory : an analysis of decision under risk, Econometrica
- Kahneman and Tversky (1979), Prospect theory, full text
- Tversky and Kahneman (1992), Advances in prospect theory, Journal of Risk and Uncertainty
- Tversky and Kahneman (1992), Advances in prospect theory, full text
Que montre vraiment la célèbre courbe des pertes et des gains ?
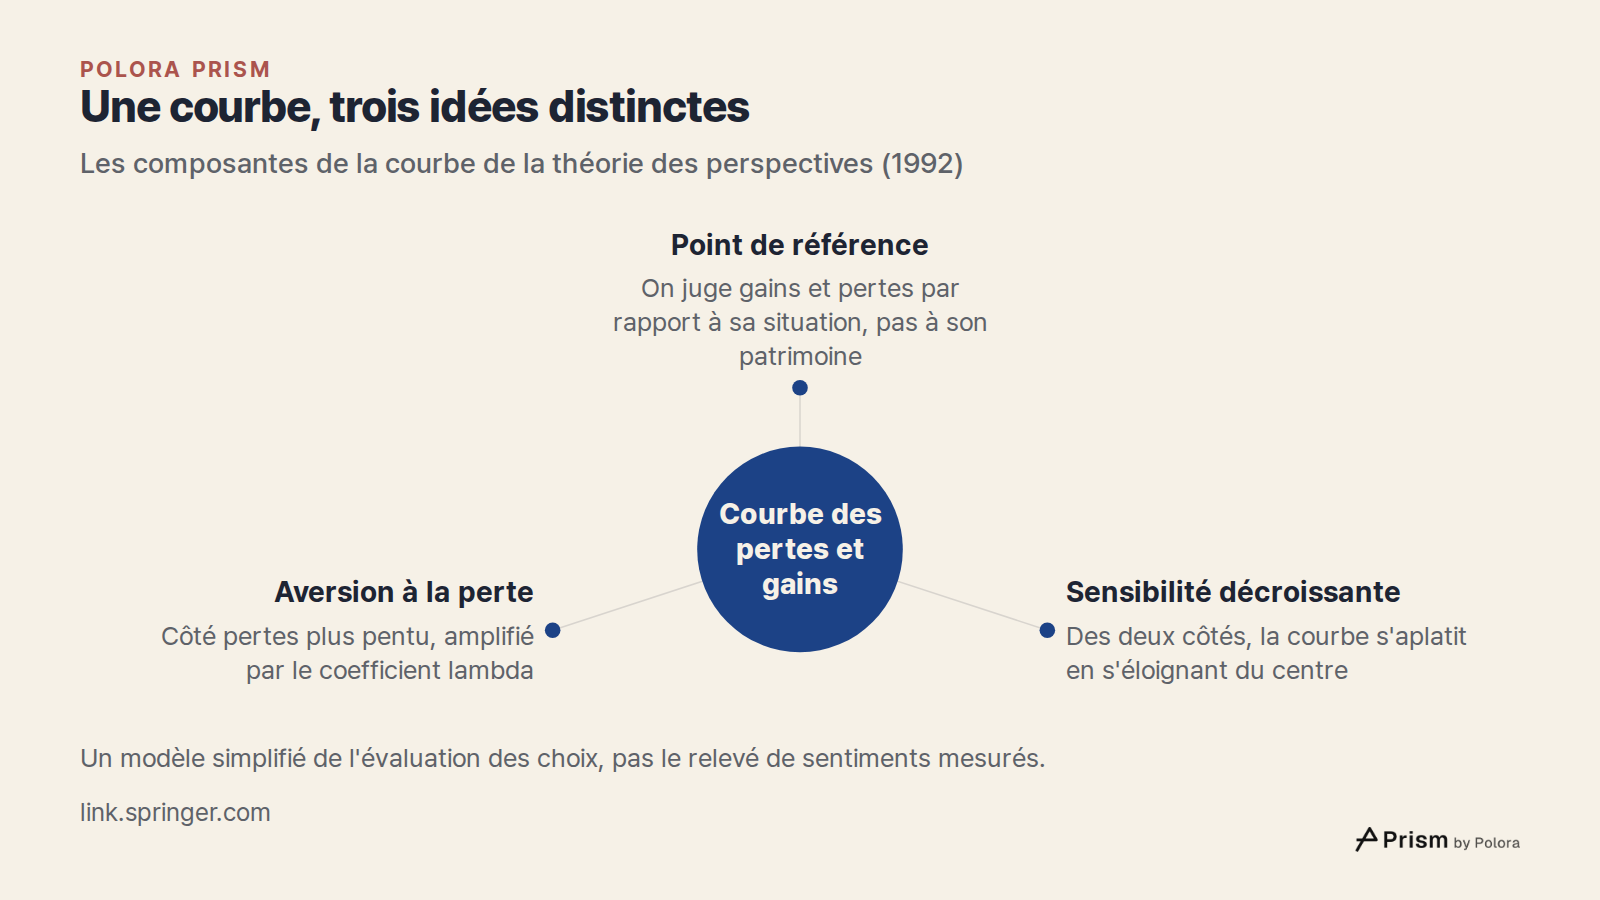
On représente en général la théorie des perspectives par une seule courbe. Les gains s'étendent à droite d'un point central, les pertes à gauche, et l'axe vertical indique la valeur accordée à un résultat. Cette courbe porte trois idées distinctes, qu'il est facile de confondre.
La première est le point de référence. La courbe part de votre situation actuelle, et non de votre patrimoine total. Une baisse de 100 dollars est perçue comme une perte par rapport à votre point de départ ou à ce que vous attendiez, que vous déteniez 1 000 dollars ou 1 million de dollars.
La deuxième est la sensibilité décroissante. Des deux côtés, la courbe s'aplatit à mesure qu'elle s'éloigne du centre : passer de 0 à 100 dollars compte davantage que passer de 1 000 à 1 100 dollars, pour les gains comme pour les pertes. Dans l'ajustement de 1992, cette courbure est fixée par un exposant de 0,88, identique des deux côtés.
La troisième est l'aversion à la perte, qui répond à la question du titre. Le côté des pertes est plus pentu que celui des gains, si bien qu'un pas vers la gauche fait descendre plus bas que le même pas vers la droite ne fait monter. Le coefficient qui amplifie le côté des pertes s'appelle lambda : dans le modèle de 1992, une perte vaut lambda fois ce que vaut un gain de même montant. Avec un lambda de 1, pertes et gains pèsent autant ; 2,25 est la médiane de 1992.
La courbe est un modèle simplifié de la façon dont les choix sont évalués, une fois ces paramètres fixés. Ce n'est pas le relevé de ce que quelqu'un a réellement ressenti.
Qu'ont trouvé les études qui ont refait la mesure ?
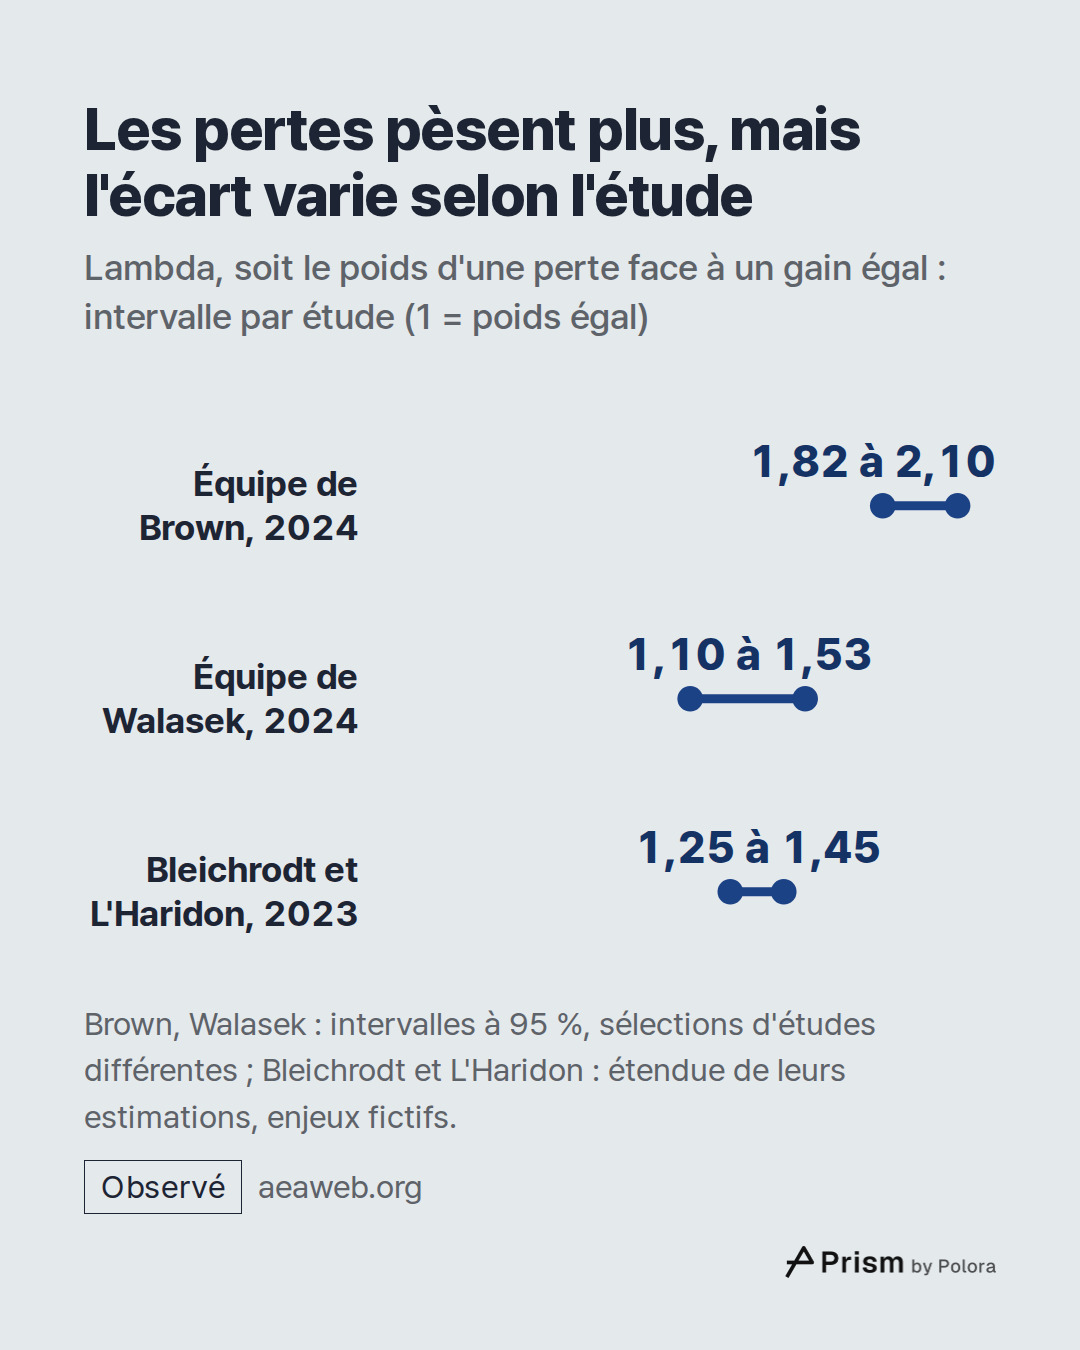
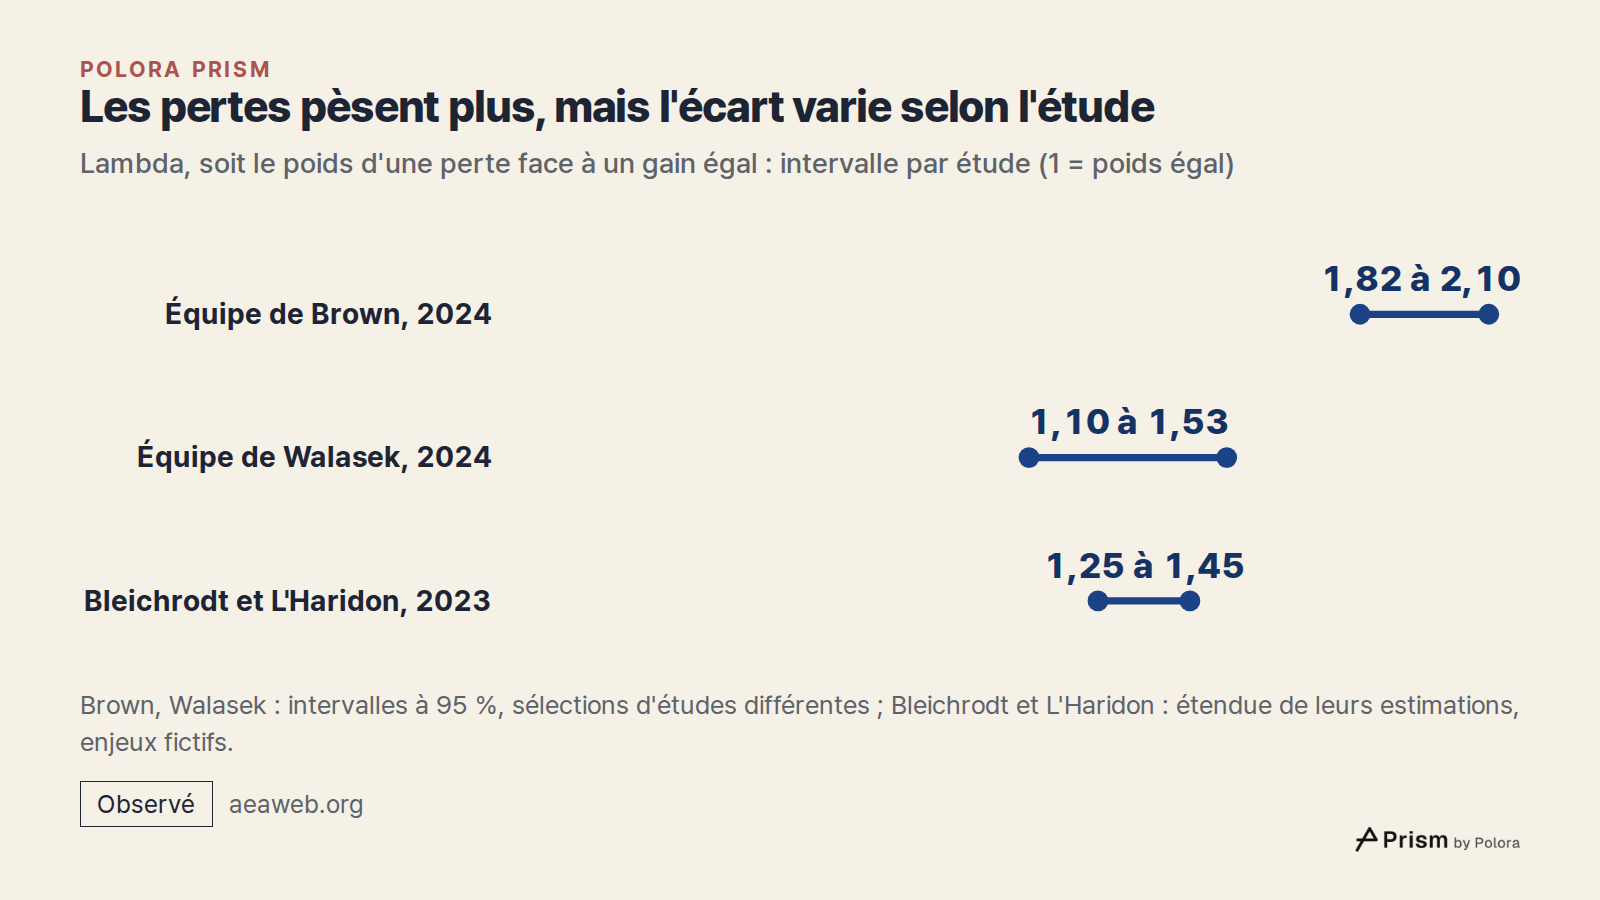
Des centaines d'études ont depuis estimé lambda. La synthèse la plus vaste, signée Alexander Brown, Taisuke Imai, Ferdinand Vieider et Colin Camerer (Journal of Economic Literature, 2024), réunit 607 estimations issues de 150 articles publiés de 1992 à 2017. Prises telles qu'elles ont été publiées, ces estimations ont une médiane de 1,69 et une moyenne de 1,97. Après correction statistique, l'estimation centrale des auteurs est de 1,955, avec un intervalle de confiance à 95 % allant de 1,82 à 2,10. Parmi les caractéristiques de protocole qu'ils avaient relevées, les auteurs en ont trouvé peu qui allaient de pair avec des écarts de résultats.
D'autres synthèses aboutissent à des valeurs plus basses. Lukasz Walasek, Timothy Mullett et Neil Stewart (Journal of Economic Psychology, 2024) ont réestimé lambda à partir des choix bruts de 17 études portant sur des paris risqués. Ils ont obtenu 1,31, avec un intervalle à 95 % de 1,10 à 1,53, qui n'atteint pas 2,25 ; ils signalaient aussi qu'une bonne partie des données de cet ensemble était de mauvaise qualité. En étudiant des choix entre marques de grande consommation, Michael Neumann et Ulf Böckenholt (Journal of Retailing, 2014) ont obtenu 1,49 ou 1,73 selon le modèle. Han Bleichrodt et Olivier L'Haridon (Judgment and Decision Making, 2023) ont utilisé un test conçu pour distinguer l'aversion à la perte de l'aplatissement de la courbe. Ils ont trouvé une aversion à la perte pour de petits comme pour de gros enjeux, avec un lambda compris entre 1,25 et 1,45, qu'ils jugent inférieur à ce qu'on observe couramment. Les sommes en jeu étaient toutefois fictives.
Ces travaux analysent des sélections différentes de résultats, construites de manières différentes. Ce ne sont pas des mesures répétées d'une même constante humaine. À la question « les pertes pèsent-elles plus lourd ? », ces études répondent le plus souvent oui. À la question « de combien ? », leurs réponses vont d'environ 2 à environ 1,3.
- Brown, Imai, Vieider and Camerer (2024), Meta-analysis of empirical estimates of loss aversion, Journal of Economic Literature
- Brown, Imai, Vieider and Camerer (2024), Caltech record
- Walasek, Mullett and Stewart (2024), Journal of Economic Psychology, Warwick repository
- Walasek, Mullett and Stewart (2024), full text
- Walasek, Mullett and Stewart (2024), Journal of Economic Psychology
- Neumann and Böckenholt (2014), Journal of Retailing
- Bleichrodt and L'Haridon (2023), Prospect theory's loss aversion is robust to stake size, Judgment and Decision Making
Pourquoi la réponse dépend-elle de la façon dont le test est construit ?
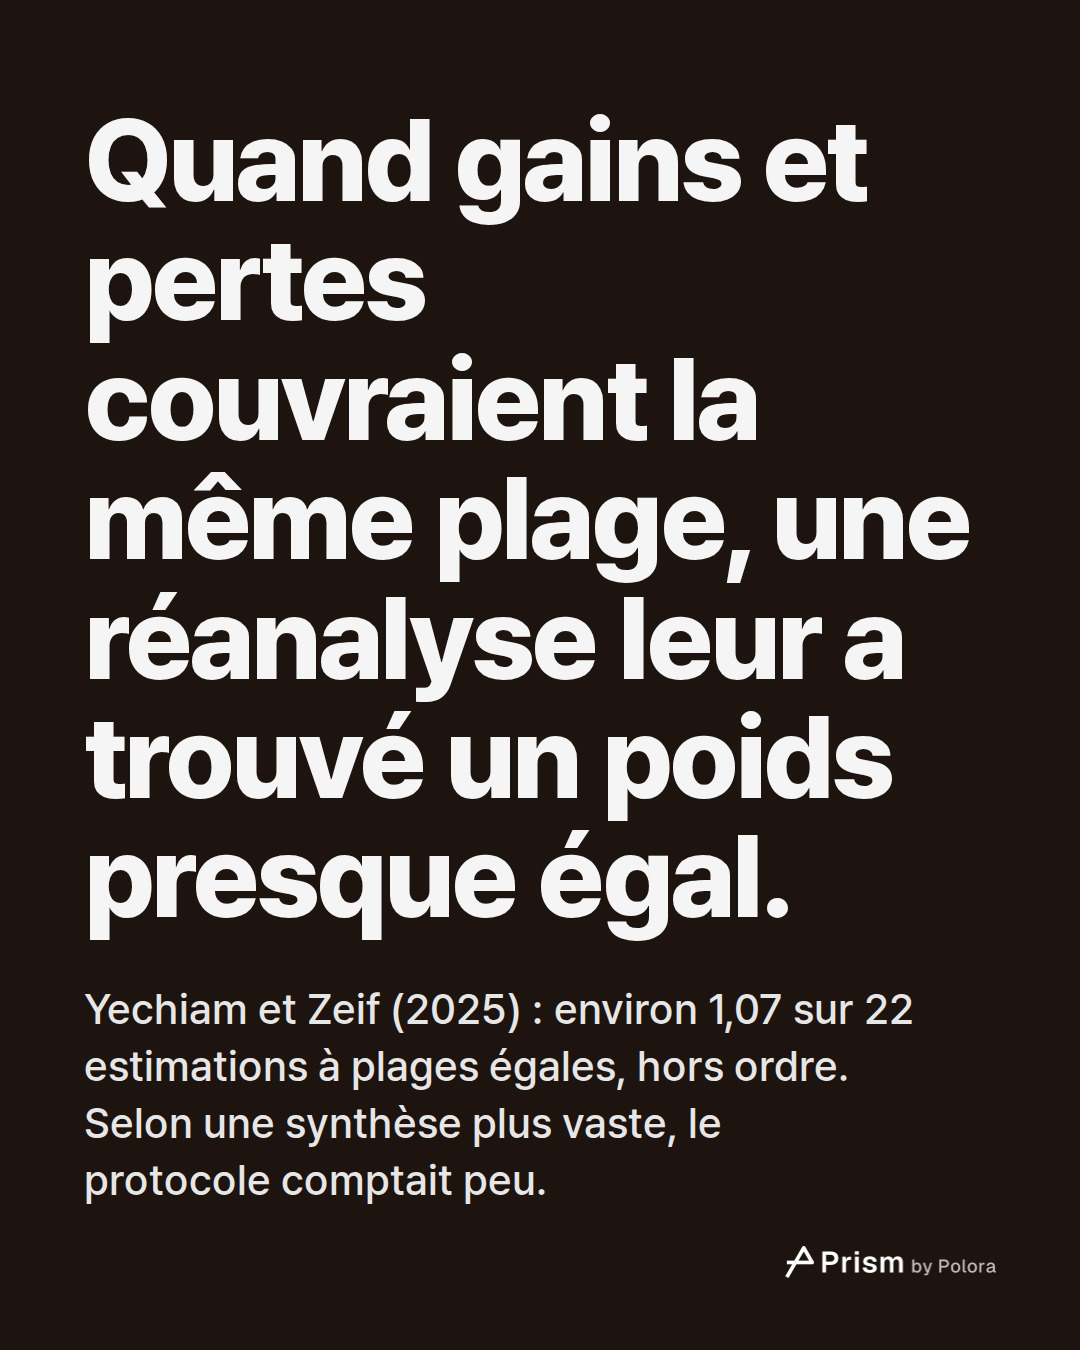
Eldad Yechiam et Dana Zeif (Journal of Economic Psychology, 2025) sont repartis des données de l'équipe de Brown et ont classé les études selon leur protocole. Ils ont pu le faire pour 163 des estimations, issues de 84 articles. Là où l'aversion à la perte paraissait forte, deux caractéristiques revenaient : soit les pertes possibles étaient plus petites que les gains possibles, soit les montants étaient présentés par ordre de grandeur. Dans les 22 estimations où gains et pertes couvraient la même plage et n'étaient pas présentés dans l'ordre, lambda ressortait à environ 1,07, avec un intervalle de 0,97 à 1,18, sans être significativement supérieur à 1. Ils ont aussi trouvé des estimations plus basses quand l'argent était réel que lorsqu'il était fictif. Le titre de leur article résume leur lecture : l'aversion à la perte n'est pas robuste. Ce chiffre vaut pour le sous-ensemble qu'ils ont retenu. Il remet en question la portée générale des estimations plus élevées, sans les effacer. L'équipe de Brown concluait que peu de caractéristiques de protocole comptaient, alors que Yechiam et Zeif ont trouvé des différences de protocole qui comptaient. Sur ce point, les deux synthèses se contredisent.
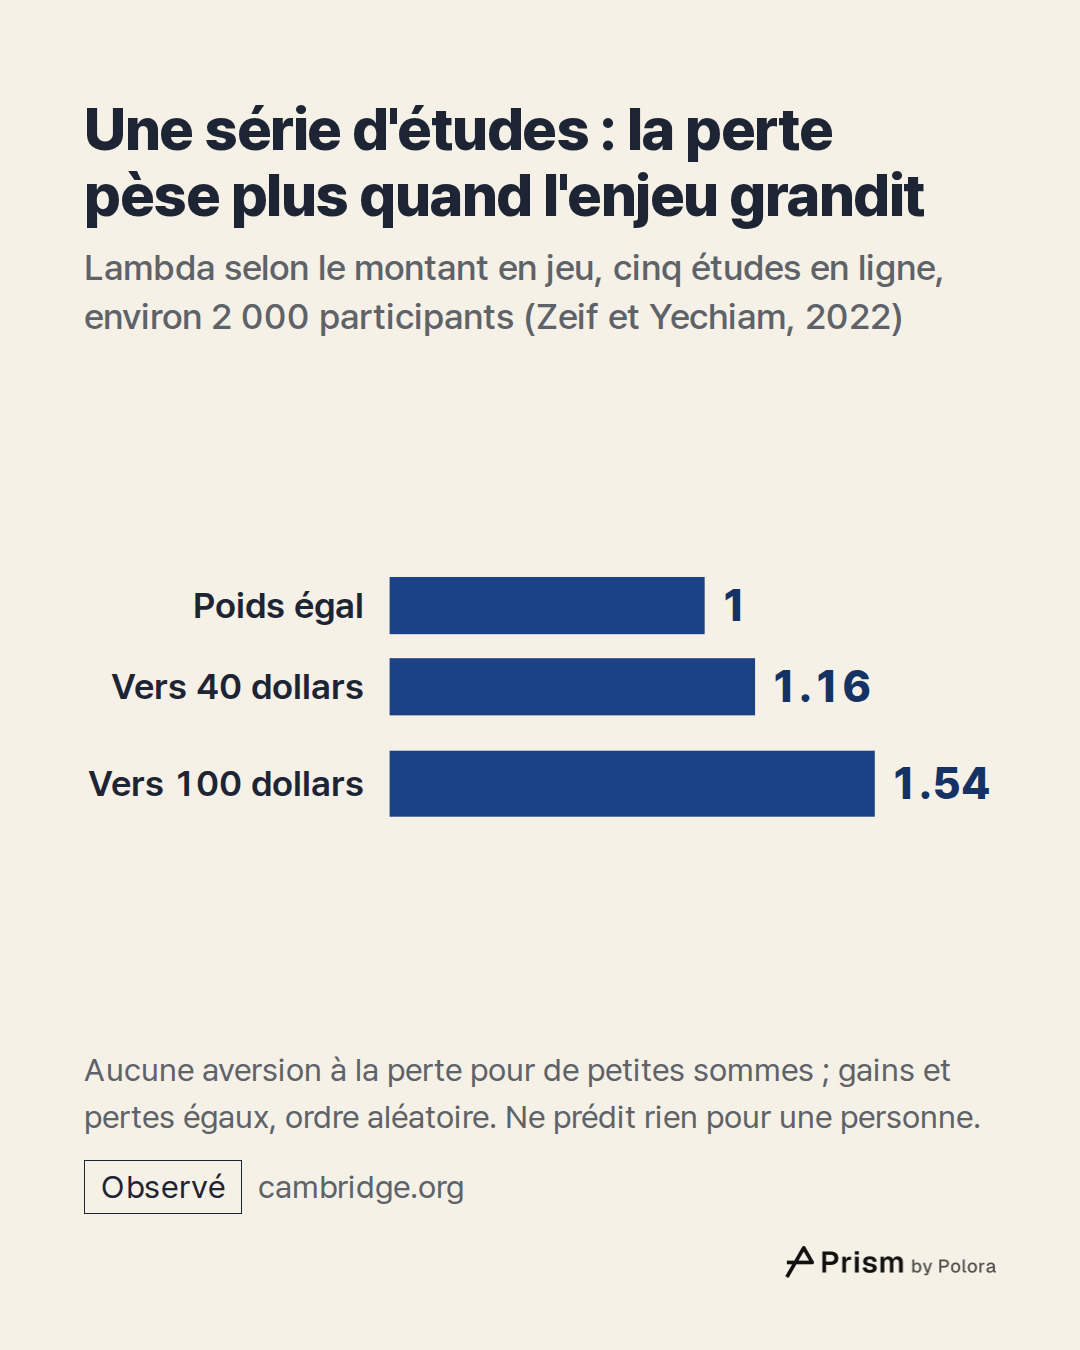
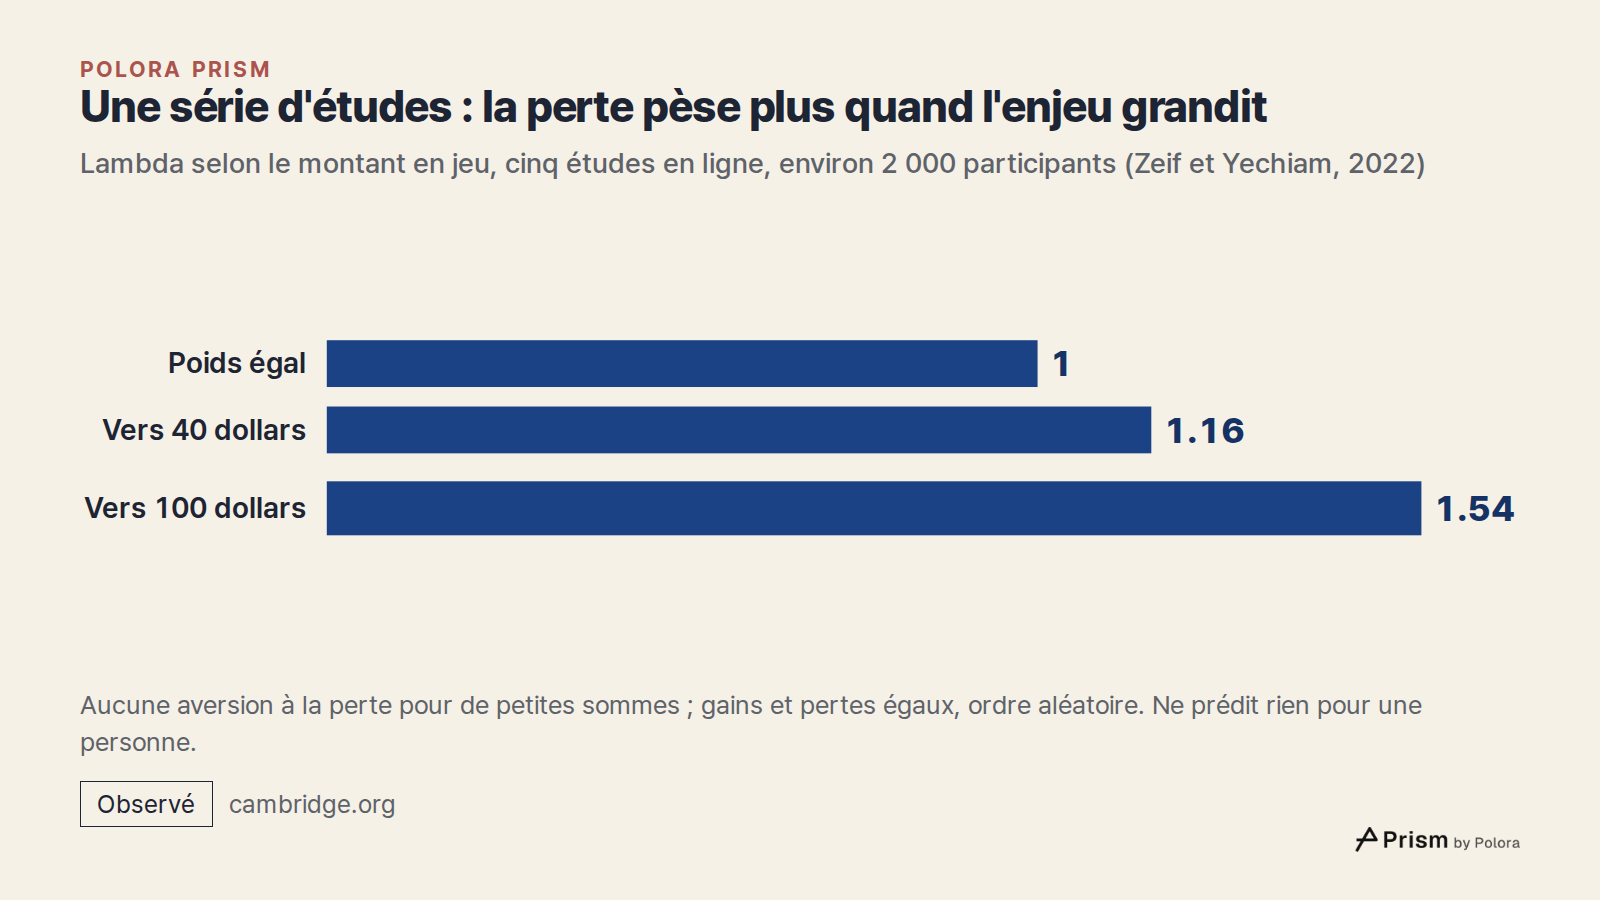
Le montant en jeu compte aussi, y compris pour les 100 dollars de notre exemple. Dans une série antérieure de cinq études en ligne réunissant environ 2 000 participants, Zeif et Yechiam (Judgment and Decision Making, 2022) présentaient des gains et des pertes de même montant dans un ordre aléatoire. Pour de petites sommes, ils n'ont trouvé aucune aversion à la perte. Autour de 40 dollars, lambda n'était que de 1,16, et il atteignait 1,54 autour de 100 dollars. Ces chiffres valent pour la méthode de cette étude ; ils ne prédisent rien sur les 100 dollars de qui que ce soit.
Il existe aussi un écart entre choisir et ressentir. La plupart de ces chiffres proviennent des choix que font les gens, et non de ce qu'ils ressentent ensuite. Dans deux études sur des jeux d'argent, Deborah Kermer et ses collègues (Psychological Science, 2006) ont constaté que les participants prévoyaient qu'une perte ferait plus mal qu'un gain égal ne ferait plaisir. Pourtant, une fois le pari joué, les pertes faisaient moins mal que prévu. Ces études montrent un écart entre la prévision et le vécu ; elles ne montrent pas qu'une perte réelle ne fait jamais plus mal qu'un gain égal.
Tout le monde ne lit pas ces résultats de la même façon. Dans une revue de la littérature, et non dans une nouvelle estimation, David Gal et Derek Rucker (Journal of Consumer Psychology, 2018) ont soutenu que les pertes ne pèsent pas plus lourd que les gains en règle générale et que tout dépend du contexte. Dans le même numéro, Itamar Simonson et Ran Kivetz leur ont répondu que cette conclusion allait trop loin. La question reste ouverte, et des chercheurs rigoureux défendent chacune des deux positions.
- Yechiam and Zeif (2025), Loss aversion is not robust : a re-meta-analysis, preprint
- Yechiam and Zeif (2025), Journal of Economic Psychology
- Yechiam and Zeif (2025), Journal of Economic Psychology
- Yechiam and Zeif (2025), research record
- Zeif and Yechiam (2022), Judgment and Decision Making
- Zeif and Yechiam (2022), Loss aversion (simply) does not materialize for smaller losses
- Kermer and others (2006), Psychological Science
- Kermer and others (2006), Psychological Science
Quel rapport entre cette courbe et une action que vous détenez ?
Pour un investisseur, le point de référence est souvent le prix d'achat. Une action achetée 50 dollars qui n'en vaut plus que 40 donne l'impression d'une perte de 10 dollars. Le prix du marché est pourtant le même pour tous ceux qui détiennent cette action, quel que soit le prix qu'ils ont payé.
Ici, la courbure du côté des pertes compte davantage que lambda. Comme la courbe s'aplatit à mesure que les pertes grossissent, le modèle prévoit que, face à une perte, on préfère tenter un pari plutôt qu'accepter une perte certaine. Dans l'article de 1979, 80 % des personnes interrogées préféraient recevoir 3 000 dollars à coup sûr plutôt qu'avoir 80 % de chances d'en gagner 4 000. Mais quand le même choix était formulé en pertes, 92 % choisissaient le pari.
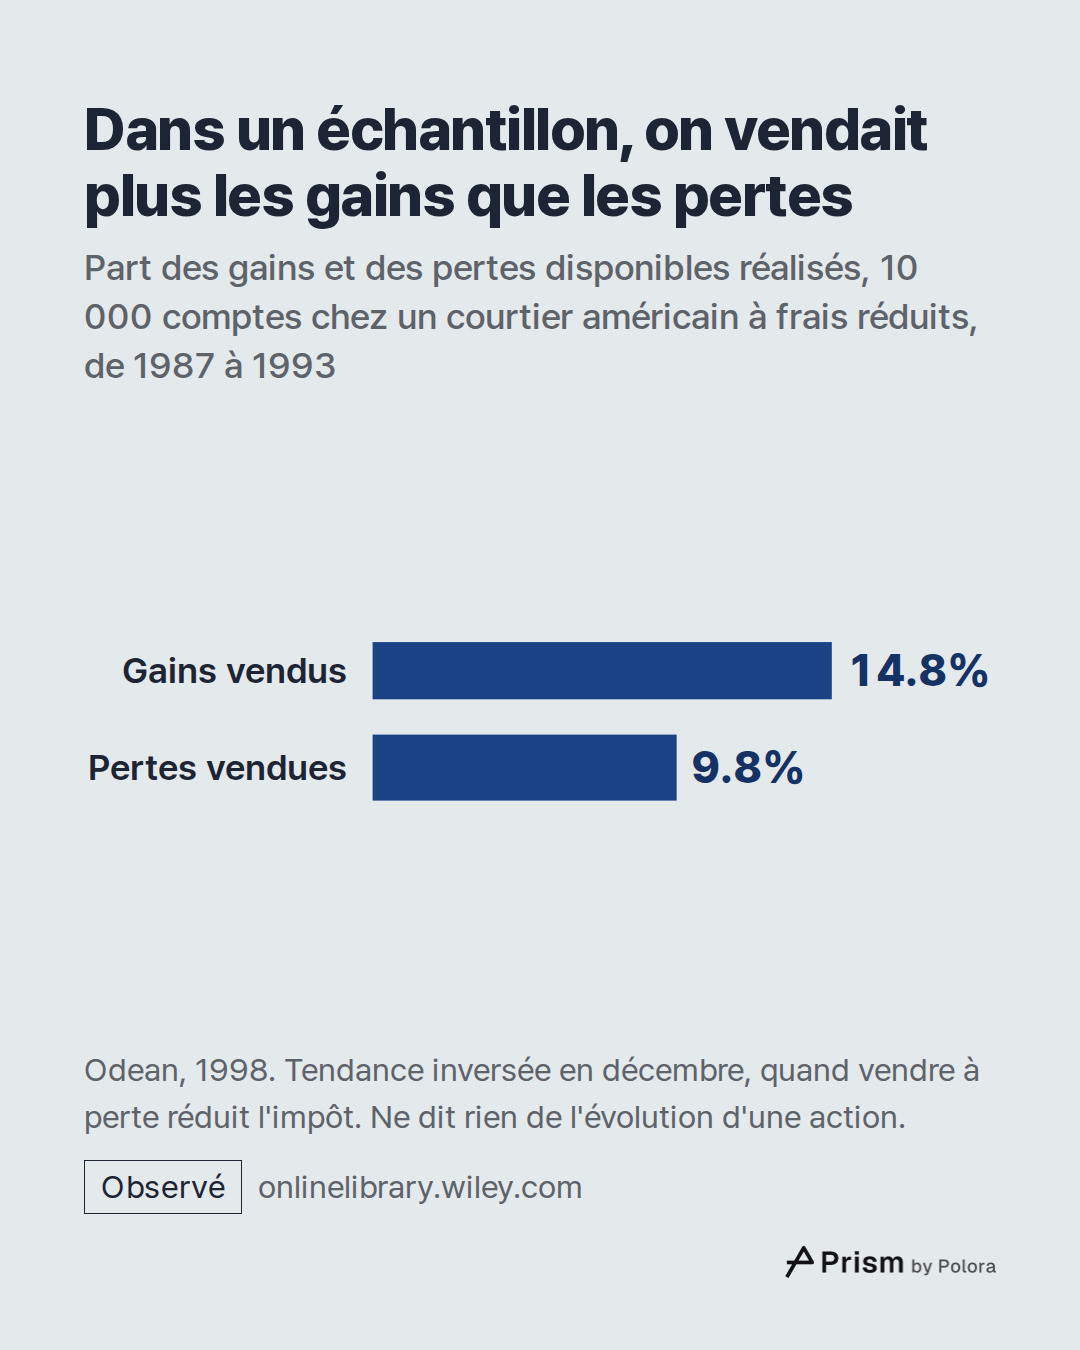
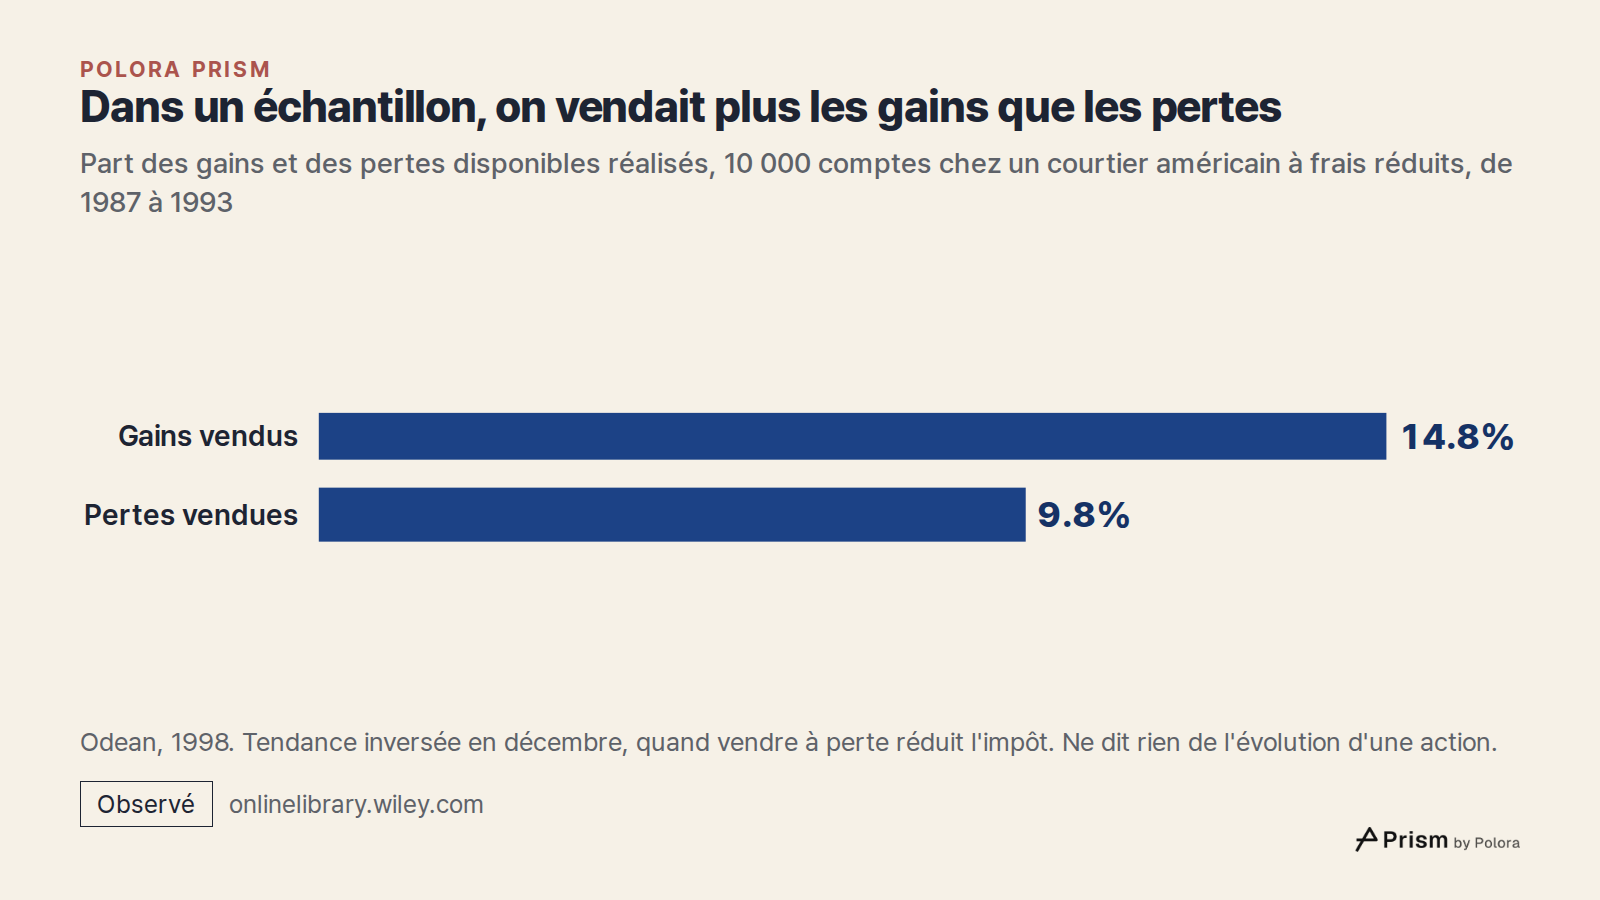
Hersh Shefrin et Meir Statman (Journal of Finance, 1985) ont donné un nom à un comportement voisin chez les investisseurs, l'effet de disposition : on vend trop tôt les titres gagnants et on garde trop longtemps les perdants. Pour l'expliquer, ils combinaient plusieurs facteurs, dont la comptabilité mentale (l'habitude de ranger son argent dans des cases séparées), le regret et la fiscalité, plutôt qu'une seule courbe. Terrance Odean (Journal of Finance, 1998) a ensuite testé cet effet sur les opérations de 10 000 comptes tirés au hasard chez un grand courtier américain à frais réduits, entre 1987 et 1993. Ces investisseurs réalisaient 14,8 % des plus-values à leur portée, mais seulement 9,8 % des moins-values. En décembre, quand vendre à perte permet d'économiser de l'impôt, la tendance s'inversait. Dans cet échantillon, les titres gagnants vendus ont ensuite devancé les perdants conservés de 3,4 points de pourcentage sur l'année suivante. Ce constat porte sur ces comptes, pendant ces années-là. Il ne dit rien de ce que fera une action ni du moment où quiconque devrait vendre.
Le lien entre la courbe et ce comportement est moins direct qu'il n'y paraît. Nicholas Barberis et Wei Xiong (Journal of Finance, 2009) ont examiné des versions simples de la théorie des perspectives. Une version fondée sur les gains et les pertes annuels échoue souvent à prédire l'effet de disposition, et prédit même parfois l'inverse. En revanche, une version fondée sur les gains et les pertes effectivement réalisés le prédit de façon plus fiable.
- Kahneman and Tversky (1979), Prospect theory, Econometrica
- Kahneman and Tversky (1979), Prospect theory, full text
- Shefrin and Statman (1985), Journal of Finance
- Odean (1998), Are investors reluctant to realize their losses?, full text
- Odean (1998), Journal of Finance
- Barberis and Xiong (2009), What drives the disposition effect?, Journal of Finance
Alors, une perte fait-elle vraiment plus mal ?
Dans de nombreuses expériences, les choix des gens accordent bel et bien plus de poids à une perte qu'à un gain égal, et ce constat a été reproduit à de nombreuses reprises. C'est l'ampleur de l'écart qui varie. Le « deux fois » que l'on entend vient de 25 étudiants en 1992. Les synthèses des travaux suivants, qui reposent chacune sur une sélection différente d'études, la situent près de 2, près de 1,3 ou tout près de 1. Tout dépend de quatre choses : si les pertes étaient plus petites que les gains, la façon dont les choix étaient présentés, si l'argent était réel ou fictif, et le montant en jeu.
Ces chiffres décrivent des choix. Ce que l'on ressent une fois la perte arrivée a été bien moins mesuré, et dans deux études sur des jeux d'argent, la perte faisait moins mal que prévu.
La phrase à retenir est donc celle-ci : en laboratoire, les pertes pèsent généralement plus lourd que les gains, mais l'écart dépend autant de la façon dont le test a été construit que des personnes elles-mêmes. La prochaine fois que vous verrez « x2 », demandez-vous comment ce chiffre a été mesuré, et s'il mesurait un choix ou un sentiment.