A promessa é fácil de vender. Você concede uma entrevista longa, deixa uma IA aprender como você fala e trabalha e, a partir daí, uma versão sua responde perguntas no seu lugar, sem que ninguém precise mais incomodar a pessoa de verdade. Um estudo recente construiu exatamente esse tipo de substituto e depois o comparou com as pessoas de quem ele foi copiado. O resultado é claro e um tanto decepcionante : as cópias se pareciam com o grupo, mas não com a pessoa.
Os pesquisadores descrevem seus agentes como calibrados para a distribuição, porém imprecisos na identidade. Em palavras simples, um conjunto inteiro desses agentes produziu mais ou menos a mesma mistura de opiniões que um grupo real de pessoas produziu, mas cada agente isolado era um substituto pouco confiável do único ser humano em que foi baseado. Para entender o que isso significa, a Polora fez a mesma pergunta a vários modelos de IA criados por empresas diferentes e pediu que examinassem o estudo em conjunto.
O que o estudo mediu
A montagem foi direta : 51 profissionais do conhecimento nos Estados Unidos, todos em funções que giram em torno de documentos, participaram cada um de uma entrevista aprofundada sobre o próprio fluxo de trabalho, prevista para 90 minutos e que rendeu, em média, cerca de 43 minutos de fala gravada. A partir de cada transcrição, os pesquisadores construíram um agente pessoal, com um sistema que armazena a entrevista, busca as partes relevantes quando surge uma nova pergunta e usa um modelo de linguagem para raciocinar e responder como aquele participante.
Em seguida, tanto as pessoas quanto seus agentes avaliaram as mesmas quatro ferramentas de IA imaginadas para trabalhar com documentos : uma que responde perguntas cruzando muitos arquivos, uma que destaca trechos importantes, uma que transforma documentos em áudio e uma que executa tarefas de vários passos por conta própria. Cada uma recebeu notas em critérios simples de utilidade, facilidade de uso e disposição a adotar ou recomendar, além de comentários escritos em texto livre. As pessoas refizeram o mesmo teste três dias depois, o que deu ao estudo uma referência de quão coerente uma pessoa é consigo mesma. A verificação central foi crua : alinhar as respostas de cada agente às respostas da própria pessoa em que ele foi baseado.
O grupo bateu, uma pessoa não
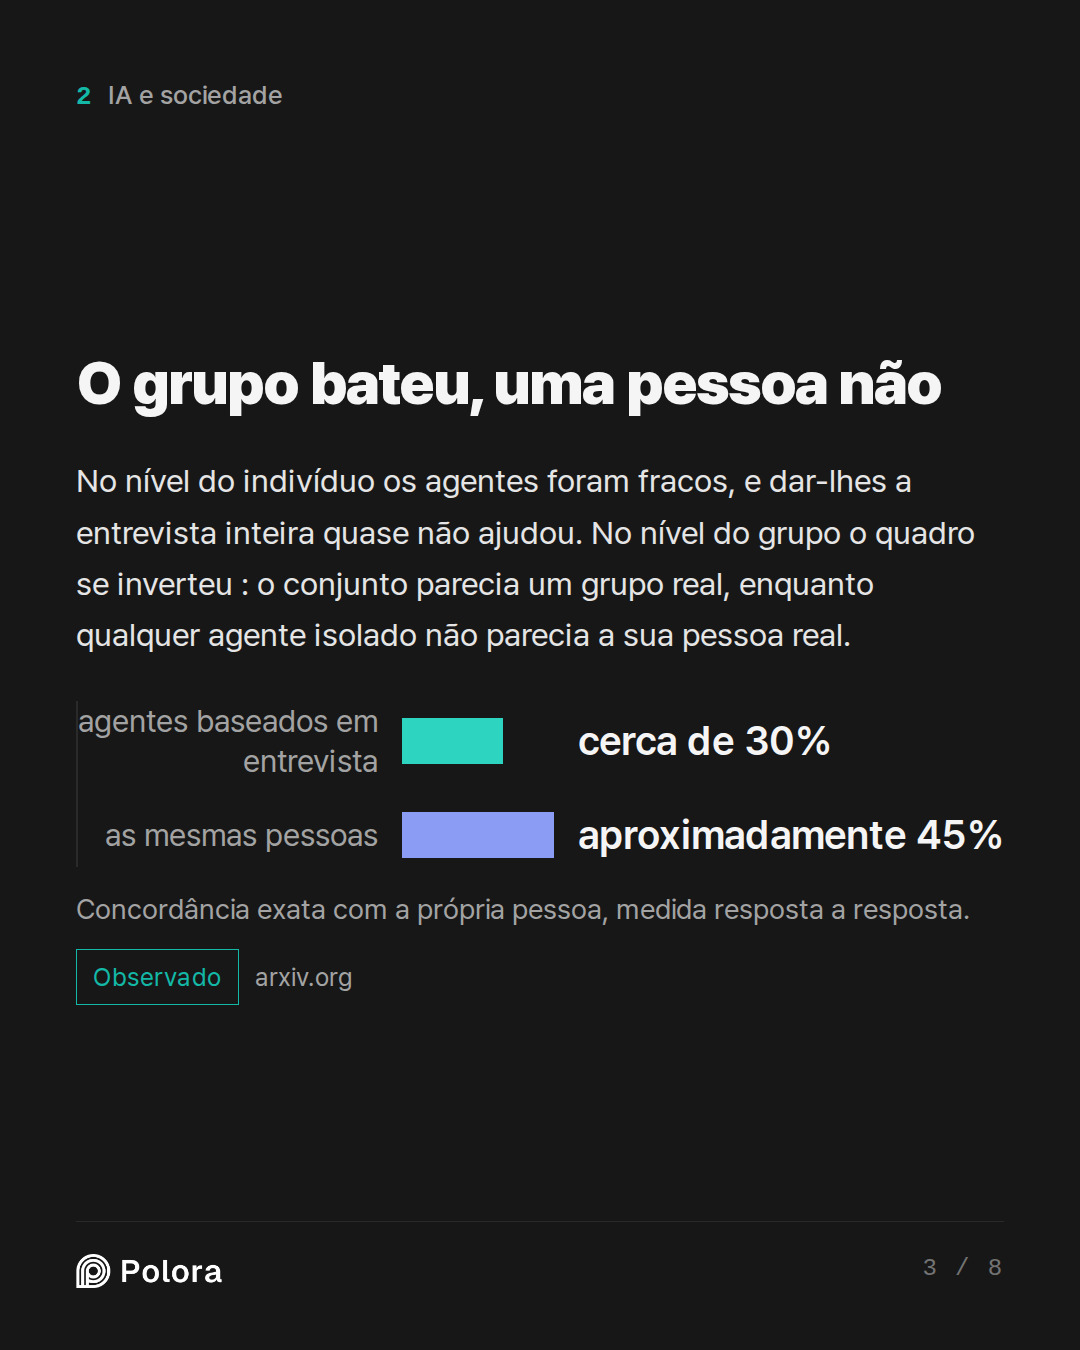
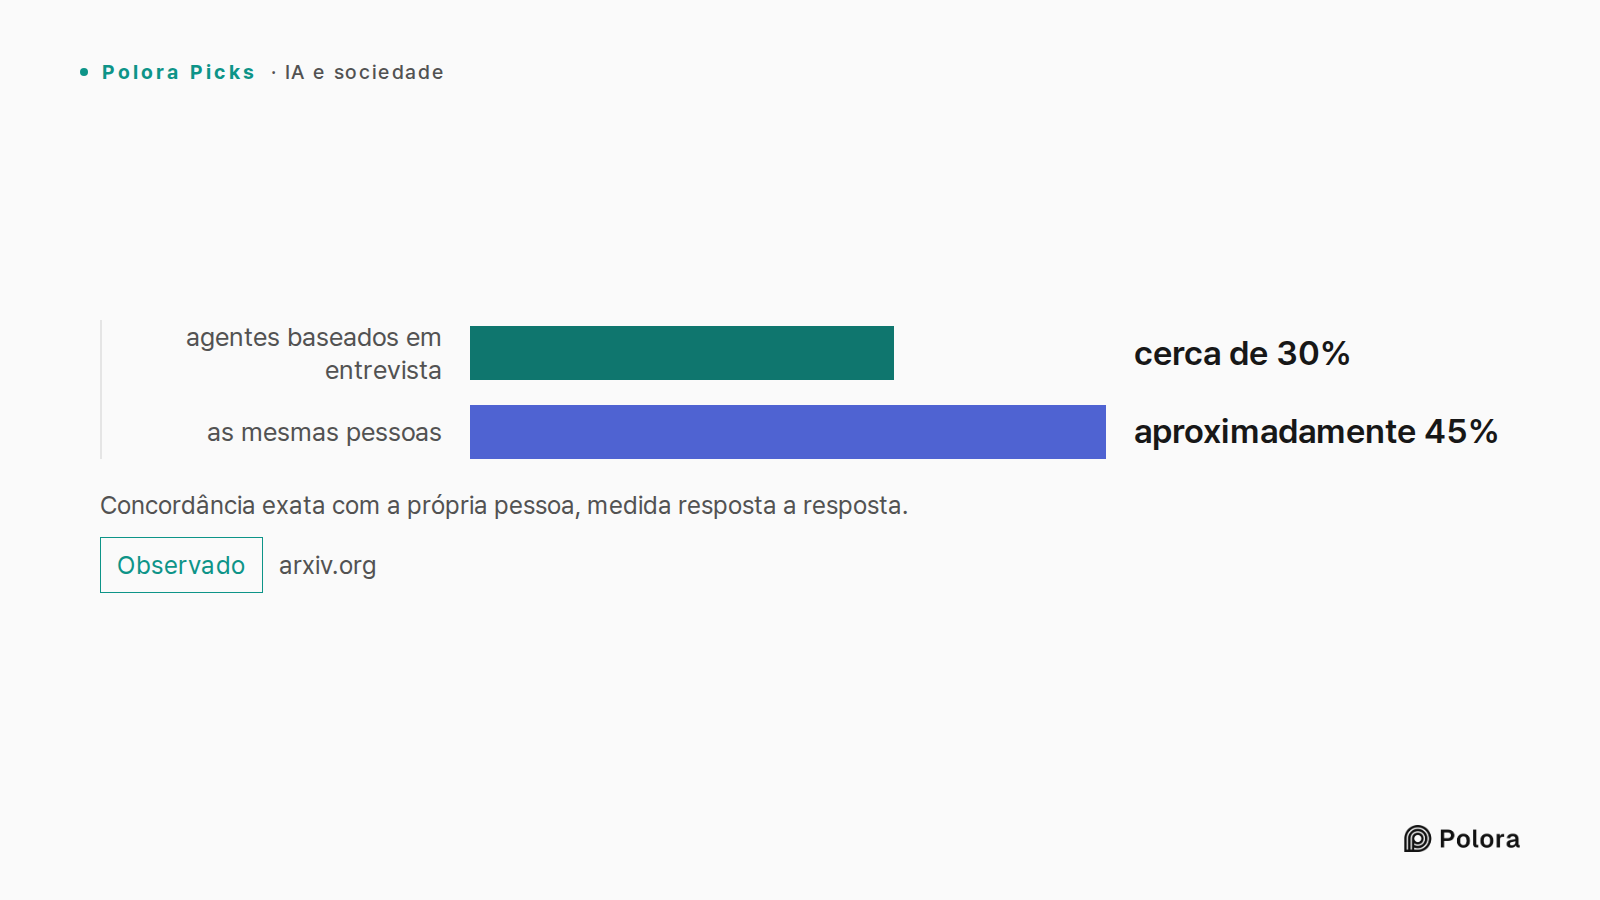
No nível do indivíduo, os agentes foram fracos. Na concordância exata com o próprio ser humano, os agentes baseados em entrevista acertaram cerca de 30% das vezes, contra aproximadamente 45% quando as mesmas pessoas simplesmente responderam de novo dias depois. O estudo apresenta isso como cerca de 67% da coerência humana, que é 30 dividido por 45, e não 67% de respostas certas. Alimentar o agente com a entrevista inteira quase não ajudou : ele não foi claramente melhor do que um agente que recebeu apenas alguns dados demográficos, ou mesmo um que não recebeu nada.
No nível do grupo, o quadro se inverteu. Quando se deixava de perguntar quem disse o quê e se olhava apenas para a distribuição geral das respostas, os agentes baseados em entrevista foram os que mais se aproximaram da distribuição real. Foram a única versão que reproduziu de algum modo as notas baixas e sem entusiasmo. Um agente sem nenhuma informação pessoal simplesmente recaía num padrão seguro, empilhando quase todas as respostas perto do topo de cada escala. Assim, o conjunto de agentes parecia um grupo real, enquanto qualquer agente isolado não parecia a sua pessoa real.
Por que acertar o grupo não é acertar você
Imagine dez pessoas, cinco que gostam de uma ideia e cinco que não gostam. Uma simulação poderia reproduzir com perfeição essa divisão de cinco a cinco e, ao mesmo tempo, inverter cada pessoa uma a uma. O gráfico fica certo e cada palpite individual fica errado. Isso é uma ilustração, não a afirmação de que os agentes literalmente inverteram todo mundo, mas mostra como uma distribuição correta pode esconder uma pilha de erros individuais. A média deixa os erros se cancelarem.
Vários motivos comuns se encaixam no que aconteceu. Uma entrevista capta parte do mundo de alguém, não todas as condições que decidem uma reação. Muitas vezes, julgamentos sobre uma ferramenta que você nunca tocou são formados na hora, e não lidos de um conjunto já assentado de preferências. Onde o registro fica ralo, o modelo preenche a lacuna com um raciocínio plausível e genérico, que soa como o de um trabalhador típico, e não como o desta pessoa. Conhecer o formato de um grupo quase nada garante sobre um membro específico dele.
Onde as arestas somem
As respostas escritas tornam a diferença concreta. Para a ferramenta de áudio, pessoas e agentes levantaram as mesmas preocupações principais : precisão, privacidade e encaixe nos programas que já usam. Mas cerca de 30% das pessoas reais rejeitaram a ideia por completo, algumas dizendo que não a usariam em circunstância alguma, enquanto apenas um único agente reagiu com essa firmeza. As pessoas apontaram entraves específicos, como trabalhar num computador de mesa e não no celular, ou precisar ler um documento em vez de ouvi-lo, ou uma regra de conformidade da própria empresa. Os agentes tendiam a reformular esses impedimentos definitivos como problemas que alguma melhoria resolveria.
Essa diferença importa porque "eu adotaria isto se melhorasse" não é a mesma resposta que "isto não serve para o meu trabalho". Os agentes também tiveram a pior nota em voz e tom, produzindo uma prosa arrumada onde as pessoas falavam de modo desorganizado, hesitante e às vezes contraditório. Cabe aqui uma ressalva : essas comparações qualitativas foram avaliadas por juízes de IA que concordaram entre si apenas de forma moderada, portanto são prova de apoio, e não veredito final.
O que isso significa para uma cópia de você mesmo
Se um fornecedor ou uma equipe de pesquisa lhe oferecer uma persona feita a partir da sua própria entrevista e disser que ela pode substituir você, este estudo é um motivo para cautela. A leitura mais segura é que as novas respostas dela são previsões sobre você, e não afirmações suas. Um vocabulário familiar e referências ao seu trabalho mostram que a persona usou o seu material. Não mostram que as conclusões dela representam você.
Na prática, isso significa que não se deve confiar a uma persona feita das suas palavras a tarefa de reproduzir os seus vetos, de explicar por que você hesitaria ou de julgar como uma ferramenta se encaixaria no seu fluxo de trabalho real. Ela não deve consentir por você, decidir por você, nem ser citada como se fosse a sua opinião. Qualquer resposta que fosse usada como se você a tivesse dado precisa voltar a você para confirmação.
Onde ela vale o que custa, e onde não vale
Ainda existe um uso real, porém estreito. Como um conjunto desses agentes se parece com um grupo real, eles podem servir de primeiro filtro barato : peneirar muitas ideias ainda cruas antes de gastar em protótipos, comparar direções amplas, como mais automação contra mais controle, ou gerar objeções e possíveis perguntas para levar à pesquisa com gente de verdade. O estudo coloca o custo de operação muito abaixo de uma sessão com uma pessoa, cerca de US$ 1,27 contra aproximadamente US$ 12,50, embora não fique totalmente claro se os dois valores medem a mesma unidade de trabalho.
Onde ela não cabe é em qualquer situação cuja tarefa seja ser uma pessoa específica. Ela não pode falar por um participante nomeado, apurar a confiança ou os entraves de adoção de alguém, substituir entrevistas quando os detalhes do fluxo de trabalho são justamente o ponto, nem transformar um comentário sintético em depoimento de cliente. Até o uso como filtro vem com um aviso : acertar a distribuição das respostas de hoje não prova que os agentes ordenariam corretamente as ideias de amanhã, então continua sendo uma ideia promissora, e não uma demonstração.
Um estudo, não um veredito
Este é um único estudo, específico de um domínio : 51 profissionais do conhecimento nos Estados Unidos, quatro ferramentas de documentos imaginadas, uma única forma de construir os agentes. Ele não prova que uma simulação pessoal fiel seja impossível, e métodos melhores podem estreitar a distância. O que ele faz é mover o ônus da prova para o lugar certo. Basear um agente nas suas palavras não é o mesmo que fazê-lo substituir você, e essa segunda afirmação agora precisa ser demonstrada, não presumida.
A regra prática que sai disso é simples. Use um conjunto desses agentes quando você só precisa do grupo, para um sinal agregado rápido e aproximado. Use pessoas de verdade para tudo o que precise ser uma pessoa específica, incluindo as suas próprias decisões sobre uma ferramenta que vai ficar dentro do seu trabalho.