La promesa se vende sola. Siéntate a una entrevista larga, deja que una IA aprenda cómo hablas y cómo trabajas, y a partir de ahí una versión de ti podrá responder preguntas en tu lugar, de modo que nadie tenga que volver a molestar a la persona real. Un estudio reciente construyó exactamente ese tipo de sustituto y luego lo comparó con las personas de las que se había copiado. El resultado es nítido y algo decepcionante : las copias se parecían al grupo, pero no a la persona.
Los investigadores describen a sus agentes como calibrados con la distribución, pero imprecisos con la identidad. Dicho en palabras llanas, un conjunto entero de estos agentes producía más o menos la misma mezcla de opiniones que un grupo real de personas, pero cada agente por separado era un sustituto poco fiable del único humano en el que se basaba. Para desentrañar qué significa esto, Polora planteó la misma pregunta a varios modelos de IA creados por empresas distintas y les pidió que examinaran juntos el estudio.
Qué midió el estudio
El montaje fue directo. 51 trabajadores del conocimiento en Estados Unidos, todos en puestos con mucho trabajo documental, pasaron cada uno por una entrevista a fondo sobre su flujo de trabajo, prevista para 90 minutos y que dejó de media unos 43 minutos de habla grabada. A partir de cada transcripción los investigadores construyeron un agente personal, con un sistema que guarda la entrevista, recupera las partes relevantes cuando surge una nueva pregunta y hace que un modelo de lenguaje razone y responda como ese participante.
Después, tanto las personas como sus agentes evaluaron las mismas cuatro herramientas de IA imaginadas para trabajar con documentos : una que responde preguntas a partir de muchos archivos, otra que resalta los pasajes clave, otra que convierte documentos en audio y otra que ejecuta por su cuenta tareas de varios pasos. Cada una se puntuó con medidas sencillas de utilidad, facilidad de uso y disposición a adoptarla o recomendarla, junto con comentarios escritos abiertos. Las personas repitieron la misma prueba tres días después, lo que le dio al estudio una referencia de hasta qué punto una persona es siquiera coherente consigo misma. La comprobación central fue tajante : poner las respuestas de cada agente frente a las respuestas de la propia persona a partir de la cual se había creado.
El grupo coincidía, la persona no
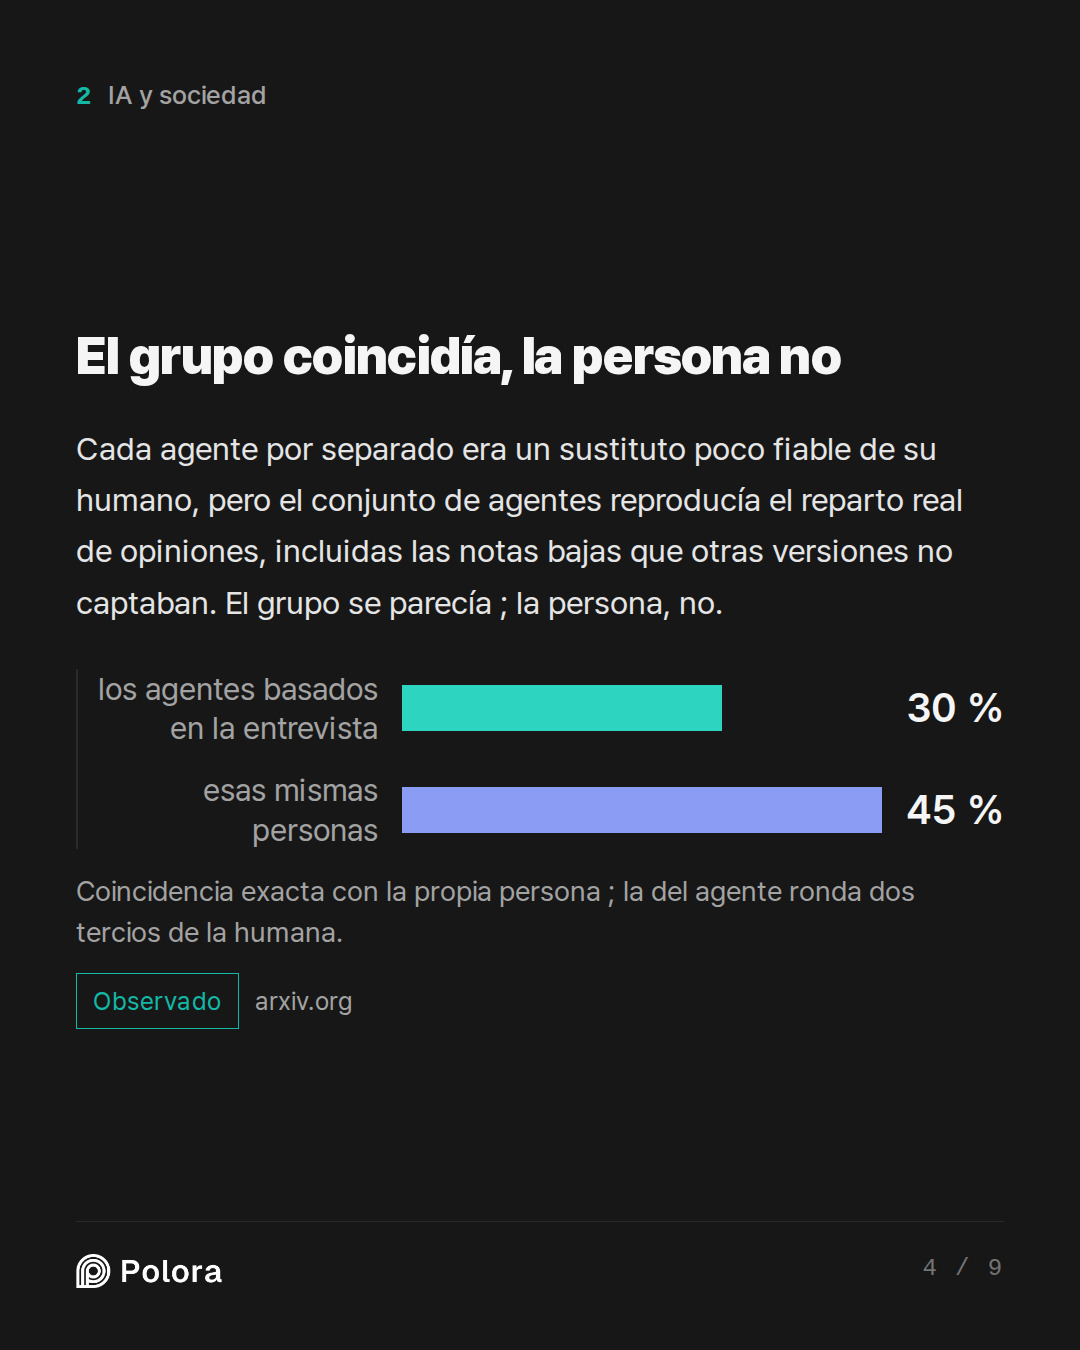
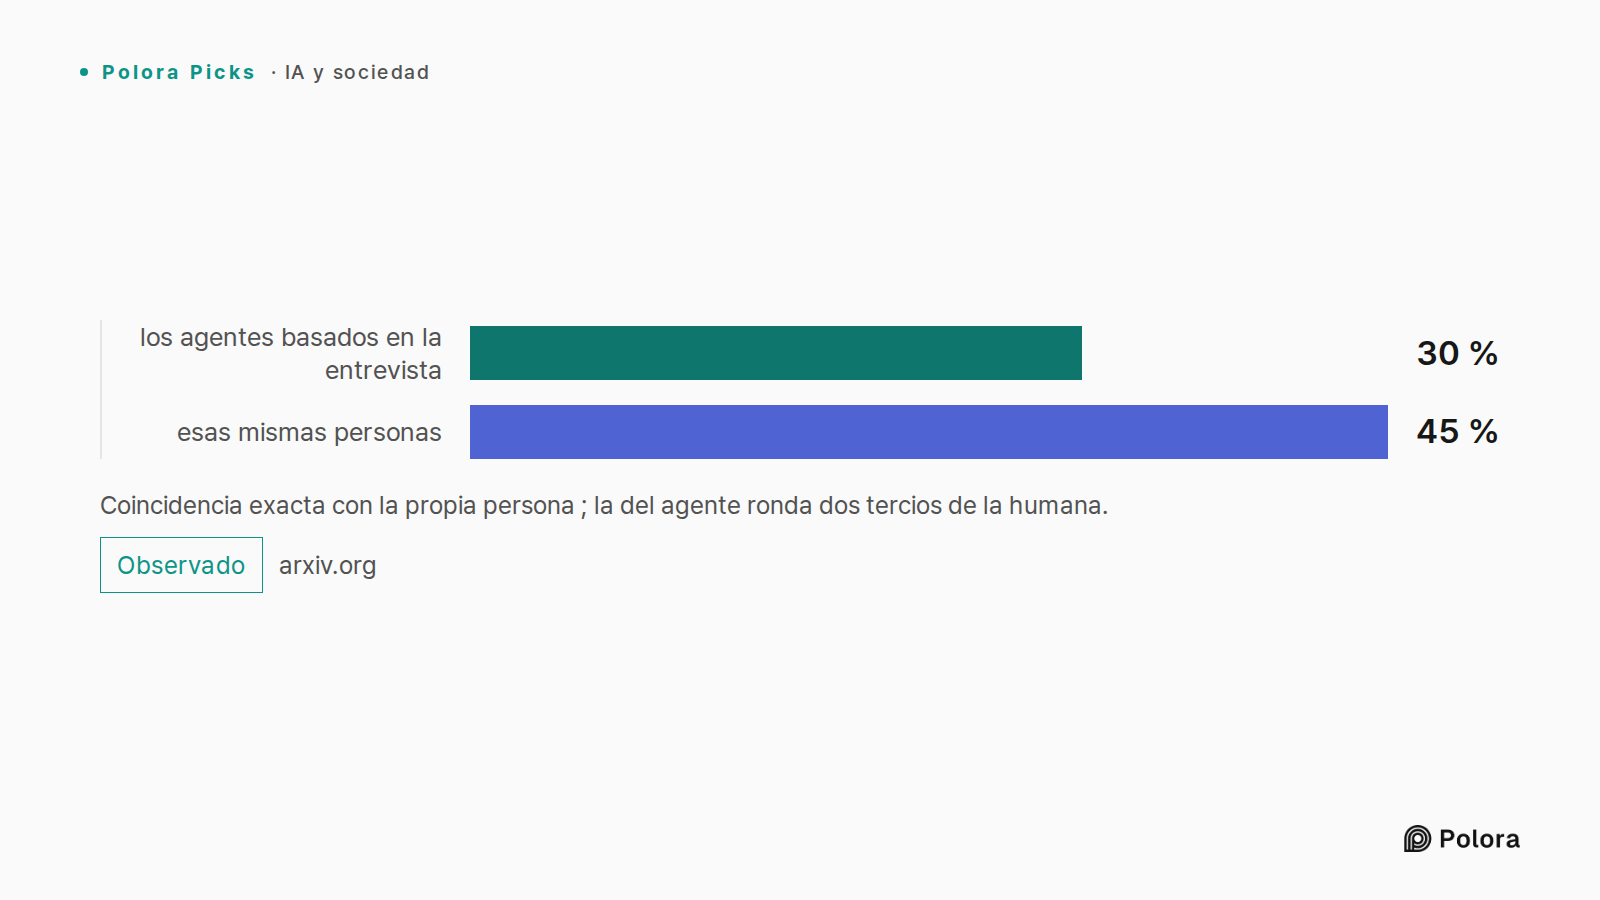
En el plano del individuo, los agentes eran flojos. En coincidencia exacta con su propio humano, los agentes basados en la entrevista acertaban alrededor del 30 % de las veces, frente a cerca del 45 % cuando esas mismas personas simplemente volvían a responder días después. El estudio lo plantea como en torno al 67 % de la coherencia humana, que es 30 dividido entre 45, no un 67 % de respuestas correctas. Darle al agente la entrevista completa apenas ayudaba : no era claramente mejor que un agente al que solo se le daban unos pocos datos demográficos, ni siquiera que uno al que no se le daba nada.
En el plano del grupo, el panorama se invertía. Cuando dejabas de preguntar quién dijo qué y mirabas solo el reparto general de respuestas, los agentes basados en la entrevista eran los que más se acercaban al reparto real. Eran la única versión que reproducía siquiera las puntuaciones bajas y poco entusiastas. Un agente sin ninguna información personal recaía en una respuesta segura por defecto y amontonaba casi todas sus respuestas cerca del extremo alto de cada escala. Así, el grupo de agentes se parecía a un grupo real, mientras que un agente cualquiera no se parecía a su persona real.
Por qué acertar con el grupo no es acertar contigo
Imagina diez personas, cinco a las que les gusta un concepto y cinco a las que no. Una simulación podría reproducir a la perfección ese reparto de cinco y cinco y, aun así, equivocarse con cada una de las personas por separado. El reparto es correcto y cada conjetura individual es errónea. Esto es una ilustración, no la afirmación de que los agentes invirtieran literalmente la respuesta de cada persona, pero muestra cómo una distribución correcta puede esconder un montón de errores individuales. El promedio deja que los fallos se cancelen entre sí.
Varias razones corrientes encajan con lo ocurrido. Una entrevista capta una parte del mundo de alguien, no todas las condiciones que deciden una reacción. Los juicios sobre una herramienta que nunca has tocado suelen construirse en el momento, no leerse de un conjunto asentado de preferencias. Donde el registro se queda corto, el modelo rellena el hueco con un razonamiento verosímil y genérico que suena a un trabajador típico y no a este en concreto. Conocer la forma de un grupo no te dice casi nada seguro sobre un miembro en particular.
Dónde se nota el suavizado
Las respuestas escritas hacen palpable la diferencia. Para la herramienta de audio, personas y agentes plantearon las mismas preocupaciones de fondo : exactitud, privacidad, encaje con el software que ya usan. Pero alrededor del 30 % de las personas reales rechazaba la idea de plano, y algunas decían que no la usarían bajo ninguna circunstancia, mientras que solo un único agente se resistió con esa firmeza. Las personas nombraban obstáculos concretos e insalvables, como trabajar en un ordenador de escritorio y no en un teléfono, o necesitar leer un documento en lugar de oírlo, o una norma de cumplimiento en su empresa. Los agentes tendían a reformular esos frenos absolutos como problemas que alguna mejora podría resolver.
Esa diferencia importa porque "lo adoptaría si mejorara" no es la misma respuesta que "esto no encaja en mi trabajo". Los agentes también obtuvieron su peor nota en voz y tono, ya que producían una prosa pulcra donde las personas hablaban de forma desordenada, titubeante y a veces contradictoria. Aquí cabe una advertencia : estas comparaciones cualitativas las calificaron jueces de IA que solo coincidían entre sí de forma moderada, así que son una prueba de apoyo y no un veredicto definitivo.
Qué significa para una copia de ti mismo
Si un proveedor o un equipo de investigación te ofrece una réplica hecha a partir de tu propia entrevista y te dice que puede sustituirte, este estudio es motivo de cautela. La lectura más prudente es que sus nuevas respuestas son predicciones sobre ti, no declaraciones tuyas. Un vocabulario familiar y las referencias a tu trabajo demuestran que usó tu material. No demuestran que sus conclusiones te representen.
En la práctica, eso significa que no conviene confiar en que una réplica construida con tus palabras reproduzca tus vetos, explique por qué dudarías o juzgue cómo encajaría una herramienta en tu flujo de trabajo real. No debería dar su consentimiento en tu nombre, decidir en tu nombre ni citarse como si fuera tu opinión. Cualquier respuesta que fuera a usarse como si la hubieras dicho tú debería volver a ti para que la confirmes.
Dónde resulta útil y dónde no
Sigue habiendo un uso real, pero estrecho. Como un grupo de estos agentes se parece a un grupo real, pueden servir de primer filtro barato : cribar muchos conceptos en bruto antes de gastar en prototipos, comparar direcciones generales como más automatización frente a más control, o generar posibles objeciones y preguntas para llevarlas a una investigación real. El estudio sitúa su coste de funcionamiento muy por debajo del de una sesión con una persona, en torno a 1,27 dólares frente a unos 12,50 dólares, aunque no queda del todo claro que ambas cifras se midan sobre la misma unidad de trabajo.
Donde no tiene cabida es en cualquier tarea que consista en ser una persona concreta. No puede hablar por un participante con nombre, establecer los frenos de confianza o de adopción de alguien, reemplazar las entrevistas cuando lo que importa son los detalles del flujo de trabajo, ni convertir un comentario sintético en testimonio de un cliente. Incluso el uso como filtro viene con una advertencia : acertar con el reparto de las respuestas de hoy no prueba que los agentes ordenarían bien los conceptos de mañana, así que sigue siendo una idea prometedora y no algo demostrado.
Un estudio, no un veredicto
Este es un único estudio, acotado a un ámbito : 51 trabajadores del conocimiento estadounidenses, cuatro herramientas documentales imaginadas y una sola manera de construir los agentes. No demuestra que una simulación personal fiel sea imposible, y métodos mejores podrían acortar la distancia. Lo que sí hace es colocar la carga de la prueba en el lugar correcto. Basar un agente en tus palabras no es lo mismo que lograr que te sustituya, y esa segunda afirmación ahora hay que demostrarla, no darla por hecha.
La regla de trabajo que se desprende de todo esto es sencilla. Usa un grupo de estos agentes cuando solo necesites al grupo, para una señal agregada rápida y aproximada. Usa personas reales para cualquier cosa que tenga que ser una persona en particular, incluidas tus propias decisiones sobre una herramienta que vaya a vivir dentro de tu trabajo.