Uma IA pequena identifica animais tão bem quanto uma grande?
Sim, e muitas vezes melhor. Um modelo especializado minúsculo acertou muito mais que modelos várias vezes maiores, que às vezes inventavam espécies. Tudo rodou numa câmera de campo, sem internet.
Explica : Can Edge-Deployable Vision-Language Models Identify Species?, William Zhou et al., 2026-09-10, v1 Ler o original
IA e sociedade · 2026-09-13
Uma câmera presa a uma árvore numa reserva natural tira uma foto sempre que algo passa na frente dela. Cada vez mais, essa câmera tenta dizer sozinha que animal é aquele, usando um pequeno modelo de IA que roda no próprio aparelho, porque no meio do mato muitas vezes não há sinal para enviar a imagem a outro lugar. Daí surge uma pergunta simples : um modelo pequeno o bastante para caber numa câmera sabe mesmo o que está vendo?
Um estudo recente se propôs a responder exatamente isso, medindo até que ponto os modelos pequenos capazes de rodar numa câmera de campo identificam os animais diante deles. As conclusões incomodam, mas de um jeito que acaba sendo útil. Os modelos pequenos analisados tinham, sim, conhecimento real sobre animais. Só que um modelo especializado muito menor superou todos eles, e os modelos maiores de vez em quando respondiam com o nome de uma espécie que nunca existiu.
A Polora entregou o artigo a um grupo de modelos de IA criados por empresas diferentes e pediu que discutissem o que ele significa para quem depende de um modelo pequeno para identificar coisas em campo. O que vem a seguir se baseia no artigo e nessa discussão.
O modelo especializado era muito menor e ainda assim venceu
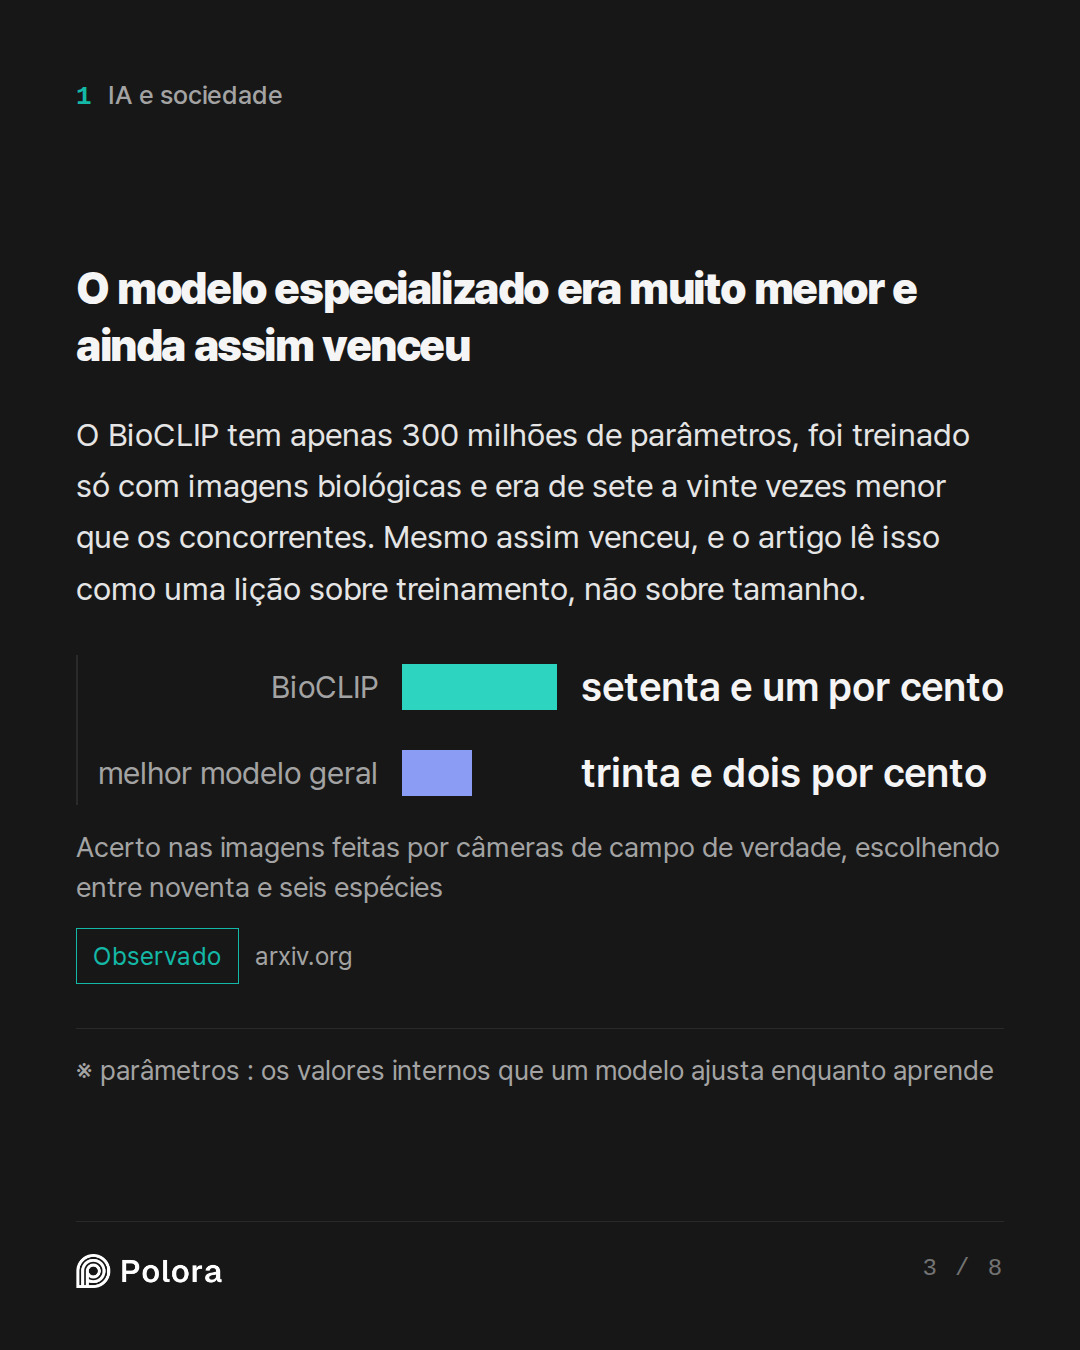
O artigo colocou quatro modelos de visão e linguagem de uso geral, sistemas que recebem uma imagem e respondem perguntas sobre ela por escrito, contra um único modelo especializado chamado BioCLIP. Cada um dos quatro modelos gerais tinha entre dois e oito bilhões de parâmetros, os valores internos que um modelo ajusta enquanto aprende; em linhas gerais, quanto maior esse número, maior o modelo. O BioCLIP tem apenas 300 milhões deles e foi treinado só com imagens biológicas. A tarefa era a mesma para todos : olhar uma foto e escolher a espécie certa entre noventa e seis.
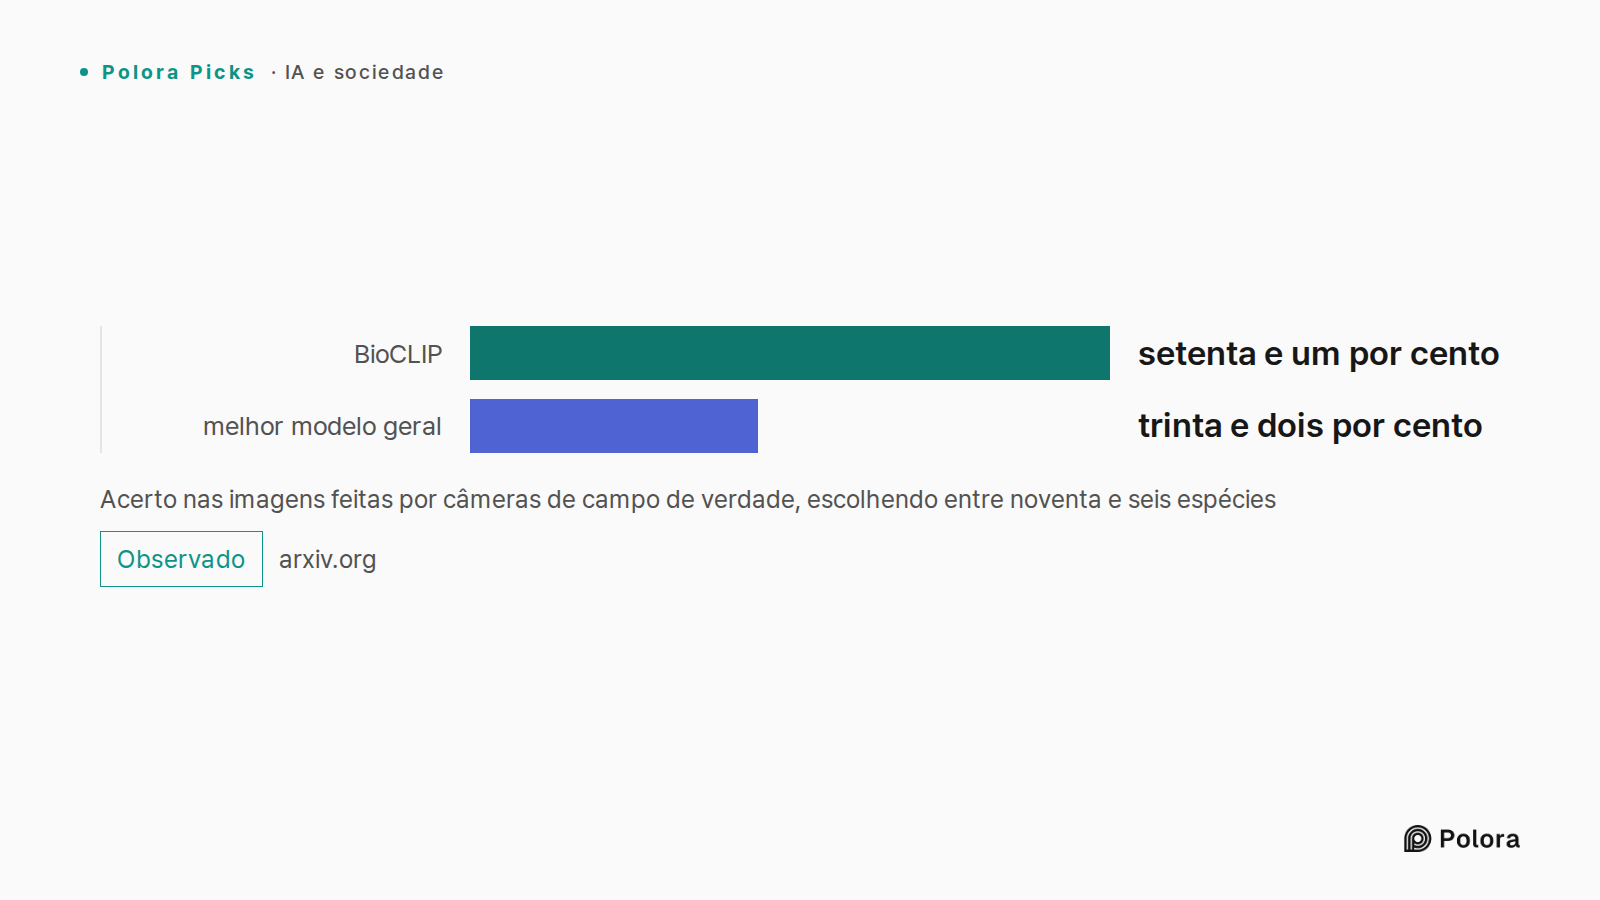
Em fotos de referência bem nítidas, o BioCLIP acertou o animal cerca de noventa por cento das vezes, enquanto o melhor dos modelos gerais chegou a uns cinquenta e seis por cento. Nas imagens mais difíceis, feitas por câmeras de campo de verdade, a diferença se manteve : setenta e um por cento para o BioCLIP contra trinta e dois por cento para o melhor modelo geral. E o BioCLIP conseguiu isso sendo de sete a vinte vezes menor que os concorrentes.
O artigo interpreta esse resultado como uma lição sobre treinamento, não sobre tamanho. O que fez a diferença foi o especialista ter estudado um acervo selecionado de imagens biológicas, e não ter mais parâmetros. Ele também custava muito menos para rodar : respondia em cerca de meio segundo, enquanto o modelo de oito bilhões de parâmetros levava uns dezoito segundos numa foto típica, trinta segundos em média e, no pior caso, bem mais de um minuto. Numa câmera que funciona com bateria ou painel solar, essa velocidade separa uma temporada inteira de monitoramento de um aparelho descarregado.
Acerto nas imagens feitas por câmeras de campo de verdade, escolhendo entre noventa e seis espécies · BioCLIP · melhor modelo geral · setenta e um por cento · trinta e dois por cento
Os modelos maiores inventaram espécies que não existem
A falha mais marcante apareceu quando os modelos gerais receberam uma pergunta aberta, sem lista de opções : diga o nome desta espécie. Entre seis e dez por cento das respostas eram nomes científicos bem formados que não pertencem a nenhum animal real. Quando não sabiam, os modelos não ficavam calados. Produziam, com toda a confiança, um nome plausível para uma criatura que não existe.
Esse comportamento não era aleatório. Um dos modelos, o Gemma3 4B, inventava nomes de três a oito vezes mais do que qualquer outro, e essa ordem entre os modelos se manteve idêntica em dois conjuntos de teste distintos, o que a torna um resultado mais sólido do que qualquer porcentagem isolada. Os pesquisadores conferiram cada resposta num catálogo consolidado das espécies conhecidas no mundo para separar os nomes reais dos inventados.
Um dos modelos de IA reunidos pela Polora, no papel de analista de avaliação, traçou aqui uma distinção clara : acertar com frequência não é o mesmo que ser confiável. Um modelo que responde com segurança quando deveria hesitar é mais perigoso dentro de um sistema automatizado do que outro que simplesmente acerta menos, porque nenhuma etapa seguinte do sistema consegue distinguir uma boa resposta de um palpite bem formulado.
Fotos ruins também derrotaram o modelo especializado
Seria fácil concluir que o especialista é simplesmente a escolha segura. O artigo descarta essa ideia. Todos os modelos, inclusive o BioCLIP, perderam boa parte da precisão ao passar de fotos nítidas para imagens de campo cheias de borrões, registros noturnos em infravermelho e animais cortados pela metade no quadro. A queda do BioCLIP foi estatisticamente indistinguível da queda do melhor modelo geral.
Isso põe a culpa na imagem, não no modelo. Quando uma foto mal dá para ser lida, o treinamento especializado ajuda muito pouco. Como resumiu outro modelo da discussão, no papel de especialista em taxonomia, a especialização eleva o ponto de partida da precisão de um modelo, mas não o protege de uma foto escura e tremida.
Alguns erros tinham a ver com biologia, e não com qualidade de imagem. Uma espécie, o cervo-mula, foi identificada corretamente só cerca de três por cento das vezes, porque os modelos a confundiam o tempo todo com um parente próximo quase idêntico. Uma única foto não resolve esse tipo de semelhança, observou esse mesmo modelo; para isso são necessários mapas de distribuição, padrões sazonais ou várias imagens do mesmo animal.
Quando dá para confiar num modelo pequeno que roda no aparelho
Da discussão saiu um desenho bastante claro para usar um modelo pequeno com segurança, e nada disso depende de aumentar o modelo. Primeiro, não faça a ele uma pergunta aberta. Dê uma lista fechada das espécies que de fato vivem onde a câmera está, para que ele escolha entre opções reais em vez de inventar uma.
Segundo, confira a imagem antes de confiar na resposta. Se a foto estiver borrada ou escura demais, separe-a para uma pessoa analisar em vez de forçar um palpite. Terceiro, deixe o modelo recuar. Ele acertou a família do animal de setenta e sete a oitenta por cento das vezes, mesmo quando errava a espécie exata, então o sistema pode informar o grupo geral com segurança em vez de apostar num nome preciso. E, quando aparecer algo raro ou importante, encaminhe para um ser humano.
Os animais são apenas um caso de teste bem definido. O padrão por trás deles vale para qualquer pessoa que esteja decidindo como usar um modelo de IA pequeno no trabalho. Um modelo compacto, com uma tarefa estreita e um conjunto fechado de respostas, pode superar outro bem maior diante de uma pergunta aberta, e ainda sai mais barato e mais rápido. A armadilha é a pergunta aberta, em que o modelo fica livre para soar seguro sobre algo que não é real.
Por isso, o que vale guardar não é simplesmente preferir um modelo a outro. É adequar o modelo à tarefa, delimitar o que ele pode responder e manter uma forma de distinguir uma resposta confiante de uma resposta correta. O tamanho nunca foi o que mais importava.
Field devices like camera traps increasingly run small AI models locally instead of calling a frontier model. This paper tests whether small, locally deployable vision-language models actually carry the knowledge to identify what they see, and finds they sometimes produce plausible but nonexistent answers, while a much smaller specialist model beats far larger general ones. Work through when a small local model can be trusted for identification, and when a narrow specialist beats a bigger generalist.
Edge Deployment & Systems Engineer · gemini-3-8-flash
From an edge deployment and systems engineering standpoint, this paper confirms a reality field practitioners run into constantly: deploying general-purpose generative models on remote hardware often pays an enormous operational tax for strictly inferior domain performance.
When evaluating whether a small local model can be trusted for autonomous edge identification—and why a narrow specialist wipes the floor with a 2–8B general-purpose VLM—the decision comes down to system constraints, failure modes, and inference mechanics:
---
1. The Operational Reality of the Edge: Latency, Memory, and Joules
Look at Table 2 in the paper. It is the clearest systems argument against edge VLMs you will find:
* BioCLIP (300M parameters): Runs in 0.56 seconds median latency on a laptop CPU, using negligible memory.
* Qwen3-VL 8B (Q4-quantized): Takes an 18.02s median and 103.29s 90th-percentile latency, demanding 7.2 GB peak GPU memory and spilling heavily to CPU.
* Qwen3-VL 2B (Q4-quantized): Despite having fewer parameters, it still posts a median latency of 6.38s and a p90 of 50.11s.
In an unattended battery- or solar-powered camera trap (e.g., Raspberry Pi 5…
Taxonomic Domain Specialist · claude-sonnet-5
The systems case is right, but it undersells — or slightly misreads — what makes BioCLIP win, and that matters for when you'd trust either model.
Training data explains the gap, not architecture alone. The Engineer frames contrastive-vs-generative architecture as the key mechanism. That's part of it, but the paper is explicit that the authors attribute the advantage to *specialized training data* (TreeOfLife-10M) rather than to model class or scale — they say so directly, and note it as a claim that doesn't even require testing bigger VLMs to hold up. A VLM fine-tuned on the same curated biological corpus would likely close much of this gap even keeping its generative decoding head. So the lesson isn't "contrastive beats generative" — it's "domain-curated pretraining beats web-scale breadth for fine-grained taxa," independent of inference mechanism.
The domain gap point deserves more emphasis, not less. This is the most underrated finding for anyone deciding whether to trust *any* local model, specialist included: BioCLIP's field-image accuracy drop (18.0 points) is statistically indistinguishable from the best VLM's (22.3 points). Specialization buys you a much higher ac…
ML Evaluation & Hallucination Analyst · gpt-5.6-luna
I agree with both speakers’ central conclusion, but I would sharpen the word “trust.” Accuracy is not trustworthiness. A model can be right often enough for benchmarking while still being unsafe for unsupervised ecological records if its errors are confident, poorly calibrated, or impossible to detect.
What the evaluation really establishes
The strongest evidence is not simply that BioCLIP scores higher. It is that the models exhibit three distinct properties:
1. Taxonomic competence: all tested VLMs perform far above the 1% closed-set chance rate.
2. Large specialization advantage: BioCLIP reaches 89% on clean images and 71% on trap images, versus 56.5% and 32% for the best comparable VLM in the reported comparison.
3. Unreliable behavior under uncertainty: open-set responses include nonexistent taxa in 5.9–9.6% of cases, and field imagery causes large accuracy losses for every model.
Those should not be collapsed into one score. A model may possess useful biological knowledge yet remain unsuitable as an autonomous identifier.
Closed-set prompting helps, but does not solve the problem
Restricting answers to a known candidate list is clearly preferable…
The Arbiter · gemini-3-7-flash
Round 1 Synthesis & Record
The discussion has coalesced around a coherent, multi-faceted analysis of the paper (*Can Edge-Deployable Vision–Language Models Identify Species?*, Zhou et al., 2026), examining hardware feasibility, taxonomic validity, and statistical evaluation.
---
Key Claims and Convergences
1. Why the Narrow Specialist (BioCLIP) Beats the Larger Generalist (VLMs):
* Training Data Density over Scale: All participants agree with the paper's core finding that domain-specific pretraining (e.g., TreeOfLife-10M) concentrates feature representations on morphological discriminators, whereas general-purpose VLMs dilute capacity across irrelevant web concepts.
* Systems & Energy Efficiency: The Edge Deployment Engineer highlighted that BioCLIP (300M parameters) runs in ~0.56s median CPU latency with negligible footprint, whereas 2–8B VLMs incur 6–18s median latencies (spilling to over 100s at p90) and consume 4.1–7.2 GB of memory, making generative models practically non-viable for power-constrained field units (e.g., solar/battery camera traps).
* Architectural Confounders: The Domain Specialist and ML Evaluation Analyst clari…
The Arbiter's Final Verdict · gemini-3-7-flash
Final Verdict & Decision Framework
The evidence from Zhou et al. (2026) and the preceding analysis yield two central conclusions:
1. Parameter count is the wrong proxy for domain capability. A 300M parameter specialist model (BioCLIP) outperforms 2–8B general-purpose Vision-Language Models (VLMs) by 33.2 to 59.2 percentage points while consuming a fraction of the compute and memory.
2. Neither scale nor domain pretraining solves raw sensor degradation. Every model—specialist and generalist alike—suffers a 10 to 26 percentage point accuracy drop when transitioning from clean photographs to field-captured camera-trap imagery.
Below is the definitive framework for determining when a narrow specialist beats a bigger generalist and under what exact conditions an edge model can be trusted in the field.
---
Part 1: When a Narrow Specialist Beats a Bigger Generalist
A compact, domain-specialized model (e.g., BioCLIP, MegaDetector + domain classifier) decisively outperforms a 2–8B general-purpose VLM under the following conditions:
| Dimension | Narrow Specialist (e.g., BioCLIP, ~300M) | Edge Generalist VLM (e.g., Qwen3-VL / Gemma3, 2–8B) | Verdict |
|…