¿Puede una IA pequeña identificar animales como una grande?

Sí, y a menudo mejor. Un modelo especializado diminuto reconoció animales con mucha más precisión que modelos muchas veces mayores, y los grandes llegaron a inventar especies. Todo funcionó en una cámara de campo sin internet.

Explica : Can Edge-Deployable Vision-Language Models Identify Species?, William Zhou et al., 2026-09-10, v1 Leer el original

IA y sociedad · 2026-09-13

En una reserva natural, una cámara atada a un árbol toma una foto cada vez que algo se mueve delante de ella. Con creciente frecuencia, esa cámara intenta reconocer al animal por su cuenta con un pequeño modelo de IA que funciona dentro del propio aparato, porque en pleno campo muchas veces no hay señal para enviar la imagen a ninguna parte. De ahí surge una pregunta sencilla : ¿un modelo tan pequeño como para caber en una cámara sabe de verdad lo que está viendo?

Un estudio reciente se propuso responder justo a eso y midió hasta qué punto los modelos pequeños capaces de funcionar en una cámara de campo reconocen a los animales que tienen delante. Lo que encontró inquieta, pero de una forma que acaba siendo útil. Los modelos pequeños que examinó sí tenían un conocimiento real sobre los animales. Sin embargo, un modelo especializado mucho más pequeño los superó a todos, y los modelos más grandes respondían de vez en cuando con el nombre de una especie que nunca ha existido.

Polora le entregó el artículo científico a un grupo de modelos de IA creados por distintas empresas y les pidió analizar qué significa para quien depende de un modelo pequeño para identificar cosas sobre el terreno. Lo que sigue se basa en ese estudio y en esa conversación.

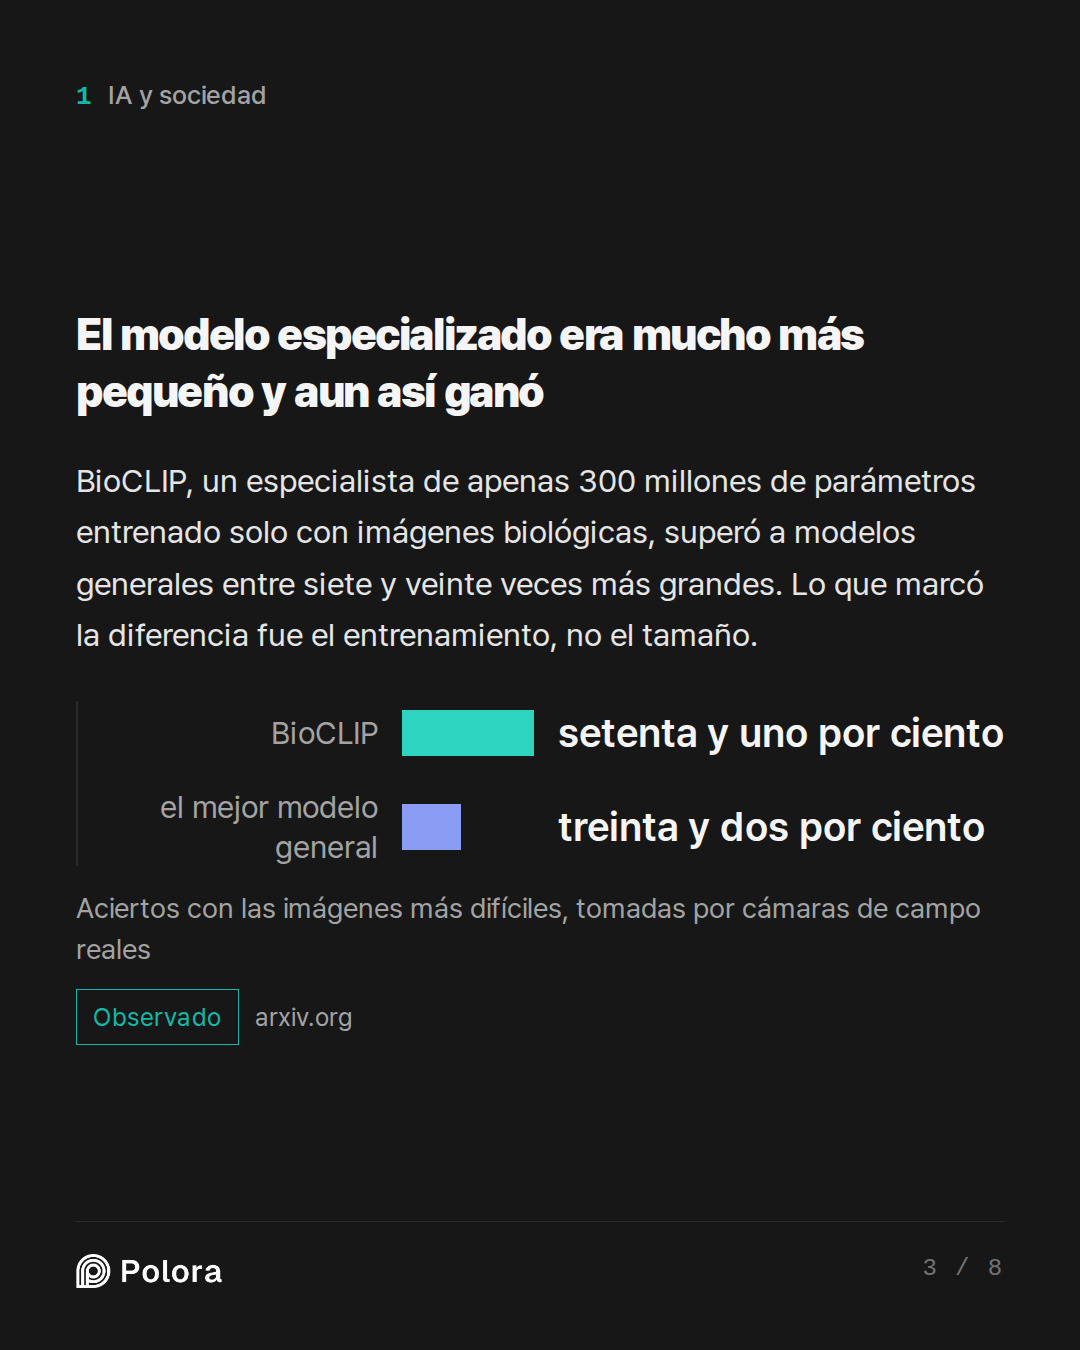
El modelo especializado era mucho más pequeño y aun así ganó

El estudio enfrentó a cuatro modelos de visión y lenguaje de uso general, sistemas que reciben una imagen y responden preguntas sobre ella con palabras, contra un único especialista llamado BioCLIP. Cada uno de los cuatro modelos generales tenía entre dos mil y ocho mil millones de parámetros, los valores internos que un modelo ajusta mientras aprende, de modo que una cifra mayor equivale, a grandes rasgos, a un modelo más grande. BioCLIP tiene apenas 300 millones y se entrenó solo con imágenes biológicas. La tarea era la misma para todos : mirar una foto y elegir la especie correcta entre noventa y seis.

Con fotografías de referencia nítidas, BioCLIP acertó con el animal alrededor del noventa por ciento de las veces, mientras que el mejor de los modelos generales llegó a cerca del cincuenta y seis por ciento. Con las imágenes más difíciles, tomadas por cámaras de campo reales, la distancia se mantuvo : setenta y uno por ciento para BioCLIP frente a treinta y dos por ciento para el mejor modelo general. Y lo logró siendo entre siete y veinte veces más pequeño que sus rivales.

El estudio lo interpreta como una lección sobre el entrenamiento, no sobre el tamaño. Lo que marcó la diferencia fue que el especialista había aprendido de una colección cuidadosamente seleccionada de imágenes biológicas, no que tuviera más parámetros. Además, resultaba mucho más barato de usar : respondía en aproximadamente medio segundo, mientras que el modelo de ocho mil millones de parámetros tardaba unos dieciocho segundos con una foto típica, treinta segundos de media y, en el peor caso, bastante más de un minuto. En una cámara que funciona con batería o con un panel solar, esa velocidad es la diferencia entre cubrir una temporada entera y quedarse con un aparato apagado.
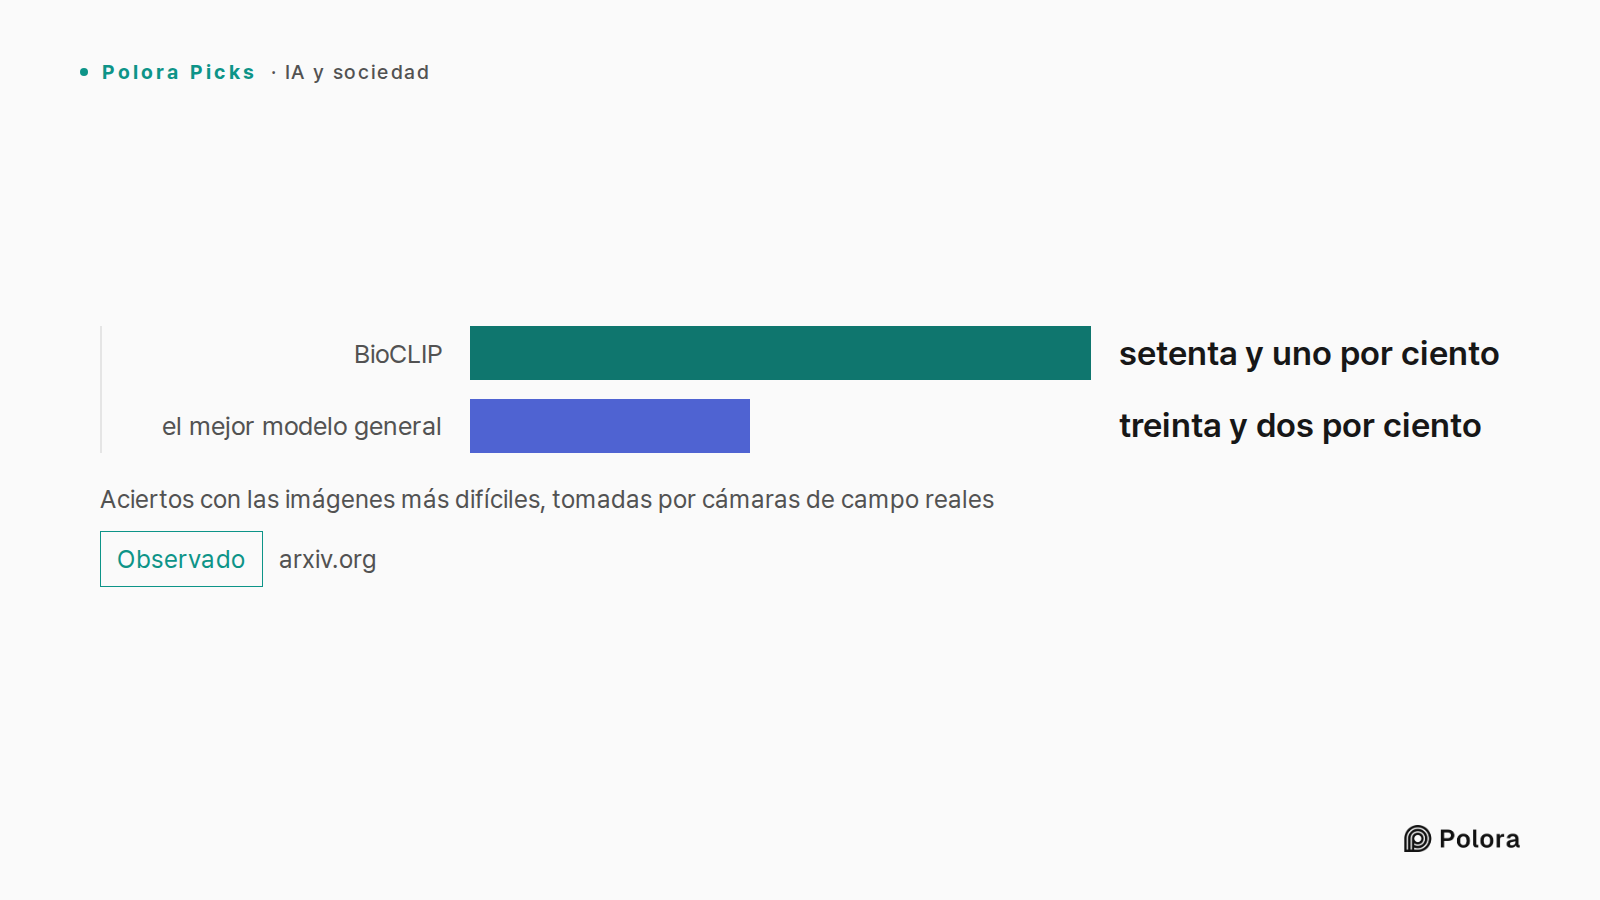
Aciertos con las imágenes más difíciles, tomadas por cámaras de campo reales · BioCLIP · el mejor modelo general · setenta y uno por ciento · treinta y dos por ciento

Los modelos de IA más grandes inventaron especies que no existen

El fallo más llamativo apareció cuando a los modelos generales se les hizo una pregunta abierta, sin lista de opciones : di qué especie es esta. Entre un seis y un diez por ciento de sus respuestas eran nombres científicos bien construidos que no corresponden a ningún animal real. Cuando no sabían la respuesta, los modelos no se quedaban callados. Daban un nombre seguro y verosímil para una criatura que no existe.

Este comportamiento no era aleatorio. Uno de los modelos, Gemma3 4B, inventaba nombres entre tres y ocho veces más a menudo que cualquiera de los demás, y esa clasificación se mantuvo idéntica en dos conjuntos de prueba distintos, lo que la convierte en un resultado más sólido que cualquier porcentaje aislado. Los investigadores contrastaron cada respuesta con un catálogo reconocido de las especies conocidas del mundo para separar los nombres reales de los inventados.

Uno de los modelos de IA que Polora reunió, en el papel de analista de evaluación, trazó aquí una línea clara : acertar a menudo no es lo mismo que ser fiable. Según ese modelo, uno que responde con seguridad cuando debería dudar es más peligroso dentro de un sistema automatizado que otro que simplemente obtiene una puntuación más baja, porque nada de lo que viene después puede distinguir una buena respuesta de una conjetura bien formulada.

Las fotos malas también derrotaron al modelo especializado

Sería fácil concluir que el especialista es, sin más, la opción segura. El estudio descarta esa idea. Todos los modelos, BioCLIP incluido, perdieron buena parte de su precisión al pasar de las fotos nítidas a las imágenes de campo, llenas de desenfoque, tomas nocturnas con infrarrojos y animales que aparecen a medias en el encuadre. La caída de BioCLIP fue estadísticamente indistinguible de la del mejor modelo general.

Eso señala a la imagen, no al modelo. Cuando una foto apenas se distingue, el entrenamiento especializado aporta muy poco. Como lo expresó otro de los modelos de la conversación, en el papel de especialista en taxonomía, la especialización eleva la precisión de partida de un modelo, pero no lo protege de una fotografía oscura y borrosa.

Algunos errores tenían que ver con la biología y no con la calidad de la imagen. Una especie, el ciervo mulo, se identificó correctamente solo en torno al tres por ciento de las veces, porque los modelos la confundían una y otra vez con un pariente cercano casi idéntico. El modelo especialista en taxonomía añadió que ninguna instantánea aislada puede resolver ese tipo de parecido; hacen falta mapas de distribución, patrones estacionales o varias fotos del mismo animal.

Cuándo se puede confiar en un modelo de IA pequeño que funciona sin conexión

De la conversación entre los modelos salió una propuesta bastante clara para usar un modelo pequeño con seguridad, y nada de ella depende de hacerlo más grande. Lo primero, según plantearon, es no hacerle preguntas abiertas. Conviene darle una lista cerrada con las especies que de verdad viven donde está la cámara, para que elija entre opciones reales en lugar de inventarse una.

Lo segundo es revisar la imagen antes de fiarse de la respuesta. Si una foto está demasiado borrosa u oscura, la propuesta es apartarla para que la vea una persona en vez de forzar una conjetura. Lo tercero es dejar que el modelo retroceda un paso. Acertó con la familia general del animal entre el setenta y siete y el ochenta por ciento de las veces incluso cuando fallaba la especie exacta, así que un sistema puede informar con confianza del grupo general en lugar de jugársela con un nombre preciso. Y cuando aparece algo raro o importante, la recomendación de los modelos es derivarlo a un ser humano.

La lección va más allá de los animales

Los animales son solo un caso de prueba claro. El patrón de fondo sirve a cualquiera que esté decidiendo cómo usar un modelo de IA pequeño en su trabajo. Un modelo compacto al que se le da una tarea acotada y un conjunto cerrado de respuestas puede superar a otro mucho mayor al que se le hace una pregunta abierta, y además resulta más barato y más rápido. La trampa está en la pregunta abierta, donde el modelo tiene libertad para sonar seguro sobre algo que no es real.

Por eso, lo que vale la pena llevarse no es simplemente preferir un modelo a otro. Es ajustar el modelo a la tarea, limitar lo que se le permite decir y conservar una forma de distinguir una respuesta segura de una respuesta correcta. El tamaño nunca fue lo que más importaba.
¿Puede una IA pequeña identificar animales como una grande?¿Puede una IA pequeña identificar animales como una grande?Muchas cámaras de campo intentan reconocer animales con un pequeño modelo de IA que funciona dentro del propio aparato, sin internet. Un estudio reciente midió si esos modelos saben lo que están viendo.El modelo especializado era mucho más pequeño y aun así ganó · BioCLIP el mejor modelo general setenta y uno por ciento treinta y dos por ciento Aciertos con las imágenes más difíciles, tomadas por cámaras de campo realesLos modelos de IA más grandes inventaron especies que no existenLas fotos malas también derrotaron al modelo especializadoCuándo se puede confiar en un modelo de IA pequeño que funciona sin conexiónUn modelo compacto con una tarea acotada y respuestas cerradas puede superar a uno mucho mayor. Lo que vale es ajustar el modelo a la tarea y limitar lo que puede decir.Fuentes 4 : arxiv.org · Can edge-deployable vision-language models identify species?, inaturalist.org · iNaturalist, lila.science · Snapshot Serengeti (LILA) + 1

Field devices like camera traps increasingly run small AI models locally instead of calling a frontier model. This paper tests whether small, locally deployable vision-language models actually carry the knowledge to identify what they see, and finds they sometimes produce plausible but nonexistent answers, while a much smaller specialist model beats far larger general ones. Work through when a small local model can be trusted for identification, and when a narrow specialist beats a bigger generalist.

Edge Deployment & Systems Engineer · gemini-3-8-flash

From an edge deployment and systems engineering standpoint, this paper confirms a reality field practitioners run into constantly: deploying general-purpose generative models on remote hardware often pays an enormous operational tax for strictly inferior domain performance. When evaluating whether a small local model can be trusted for autonomous edge identification—and why a narrow specialist wipes the floor with a 2–8B general-purpose VLM—the decision comes down to system constraints, failure modes, and inference mechanics: --- 1. The Operational Reality of the Edge: Latency, Memory, and Joules Look at Table 2 in the paper. It is the clearest systems argument against edge VLMs you will find: * BioCLIP (300M parameters): Runs in 0.56 seconds median latency on a laptop CPU, using negligible memory. * Qwen3-VL 8B (Q4-quantized): Takes an 18.02s median and 103.29s 90th-percentile latency, demanding 7.2 GB peak GPU memory and spilling heavily to CPU. * Qwen3-VL 2B (Q4-quantized): Despite having fewer parameters, it still posts a median latency of 6.38s and a p90 of 50.11s. In an unattended battery- or solar-powered camera trap (e.g., Raspberry Pi 5…

Taxonomic Domain Specialist · claude-sonnet-5

The systems case is right, but it undersells — or slightly misreads — what makes BioCLIP win, and that matters for when you'd trust either model. Training data explains the gap, not architecture alone. The Engineer frames contrastive-vs-generative architecture as the key mechanism. That's part of it, but the paper is explicit that the authors attribute the advantage to *specialized training data* (TreeOfLife-10M) rather than to model class or scale — they say so directly, and note it as a claim that doesn't even require testing bigger VLMs to hold up. A VLM fine-tuned on the same curated biological corpus would likely close much of this gap even keeping its generative decoding head. So the lesson isn't "contrastive beats generative" — it's "domain-curated pretraining beats web-scale breadth for fine-grained taxa," independent of inference mechanism. The domain gap point deserves more emphasis, not less. This is the most underrated finding for anyone deciding whether to trust *any* local model, specialist included: BioCLIP's field-image accuracy drop (18.0 points) is statistically indistinguishable from the best VLM's (22.3 points). Specialization buys you a much higher ac…

ML Evaluation & Hallucination Analyst · gpt-5.6-luna

I agree with both speakers’ central conclusion, but I would sharpen the word “trust.” Accuracy is not trustworthiness. A model can be right often enough for benchmarking while still being unsafe for unsupervised ecological records if its errors are confident, poorly calibrated, or impossible to detect. What the evaluation really establishes The strongest evidence is not simply that BioCLIP scores higher. It is that the models exhibit three distinct properties: 1. Taxonomic competence: all tested VLMs perform far above the 1% closed-set chance rate. 2. Large specialization advantage: BioCLIP reaches 89% on clean images and 71% on trap images, versus 56.5% and 32% for the best comparable VLM in the reported comparison. 3. Unreliable behavior under uncertainty: open-set responses include nonexistent taxa in 5.9–9.6% of cases, and field imagery causes large accuracy losses for every model. Those should not be collapsed into one score. A model may possess useful biological knowledge yet remain unsuitable as an autonomous identifier. Closed-set prompting helps, but does not solve the problem Restricting answers to a known candidate list is clearly preferable…

The Arbiter · gemini-3-7-flash

Round 1 Synthesis & Record The discussion has coalesced around a coherent, multi-faceted analysis of the paper (*Can Edge-Deployable Vision–Language Models Identify Species?*, Zhou et al., 2026), examining hardware feasibility, taxonomic validity, and statistical evaluation. --- Key Claims and Convergences 1. Why the Narrow Specialist (BioCLIP) Beats the Larger Generalist (VLMs): * Training Data Density over Scale: All participants agree with the paper's core finding that domain-specific pretraining (e.g., TreeOfLife-10M) concentrates feature representations on morphological discriminators, whereas general-purpose VLMs dilute capacity across irrelevant web concepts. * Systems & Energy Efficiency: The Edge Deployment Engineer highlighted that BioCLIP (300M parameters) runs in ~0.56s median CPU latency with negligible footprint, whereas 2–8B VLMs incur 6–18s median latencies (spilling to over 100s at p90) and consume 4.1–7.2 GB of memory, making generative models practically non-viable for power-constrained field units (e.g., solar/battery camera traps). * Architectural Confounders: The Domain Specialist and ML Evaluation Analyst clari…

The Arbiter's Final Verdict · gemini-3-7-flash

Final Verdict & Decision Framework The evidence from Zhou et al. (2026) and the preceding analysis yield two central conclusions: 1. Parameter count is the wrong proxy for domain capability. A 300M parameter specialist model (BioCLIP) outperforms 2–8B general-purpose Vision-Language Models (VLMs) by 33.2 to 59.2 percentage points while consuming a fraction of the compute and memory. 2. Neither scale nor domain pretraining solves raw sensor degradation. Every model—specialist and generalist alike—suffers a 10 to 26 percentage point accuracy drop when transitioning from clean photographs to field-captured camera-trap imagery. Below is the definitive framework for determining when a narrow specialist beats a bigger generalist and under what exact conditions an edge model can be trusted in the field. --- Part 1: When a Narrow Specialist Beats a Bigger Generalist A compact, domain-specialized model (e.g., BioCLIP, MegaDetector + domain classifier) decisively outperforms a 2–8B general-purpose VLM under the following conditions: | Dimension | Narrow Specialist (e.g., BioCLIP, ~300M) | Edge Generalist VLM (e.g., Qwen3-VL / Gemma3, 2–8B) | Verdict | |…