Interroger plusieurs IA et faire débattre des IA, ce n'est pas la même chose
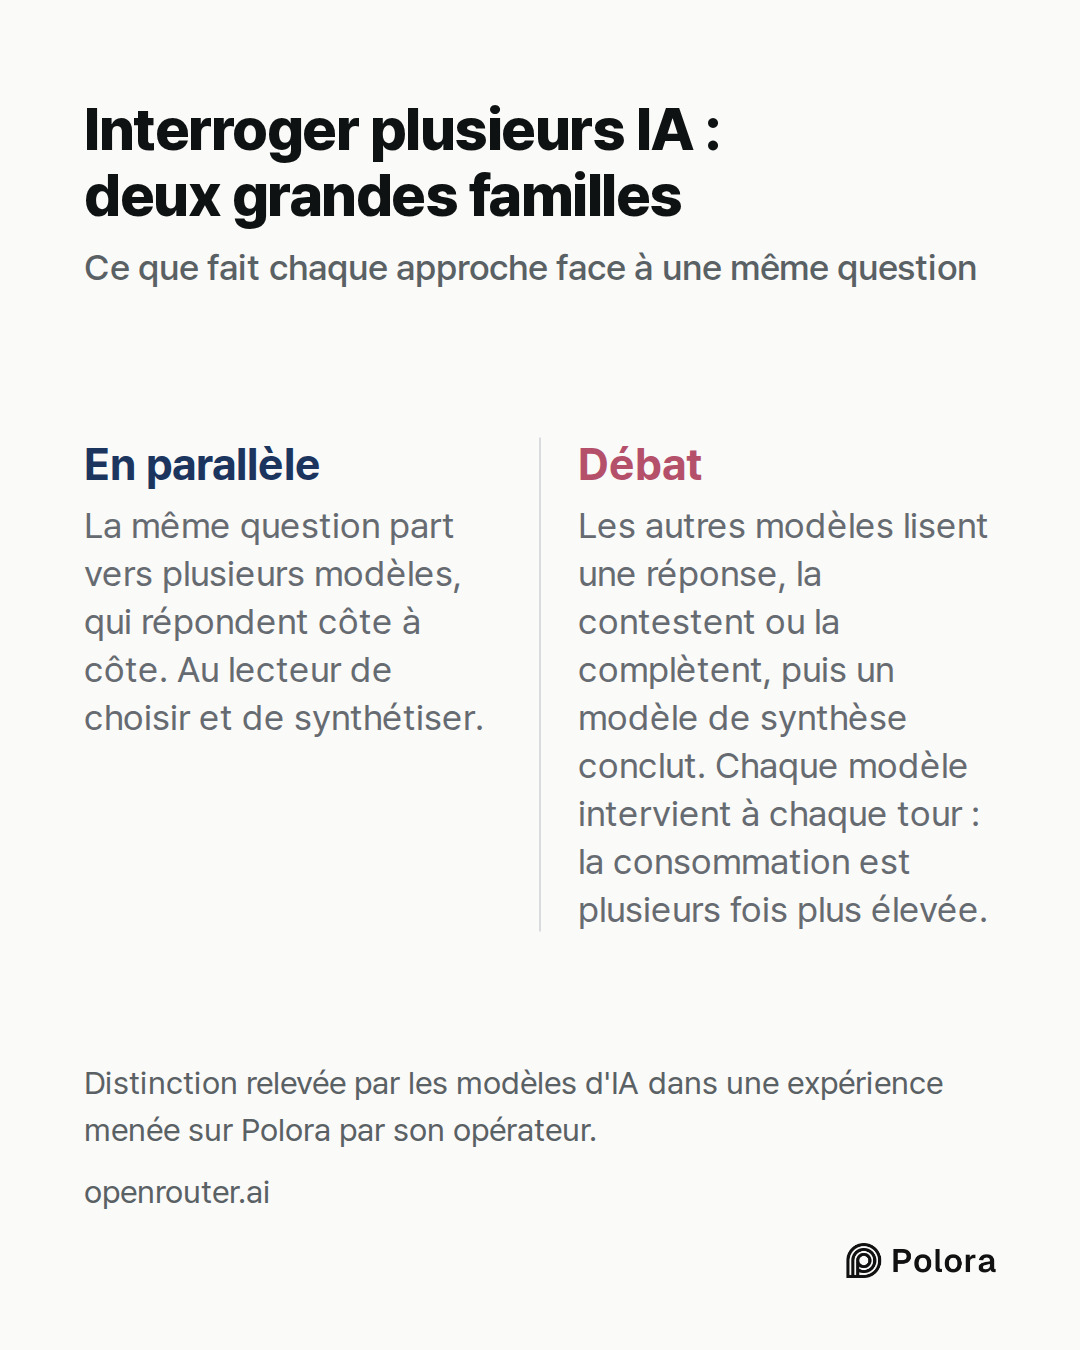
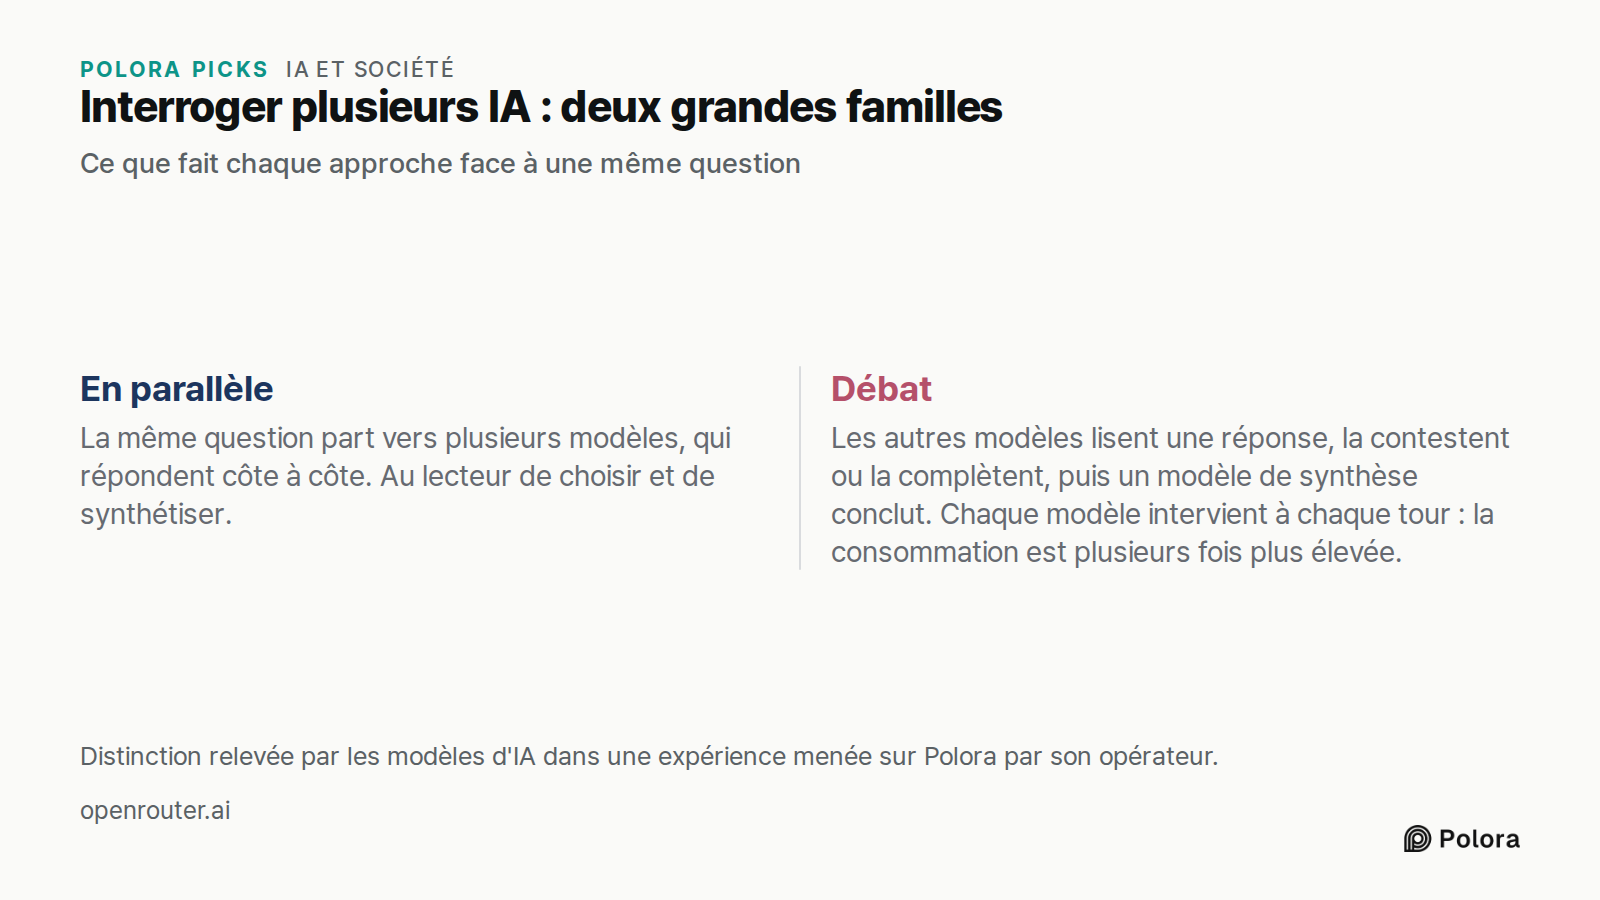
Beaucoup de services envoient une même question à plusieurs IA d'un coup. Des modèles d'IA à qui l'on a demandé de les comparer ont souligné à plusieurs reprises que ces services se rangent en deux grandes familles.
La première est la comparaison en parallèle. La même question part vers plusieurs modèles, et leurs réponses s'affichent côte à côte à l'écran. C'est ensuite à l'utilisateur de choisir la meilleure et d'en faire la synthèse. La seconde est le débat. Les autres modèles lisent la réponse d'un modèle, la contestent ou la complètent, puis un modèle chargé de la synthèse rassemble les conclusions.
Vu de l'extérieur, les deux reviennent à « interroger plusieurs IA », mais le travail accompli diffère. Le modèle chargé d'évaluer les coûts a fait remarquer que la dépense ne se calcule pas non plus de la même façon. Dans un débat, chaque modèle intervient à chaque tour : une seule question sollicite donc les IA autant de fois que le nombre de modèles multiplié par le nombre d'échanges. La quantité de texte traitée, que les services facturent en « jetons » (tokens), est ainsi plusieurs fois plus élevée qu'avec une simple comparaison côte à côte. D'où sa conclusion : le seul tarif mensuel ne dit pas combien coûte réellement une question.
Cette comparaison a été faite par des modèles d'IA, sur Polora même
Une précision d'abord. Cette expérience a été menée sur Polora par l'opérateur de Polora, et Polora figure parmi les services comparés. La question posée par l'opérateur était : « Analyse comparative de polora.ai et des services de débat entre IA qui interrogent plusieurs IA en même temps. Quel service est le meilleur ? Dresser la liste des services réels et faire le point ».
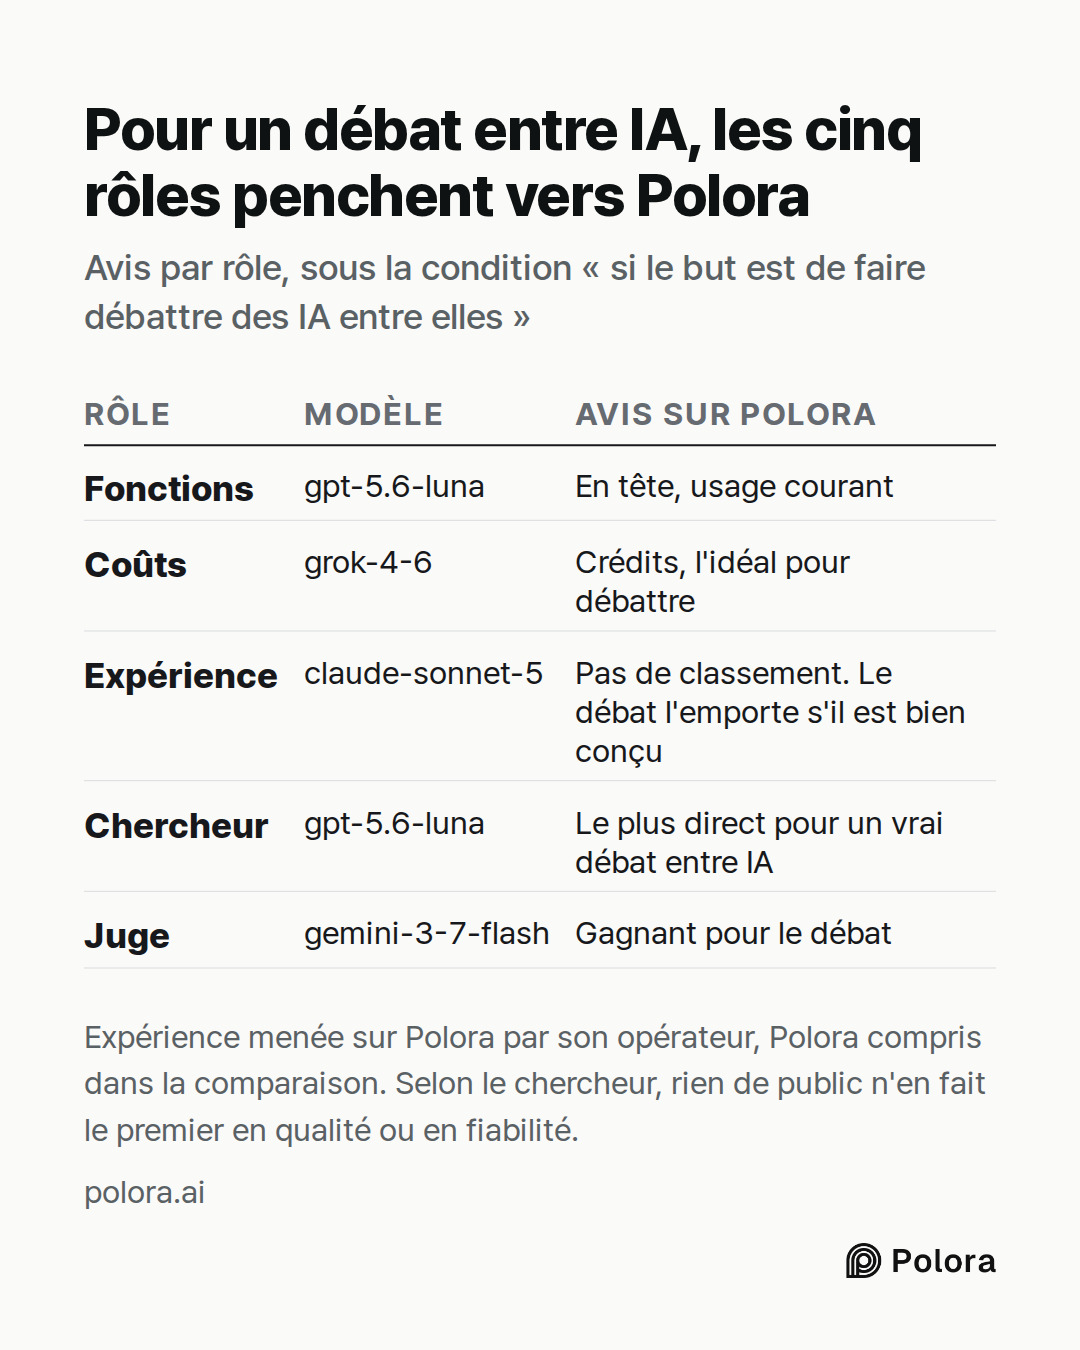
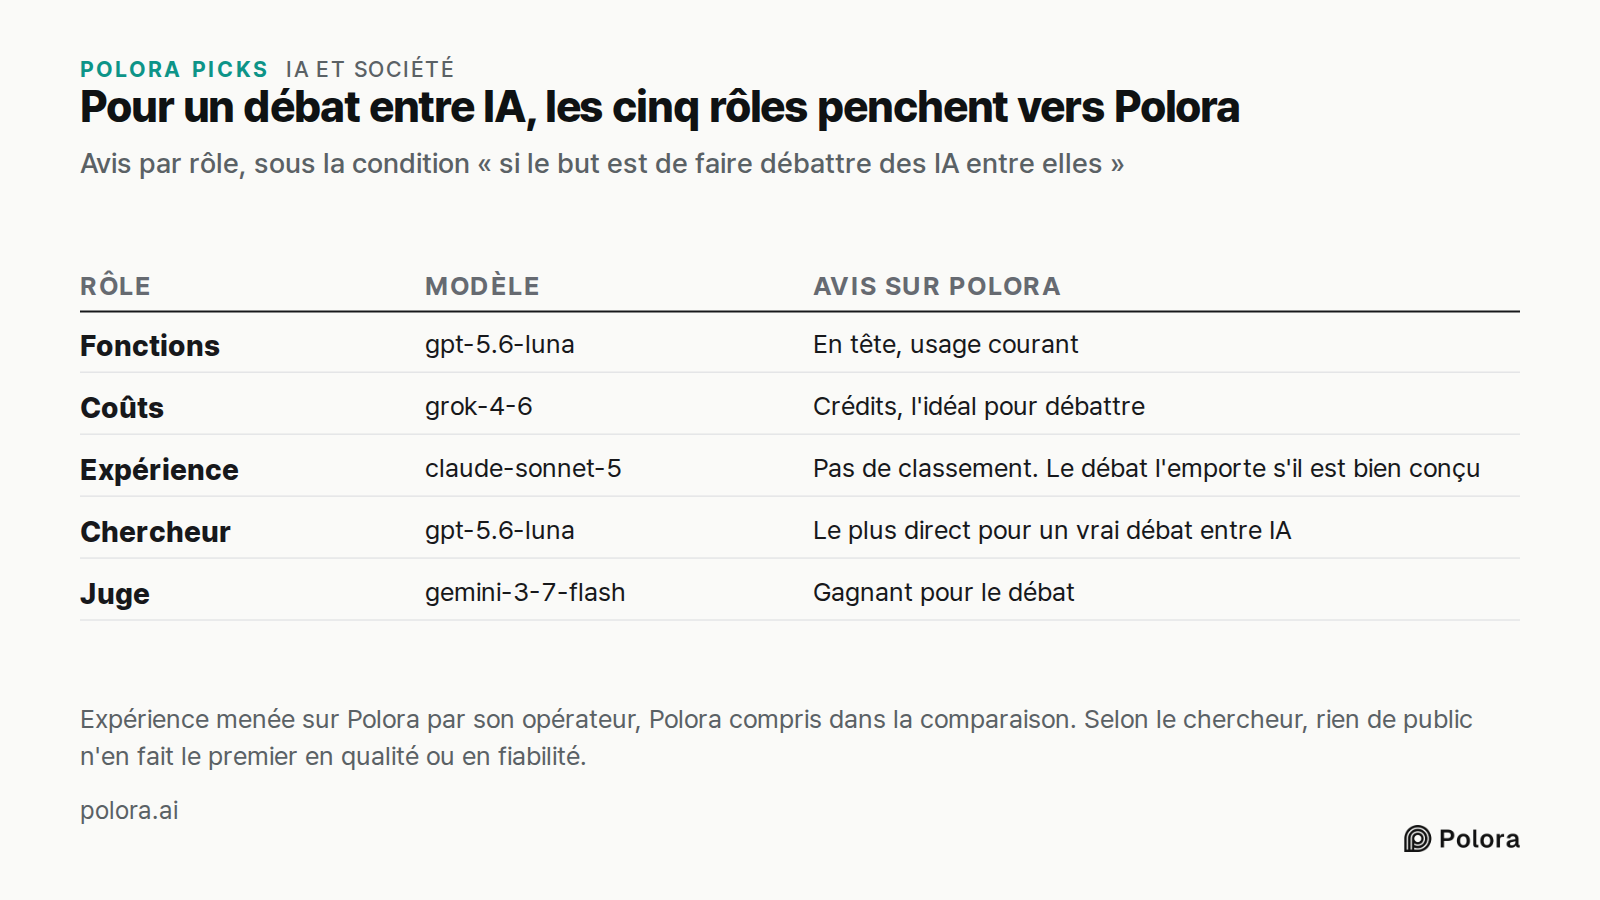
Les participants ne sont pas des personnes mais quatre modèles d'IA conçus par quatre entreprises différentes, qui se sont partagé cinq rôles. L'analyse des fonctionnalités revenait à gpt-5.6-luna d'OpenAI, l'évaluation des coûts à grok-4-6 de xAI, et l'analyse de l'expérience utilisateur à claude-sonnet-5 d'Anthropic. Le rôle de chercheur, qui vérifie les faits sur le web, était aussi tenu par gpt-5.6-luna, et le rôle de juge, qui a organisé l'échange et rendu la décision finale, par gemini-3-7-flash de Google.
En pleine discussion, le modèle chargé de l'expérience utilisateur a d'ailleurs fait remarquer que « cette conversation en est elle-même l'exemple ». Autrement dit, les modèles évaluaient un service depuis l'intérieur de ce même service. Cet article ne perd pas ce fait de vue.
Pour faire débattre des IA, les modèles ont cité Polora en premier
Chaque rôle regardait des aspects différents, mais les réponses formulées sous la condition « si le but est de faire débattre des IA entre elles » allaient toutes dans le même sens.
Le modèle chargé des fonctionnalités a placé Polora en tête de son classement pour un utilisateur ordinaire. Le modèle chargé des coûts a jugé que le système de crédits de Polora convenait le mieux à un usage de débat. Sans abonnement, on achète des crédits à l'avance et on les dépense au fil de l'usage, ce qui, selon lui, convient à quelqu'un qui ne s'en sert pas tous les jours mais seulement de temps en temps, pour des questions importantes.
Le modèle chargé de l'expérience utilisateur n'a pas établi de classement. Il a expliqué que la comparaison en parallèle laisse à l'utilisateur l'effort de lire plusieurs réponses et d'en faire la synthèse, alors que le débat transfère cet effort aux IA elles-mêmes, et il a estimé qu'une structure de débat comme celle de Polora l'emporte. Il a toutefois précisé que cet avantage dépend largement de la qualité de la synthèse et de la façon dont le débat est organisé.
Sur les pages officielles, le chercheur a vérifié trois choses. Le service se présente comme un lieu où les modèles débattent pendant qu'un chercheur vérifie les faits. Il propose des packs de crédits à partir de 10 dollars. Il existe aussi une formule à 10 dollars par mois pour qui utilise sa propre clé d'API, c'est-à-dire un accès obtenu directement auprès d'une entreprise d'IA. Le chercheur a conclu que Polora est « le choix le plus direct si un vrai débat entre IA est la priorité », et le juge a lui aussi désigné Polora vainqueur pour cet usage.
Quand le but change, le service recommandé change aussi
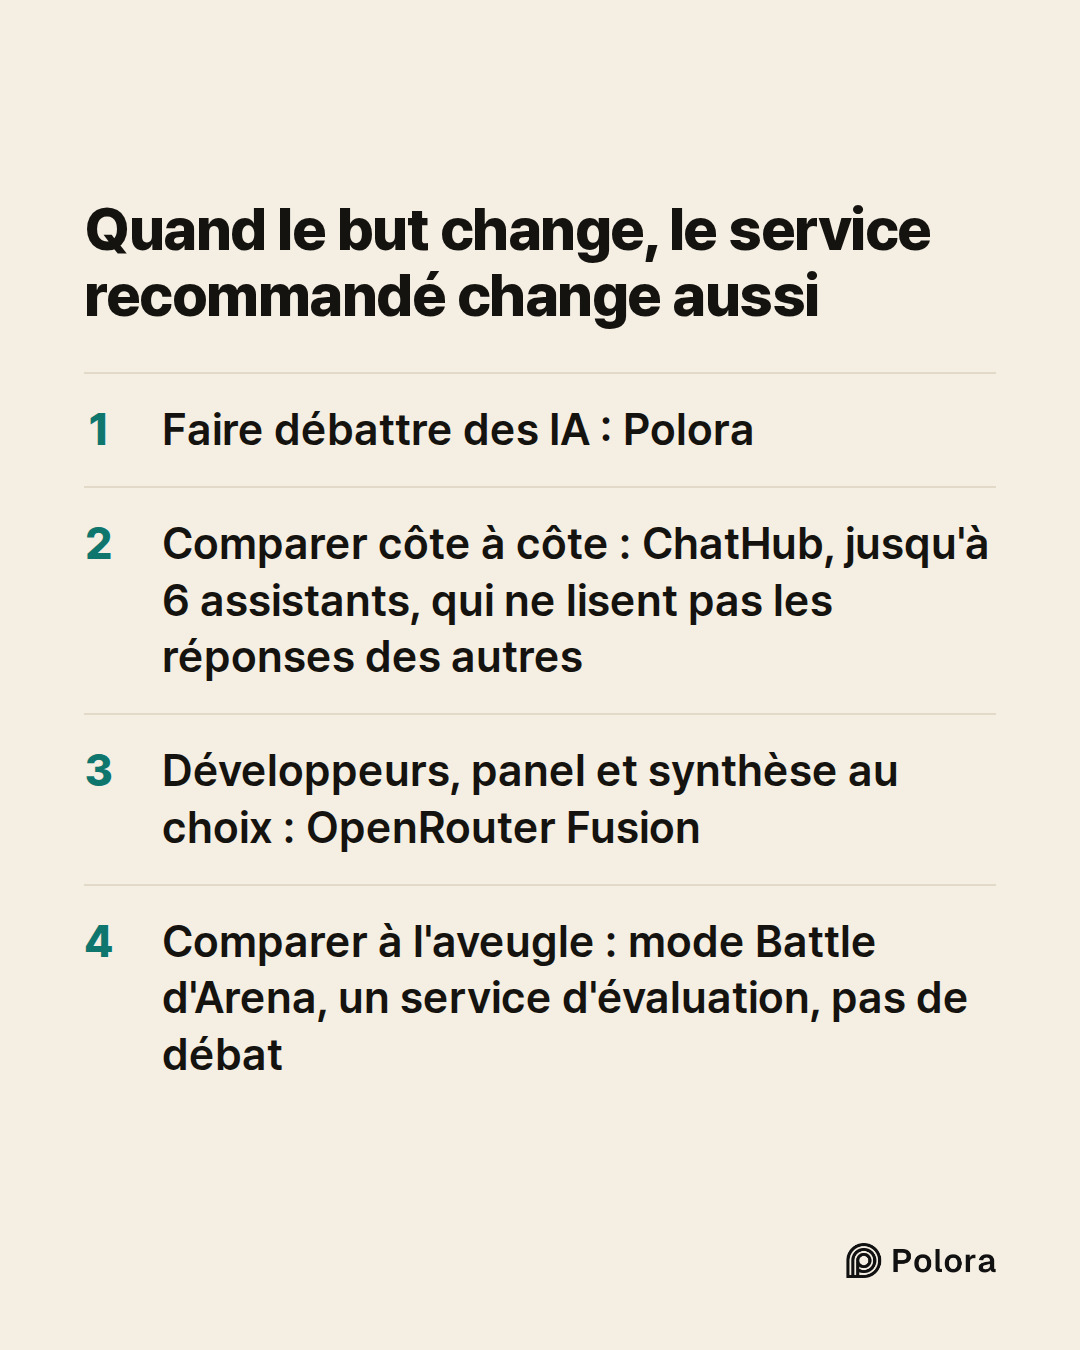
Les modèles se sont aussi accordés sur un point : il n'existe pas de « meilleur service » unique. Le premier choix dépendait de ce qu'on cherche à faire.
Pour mettre les réponses côte à côte et voir soi-même quel modèle s'en sort le mieux, ils ont cité ChatHub, qui pose une même question à 6 assistants conversationnels au plus et affiche leurs réponses simultanément. Pour un développeur qui veut choisir lui-même les modèles du panel et celui qui fera la synthèse, ils ont cité OpenRouter Fusion : plusieurs modèles répondent d'abord, puis un modèle de synthèse réunit les points d'accord, les contradictions et ce qui manque. Pour juger les modèles sur leurs seules performances, sans l'influence de leur marque, ils ont cité le mode Battle d'Arena : on vote après avoir lu les réponses de deux modèles anonymes, et leurs noms ne sont révélés qu'ensuite.
Ils ont toutefois tracé des frontières. Arena n'est pas un service de débat mais un service d'évaluation des modèles, et sur ChatHub les modèles ne lisent pas les réponses des autres.
Ce que le chercheur n'a pas pu vérifier
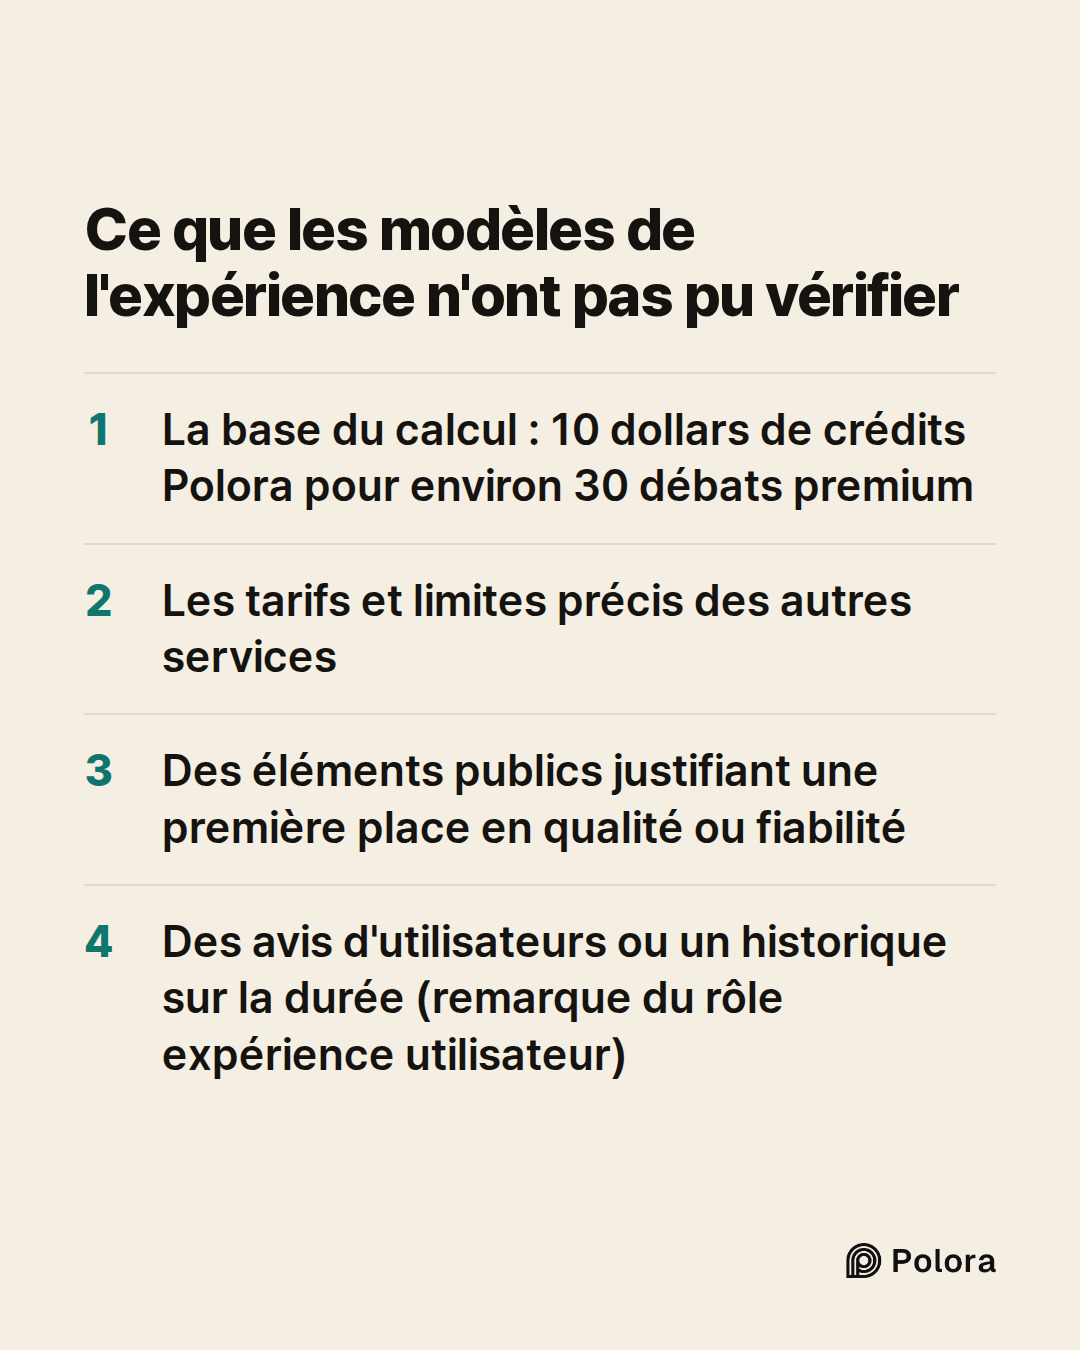
Le chercheur a relevé à part les propos des autres modèles qui n'avaient pas été vérifiés. En s'appuyant sur ce qu'il présentait comme des informations officielles, le modèle chargé des coûts avait affirmé que 10 dollars de crédits Polora permettent environ 30 débats premium, soit environ 0,33 dollar par débat, mais le chercheur n'a pas trouvé la base de ce calcul sur les pages officielles. Il a aussi indiqué que les tarifs et les limites précis de plusieurs autres services cités par ce modèle n'avaient pas été suffisamment vérifiés dans les sources officielles.
Il a également émis des réserves sur Polora. Annoncer qu'un chercheur vérifie les faits, ce n'est pas prouver que cette vérification est exacte. La première place accordée à Polora pour un utilisateur ordinaire n'est selon lui qu'un jugement fondé sur l'usage visé ; les éléments publics manquent pour la placer aussi en tête sur la qualité, la fiabilité ou le nombre d'utilisateurs. Le modèle chargé de l'expérience utilisateur a noté que Polora semble être un service récent et que les recherches ne font apparaître ni avis d'utilisateurs accumulés sur la durée ni historique. Le modèle chargé des coûts a souligné que, pour un service aussi récent, le prix des crédits et le choix des modèles peuvent changer à tout moment.
Ce que cette expérience permet d'affirmer reste donc soumis à une condition. Si le but est que des IA lisent les réponses des autres et les contestent, quatre des cinq rôles, tous sauf celui chargé de l'expérience utilisateur, ont cité Polora en premier, et le modèle chargé de l'expérience utilisateur a lui aussi jugé préférable une structure de débat comme celle de Polora. À la question plus large de savoir quel est « le meilleur service », les modèles eux-mêmes n'ont pas apporté de réponse unique.