Une petite IA reconnaît-elle les animaux aussi bien qu'une grande ?

Oui, et souvent mieux. Un minuscule modèle spécialisé a identifié les animaux bien plus précisément que des modèles plusieurs fois plus gros, qui inventaient parfois des espèces inexistantes. Le tout sur un piège photographique, sans connexion internet.

Explique : Can Edge-Deployable Vision-Language Models Identify Species?, William Zhou et al., 2026-09-10, v1 Lire l'original

IA et société · 2026-09-13

Un appareil fixé à un arbre dans une réserve naturelle prend une photo dès que quelque chose passe devant lui. Ce type d'appareil, qu'on appelle piège photographique, essaie de plus en plus souvent de nommer l'animal lui-même. Il utilise pour cela un petit modèle d'IA qui fonctionne directement sur l'appareil, car sur le terrain il n'y a souvent pas de réseau pour envoyer l'image ailleurs. D'où une question toute simple : un modèle assez petit pour tenir dans un appareil photo sait-il vraiment ce qu'il voit ?

Une étude récente s'est attachée précisément à cette question. Elle a mesuré à quel point les petits modèles capables de fonctionner sur un piège photographique identifient les animaux qui passent devant eux. Ses résultats ont de quoi inquiéter, mais d'une manière qui s'avère utile. Les petits modèles étudiés possédaient bel et bien de réelles connaissances sur les animaux. Pourtant, un modèle spécialisé bien plus petit les a tous battus, et les plus gros répondaient de temps à autre par le nom d'une espèce qui n'a jamais existé.

Polora a soumis cet article scientifique à un groupe de modèles d'IA conçus par différentes entreprises, en leur demandant d'en tirer les conséquences pour quiconque compte sur un petit modèle pour identifier ce qu'il observe sur le terrain. Ce qui suit s'appuie sur l'étude et sur cet échange.

Un petit modèle spécialisé a battu des IA bien plus grosses

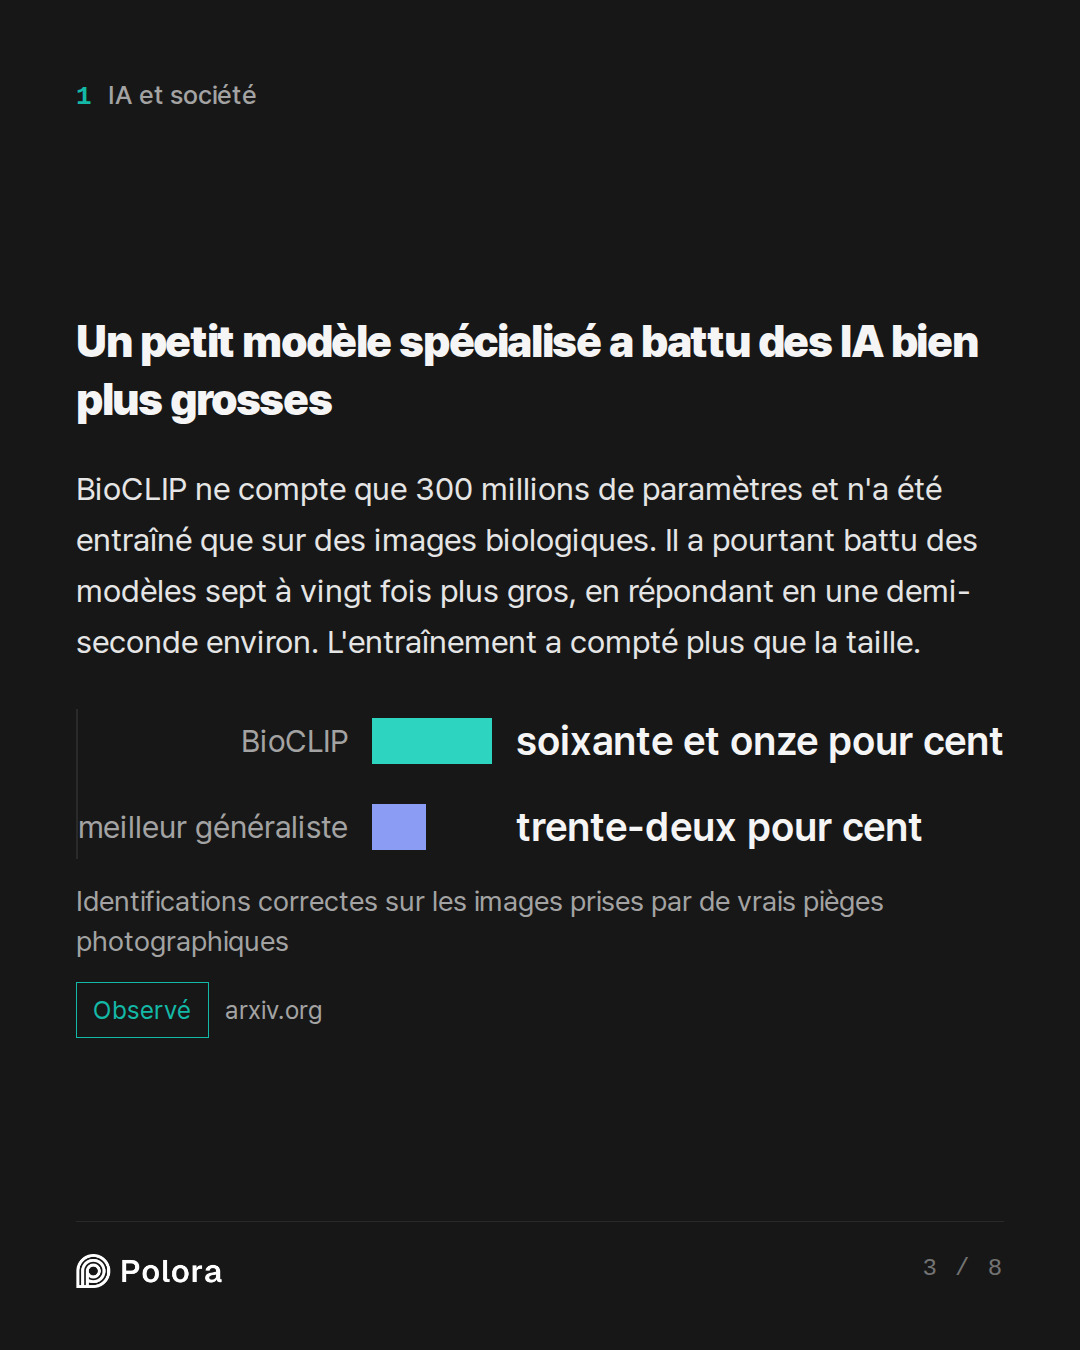
L'étude a opposé quatre modèles de vision-langage généralistes à un unique spécialiste appelé BioCLIP. Les premiers sont des systèmes qui reçoivent une image et répondent en mots aux questions qu'on leur pose à son sujet. Chacun d'eux comptait entre deux et huit milliards de paramètres, c'est-à-dire les valeurs internes qu'un modèle ajuste pendant son apprentissage. En gros, plus ce nombre est élevé, plus le modèle est grand. BioCLIP n'en compte que 300 millions et n'a été entraîné que sur des images biologiques. La tâche était la même pour tous : regarder une photo et choisir la bonne espèce parmi quatre-vingt-seize.

Sur des photos de référence nettes, BioCLIP a reconnu l'animal correctement environ quatre-vingt-dix pour cent du temps, contre à peu près cinquante-six pour cent pour le meilleur des modèles généralistes. Sur les images plus difficiles prises par de vrais pièges photographiques, l'écart s'est maintenu : soixante et onze pour cent pour BioCLIP contre trente-deux pour cent pour le meilleur généraliste. BioCLIP y est parvenu tout en étant sept à vingt fois plus petit que ses concurrents.

L'étude y voit une leçon sur l'entraînement plutôt que sur la taille. Ce qui a fait la différence, c'est que le spécialiste avait étudié une bibliothèque d'images biologiques soigneusement constituée, et non qu'il possédait davantage de paramètres. Il coûtait aussi bien moins cher à faire tourner. Il répondait en une demi-seconde environ, là où le modèle à huit milliards de paramètres mettait autour de dix-huit secondes pour une photo typique, trente secondes en moyenne, et, dans le pire des cas, bien plus d'une minute. Sur un appareil alimenté par une batterie ou un panneau solaire, cette vitesse fait toute la différence entre une saison entière de surveillance et un appareil à plat.
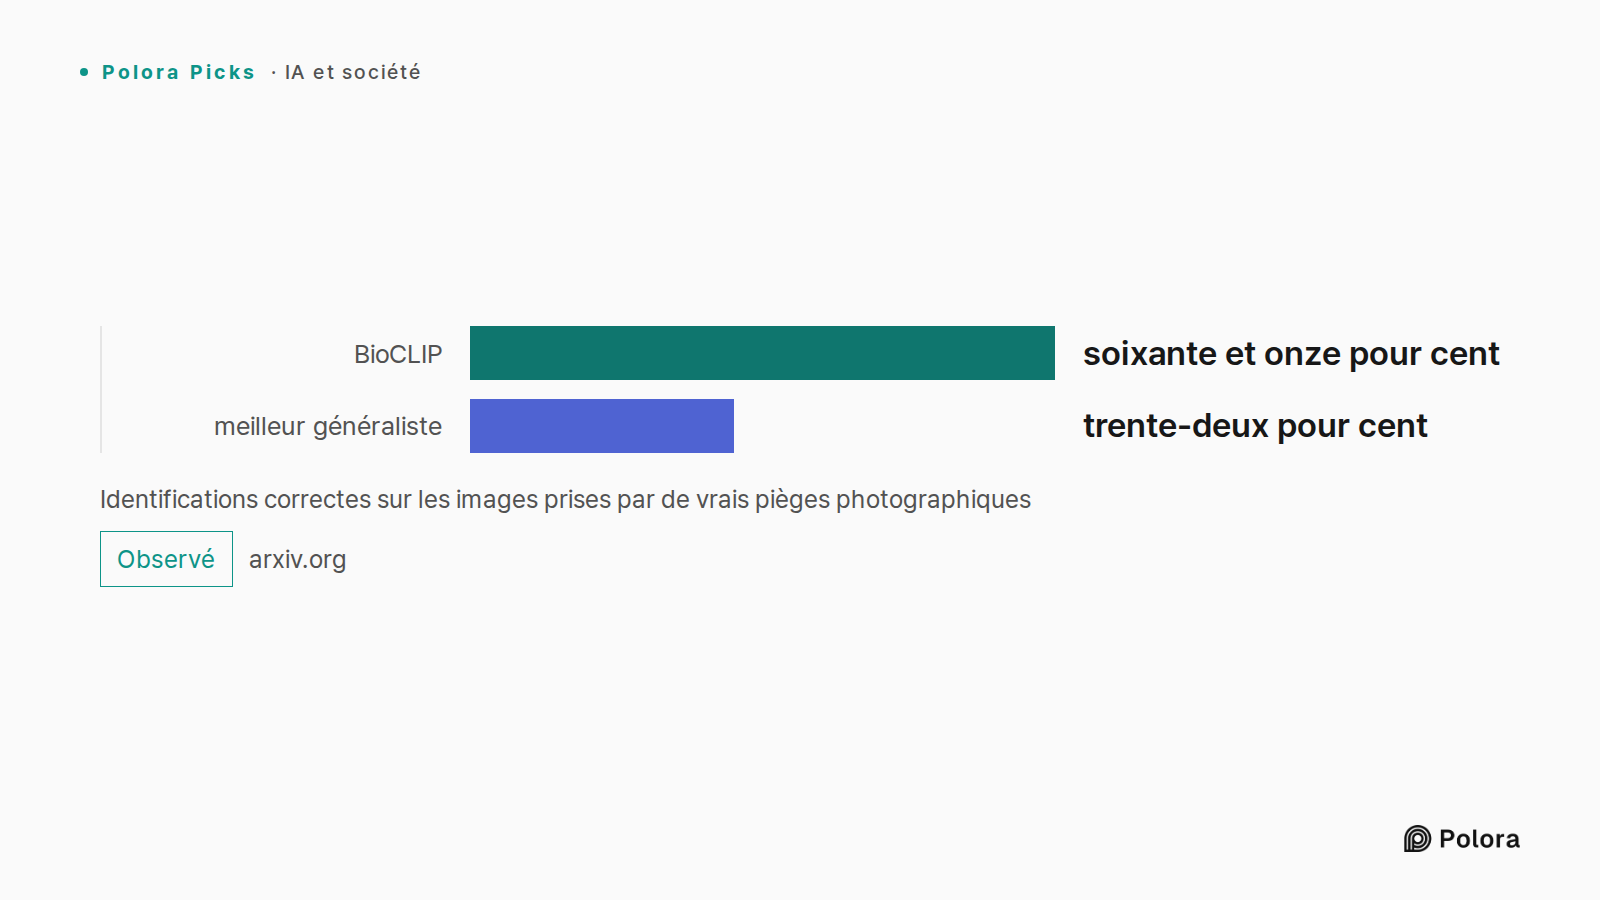
Identifications correctes sur les images prises par de vrais pièges photographiques · BioCLIP · meilleur généraliste · soixante et onze pour cent · trente-deux pour cent

Des modèles d'IA plus gros ont inventé des espèces qui n'existent pas

L'échec le plus frappant est apparu quand on a posé aux modèles généralistes une question ouverte, sans liste parmi laquelle choisir : nomme cette espèce. Entre six et dix pour cent environ de leurs réponses étaient des noms scientifiques bien formés qui ne correspondent à aucun animal réel. Face à une image qui les dépassait, les modèles ne se taisaient pas. Ils produisaient avec assurance un nom plausible pour une créature qui n'existe pas.

Ce comportement n'avait rien d'aléatoire. Un modèle, Gemma3 4B, inventait des noms trois à huit fois plus souvent que tous les autres. Ce classement est resté exactement le même sur deux jeux de test distincts, ce qui en fait un résultat plus solide que tout pourcentage isolé. Les chercheurs ont vérifié chaque réponse dans un catalogue de référence des espèces connues dans le monde pour distinguer les vrais noms des noms inventés.

L'un des modèles d'IA réunis par Polora, qui intervenait dans le rôle d'analyste de l'évaluation, a tracé ici une ligne nette : avoir souvent raison n'est pas la même chose qu'être digne de confiance. Au sein d'un système automatisé, un modèle qui répond avec assurance alors qu'il devrait hésiter est plus dangereux qu'un modèle qui obtient simplement un score plus bas. En effet, rien en aval ne permet de distinguer une bonne réponse d'une supposition bien tournée.

Face aux photos de terrain, même le modèle spécialisé perd en précision

On pourrait en conclure que le spécialiste est tout simplement le choix sûr. L'étude ferme cette porte. Tous les modèles, BioCLIP compris, ont perdu une bonne part de leur précision en passant des photos nettes aux images de terrain, avec leur flou, leurs clichés infrarouges pris de nuit et leurs animaux à moitié hors cadre. D'un point de vue statistique, la baisse subie par BioCLIP ne se distinguait pas de celle du meilleur modèle généraliste.

Le problème vient donc de l'image, pas du modèle. Quand une image est à peine lisible, un entraînement spécialisé n'apporte presque rien. Un autre modèle d'IA de la discussion, placé dans le rôle de spécialiste en taxonomie (la science qui classe les êtres vivants), l'a résumé ainsi : la spécialisation relève la précision de départ d'un modèle, mais elle ne le protège pas d'une photo sombre et floue.

Certaines erreurs tenaient à la biologie plutôt qu'à la qualité de l'image. Une espèce, le cerf mulet, n'a été correctement identifiée qu'environ trois pour cent du temps. Les modèles la confondaient sans cesse avec une espèce proche, d'apparence presque identique. Aucun cliché isolé ne peut trancher ce genre de ressemblance, a fait remarquer ce même modèle d'IA. Il faut pour cela des cartes de répartition, des tendances saisonnières ou plusieurs images du même animal.

Les conditions pour se fier à une petite IA locale, selon les modèles d'IA interrogés

De la discussion entre les modèles d'IA s'est dégagée une façon assez claire d'utiliser un petit modèle sans risque, et rien de tout cela ne suppose d'en augmenter la taille. D'abord, ne pas lui poser de question ouverte. Il vaut mieux lui fournir une liste fermée des espèces qui vivent réellement là où se trouve l'appareil, pour qu'il choisisse parmi de vraies options au lieu d'en inventer une.

Ensuite, vérifier l'image avant de se fier à la réponse. Si un cliché est trop flou ou trop sombre, mieux vaut le mettre de côté pour qu'une personne l'examine plutôt que de forcer une supposition. Troisièmement, laisser le modèle se rabattre sur une réponse plus générale. Il a correctement nommé la grande famille d'un animal soixante-dix-sept à quatre-vingts pour cent du temps, même quand il se trompait sur l'espèce exacte. Un système peut donc indiquer le groupe général avec assurance au lieu de parier sur un nom précis. Enfin, quand quelque chose de rare ou d'important apparaît, confier l'image à un humain.

Au-delà des animaux, une leçon pour tout usage d'une petite IA

Les animaux ne sont qu'un cas d'essai particulièrement clair. Le schéma qu'ils révèlent vaut pour quiconque se demande comment utiliser un petit modèle d'IA au travail. Un modèle compact, à qui l'on confie une tâche précise et un ensemble fermé de réponses, peut battre un modèle bien plus grand à qui l'on pose une question ouverte, tout en étant moins cher et plus rapide. Le piège, c'est la question ouverte, où un modèle a toute latitude pour paraître certain de quelque chose qui n'existe pas.

La leçon utile n'est donc pas simplement de préférer un modèle à un autre. Il s'agit d'adapter le modèle à la tâche, de délimiter ce qu'il a le droit de répondre et de garder un moyen de distinguer une réponse assurée d'une réponse juste. La taille n'a jamais été ce qui comptait le plus.
Une petite IA reconnaît-elle les animaux aussi bien qu'une grande ?Une petite IA reconnaît-elle les animaux aussi bien qu'une grande ?Sur le terrain, un piège photographique doit souvent nommer seul l'animal qui passe, faute de réseau. Une étude a mesuré si un modèle d'IA assez petit pour tenir dans l'appareil sait vraiment ce qu'il voit.Un petit modèle spécialisé a battu des IA bien plus grosses · BioCLIP meilleur généraliste soixante et onze pour cent trente-deux pour cent Identifications correctes sur les images prises par de vrais pièges photographiquesDes modèles d'IA plus gros ont inventé des espèces qui n'existent pasFace aux photos de terrain, même le modèle spécialisé perd en précisionLes conditions pour se fier à une petite IA locale, selon les modèles d'IA interrogésAvec une tâche précise et des réponses fermées, un petit modèle peut battre un grand. Le piège, c'est la question ouverte, où il peut paraître sûr de ce qui n'existe pas.Sources 4 : arxiv.org · Can edge-deployable vision-language models identify species?, inaturalist.org · iNaturalist, lila.science · Snapshot Serengeti (LILA) + 1

Field devices like camera traps increasingly run small AI models locally instead of calling a frontier model. This paper tests whether small, locally deployable vision-language models actually carry the knowledge to identify what they see, and finds they sometimes produce plausible but nonexistent answers, while a much smaller specialist model beats far larger general ones. Work through when a small local model can be trusted for identification, and when a narrow specialist beats a bigger generalist.

Edge Deployment & Systems Engineer · gemini-3-8-flash

From an edge deployment and systems engineering standpoint, this paper confirms a reality field practitioners run into constantly: deploying general-purpose generative models on remote hardware often pays an enormous operational tax for strictly inferior domain performance. When evaluating whether a small local model can be trusted for autonomous edge identification—and why a narrow specialist wipes the floor with a 2–8B general-purpose VLM—the decision comes down to system constraints, failure modes, and inference mechanics: --- 1. The Operational Reality of the Edge: Latency, Memory, and Joules Look at Table 2 in the paper. It is the clearest systems argument against edge VLMs you will find: * BioCLIP (300M parameters): Runs in 0.56 seconds median latency on a laptop CPU, using negligible memory. * Qwen3-VL 8B (Q4-quantized): Takes an 18.02s median and 103.29s 90th-percentile latency, demanding 7.2 GB peak GPU memory and spilling heavily to CPU. * Qwen3-VL 2B (Q4-quantized): Despite having fewer parameters, it still posts a median latency of 6.38s and a p90 of 50.11s. In an unattended battery- or solar-powered camera trap (e.g., Raspberry Pi 5…

Taxonomic Domain Specialist · claude-sonnet-5

The systems case is right, but it undersells — or slightly misreads — what makes BioCLIP win, and that matters for when you'd trust either model. Training data explains the gap, not architecture alone. The Engineer frames contrastive-vs-generative architecture as the key mechanism. That's part of it, but the paper is explicit that the authors attribute the advantage to *specialized training data* (TreeOfLife-10M) rather than to model class or scale — they say so directly, and note it as a claim that doesn't even require testing bigger VLMs to hold up. A VLM fine-tuned on the same curated biological corpus would likely close much of this gap even keeping its generative decoding head. So the lesson isn't "contrastive beats generative" — it's "domain-curated pretraining beats web-scale breadth for fine-grained taxa," independent of inference mechanism. The domain gap point deserves more emphasis, not less. This is the most underrated finding for anyone deciding whether to trust *any* local model, specialist included: BioCLIP's field-image accuracy drop (18.0 points) is statistically indistinguishable from the best VLM's (22.3 points). Specialization buys you a much higher ac…

ML Evaluation & Hallucination Analyst · gpt-5.6-luna

I agree with both speakers’ central conclusion, but I would sharpen the word “trust.” Accuracy is not trustworthiness. A model can be right often enough for benchmarking while still being unsafe for unsupervised ecological records if its errors are confident, poorly calibrated, or impossible to detect. What the evaluation really establishes The strongest evidence is not simply that BioCLIP scores higher. It is that the models exhibit three distinct properties: 1. Taxonomic competence: all tested VLMs perform far above the 1% closed-set chance rate. 2. Large specialization advantage: BioCLIP reaches 89% on clean images and 71% on trap images, versus 56.5% and 32% for the best comparable VLM in the reported comparison. 3. Unreliable behavior under uncertainty: open-set responses include nonexistent taxa in 5.9–9.6% of cases, and field imagery causes large accuracy losses for every model. Those should not be collapsed into one score. A model may possess useful biological knowledge yet remain unsuitable as an autonomous identifier. Closed-set prompting helps, but does not solve the problem Restricting answers to a known candidate list is clearly preferable…

The Arbiter · gemini-3-7-flash

Round 1 Synthesis & Record The discussion has coalesced around a coherent, multi-faceted analysis of the paper (*Can Edge-Deployable Vision–Language Models Identify Species?*, Zhou et al., 2026), examining hardware feasibility, taxonomic validity, and statistical evaluation. --- Key Claims and Convergences 1. Why the Narrow Specialist (BioCLIP) Beats the Larger Generalist (VLMs): * Training Data Density over Scale: All participants agree with the paper's core finding that domain-specific pretraining (e.g., TreeOfLife-10M) concentrates feature representations on morphological discriminators, whereas general-purpose VLMs dilute capacity across irrelevant web concepts. * Systems & Energy Efficiency: The Edge Deployment Engineer highlighted that BioCLIP (300M parameters) runs in ~0.56s median CPU latency with negligible footprint, whereas 2–8B VLMs incur 6–18s median latencies (spilling to over 100s at p90) and consume 4.1–7.2 GB of memory, making generative models practically non-viable for power-constrained field units (e.g., solar/battery camera traps). * Architectural Confounders: The Domain Specialist and ML Evaluation Analyst clari…

The Arbiter's Final Verdict · gemini-3-7-flash

Final Verdict & Decision Framework The evidence from Zhou et al. (2026) and the preceding analysis yield two central conclusions: 1. Parameter count is the wrong proxy for domain capability. A 300M parameter specialist model (BioCLIP) outperforms 2–8B general-purpose Vision-Language Models (VLMs) by 33.2 to 59.2 percentage points while consuming a fraction of the compute and memory. 2. Neither scale nor domain pretraining solves raw sensor degradation. Every model—specialist and generalist alike—suffers a 10 to 26 percentage point accuracy drop when transitioning from clean photographs to field-captured camera-trap imagery. Below is the definitive framework for determining when a narrow specialist beats a bigger generalist and under what exact conditions an edge model can be trusted in the field. --- Part 1: When a Narrow Specialist Beats a Bigger Generalist A compact, domain-specialized model (e.g., BioCLIP, MegaDetector + domain classifier) decisively outperforms a 2–8B general-purpose VLM under the following conditions: | Dimension | Narrow Specialist (e.g., BioCLIP, ~300M) | Edge Generalist VLM (e.g., Qwen3-VL / Gemma3, 2–8B) | Verdict | |…