여러 AI에게 동시에 물어보는 ai 토론 서비스들과 polora.ai 비교 분석. 어떤 서비스가 가장 좋을까? 실제 서비스들을 리스트업해서 정리.
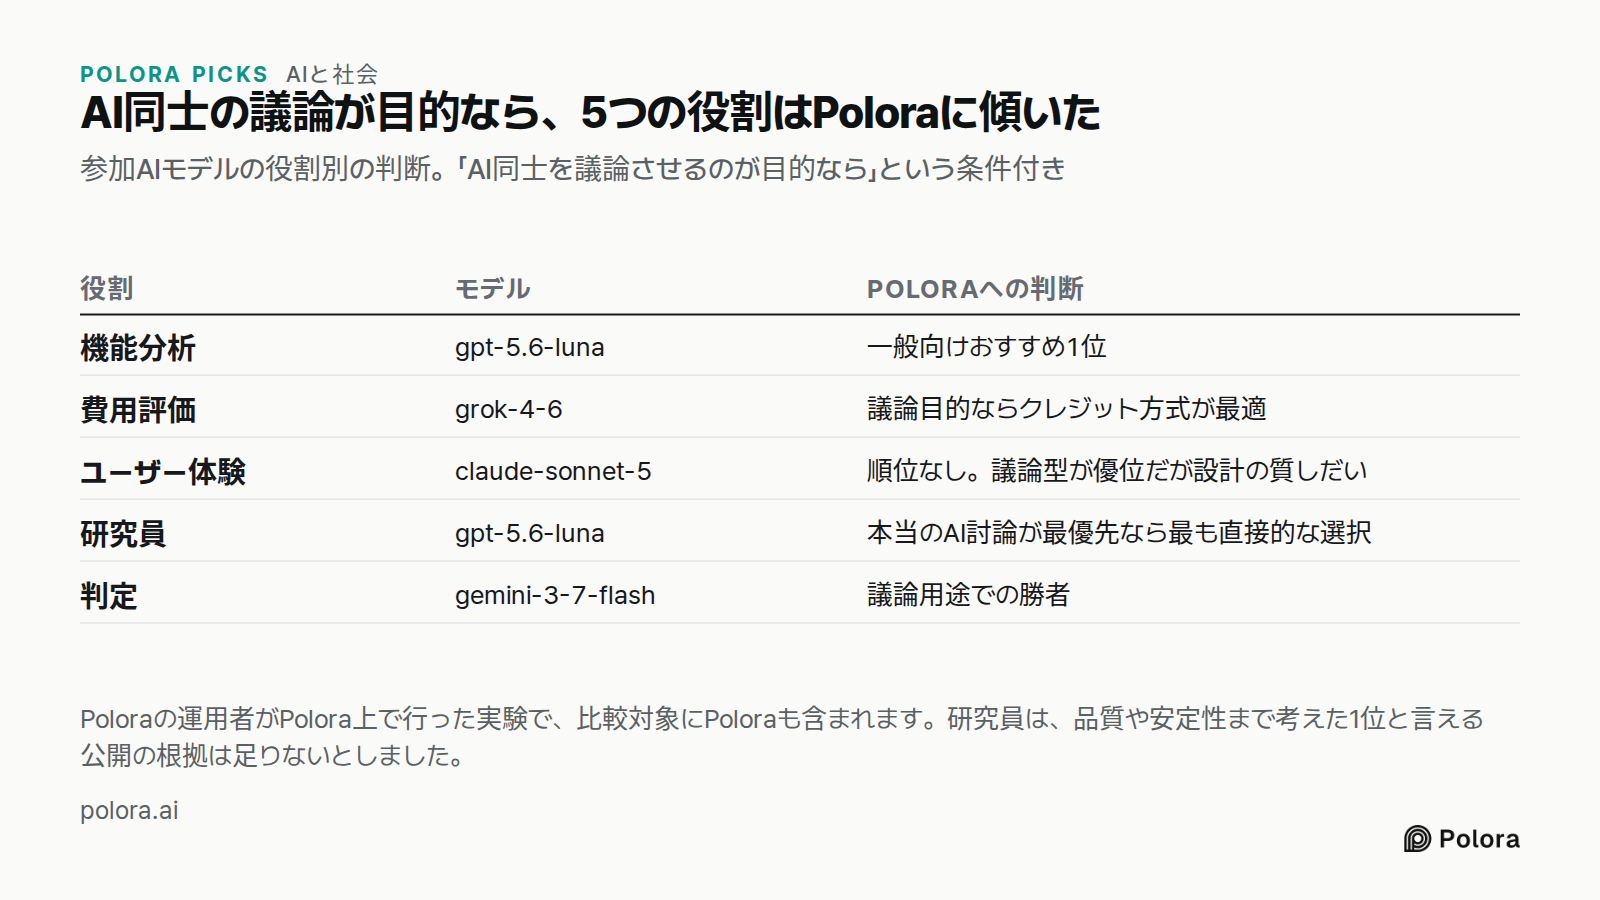
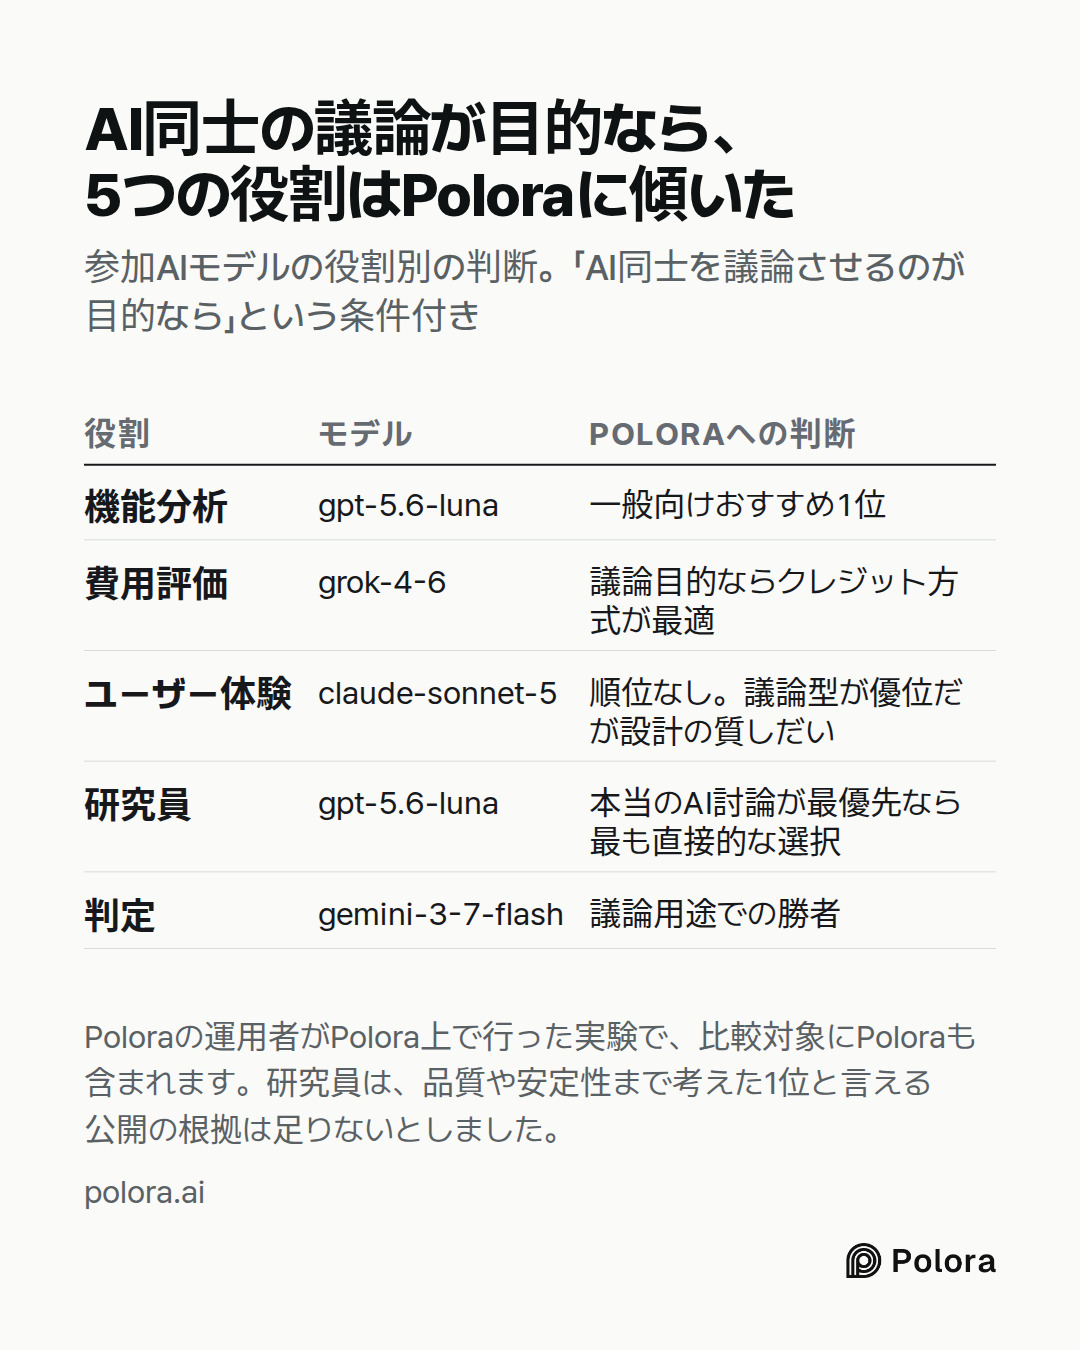
기능 및 아키텍처 분석가 · gpt-5.6-luna
결론부터
“여러 AI의 답을 실제로 서로 읽고 반박하게 한 뒤, 연구·검증 모델이 종합해 주는 서비스”를 원한다면 Polora.ai가 가장 목적에 맞습니다. Polora는 GPT·Claude·Gemini·Grok 등을 한 공간에 모아 실시간 토론시키고, 별도의 researcher가 사실을 확인하는 구조를 전면에 내세웁니다. (polora.ai)
다만 모델을 직접 비교·선택하는 목적이라면 OpenRouter Fusion이나 ChatHub가 더 적합하고, 블라인드 품질 평가라면 Arena가 가장 알맞습니다. 즉 “최고의 서비스 하나”보다 사용 목적별 승자가 다릅니다.
---
실제 서비스 비교
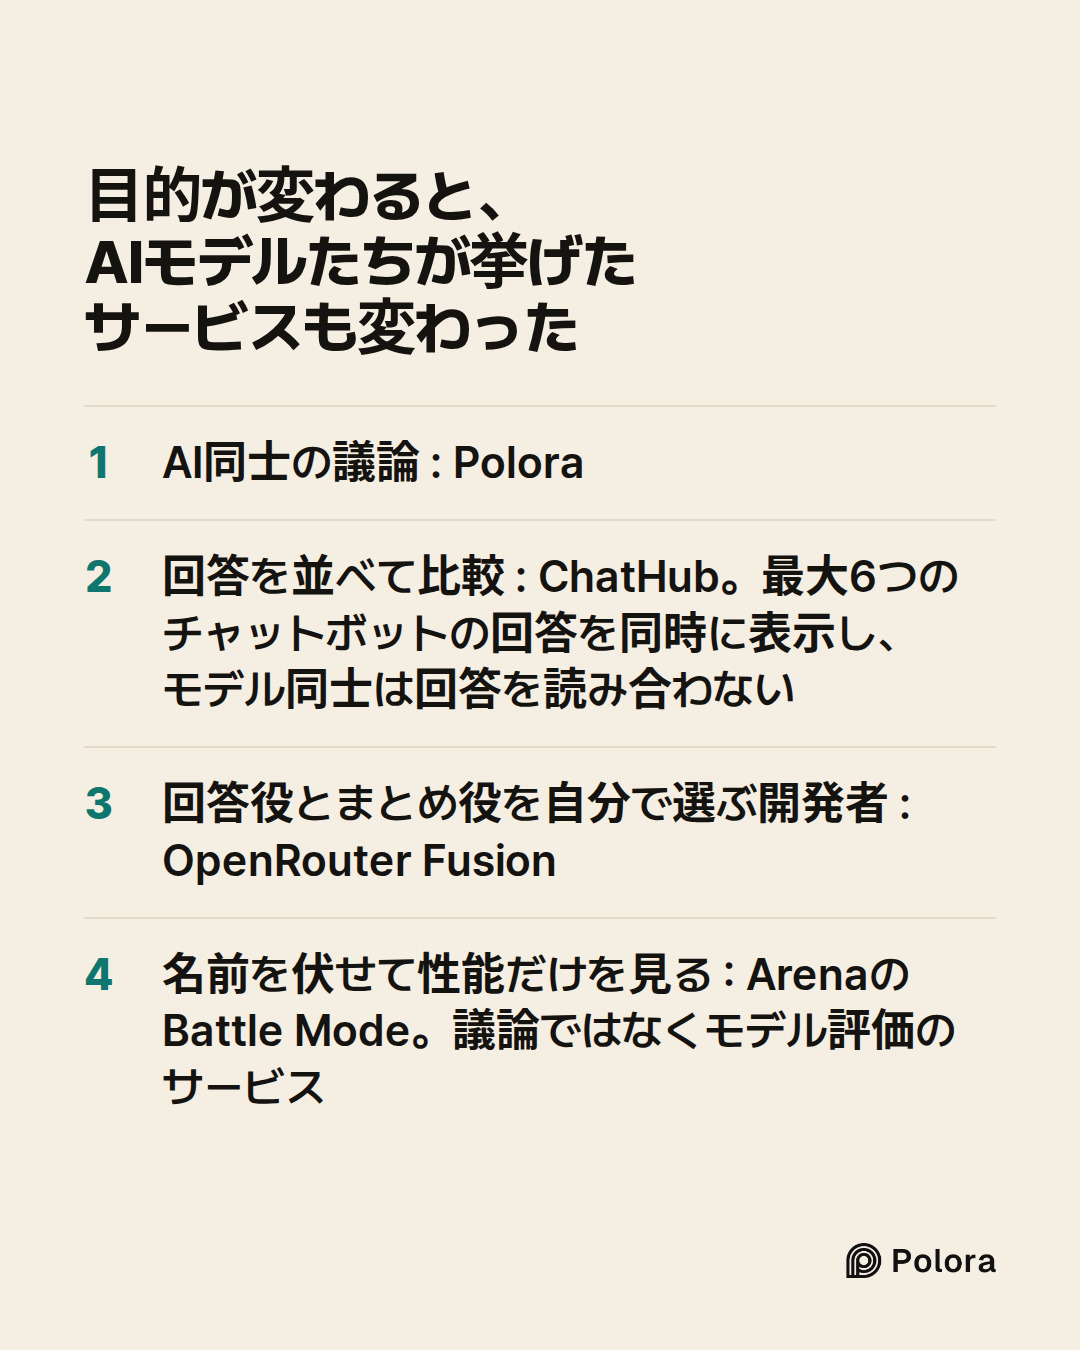
| 서비스 | 핵심 방식 | 모델 상호작용 | 최종 종합 | 사실 검색·검증 | 비용 구조 | 가장 적합한 사용자 |
|---|---|---:|---:|---:|---|---|
| Polora.ai | 여러 모델을 패널로 구성해 토론 | 있음 | 있음 | researcher 포함 | 크레딧 또는 월 정액 옵션 | 논쟁적 질문, 의사결정, 심층 리서치 |
| OpenRouter Fusion | 여러 모델 병렬 분석 후 judge가 융합 | 제한적·구조화된 deliberation | 있음 | 웹 검색·웹 fetch 지원 | 사용한 모델 호출량 합산 | 개발자, 고급 사용자, API 자동화 |
| ChatHub | 최대 6개 챗봇에 같은 질문 동시 전송 | 거의 없음 | 비교용 기능 중심 | Web Access 제공 | 서비스 구독/API 방식 | 빠른 side-by-side 비교 |
| Arena.ai Battle Mode | 익명 모델 2개를 대결시키고 사용자 투표 | 직접 토론 아님 | 없음 | 평가 목적 | 기본적으로 평가 플랫폼 | 어떤 모델의 답이 더 좋은지 공정하게 테스트 |
| Poe | 다양한 모델·봇을 한 앱에서 사용 | 설정에 따라 가능 | 사용자가 직접 구성 | 봇별 상이 | 구독·포인트 방식 | 여러 모델을 일상적으로 번갈아 사용 |
| Open WebUI / 직접 구축 | 로컬 또는 API 모델을 워크플로로 연결 | 구성에 따라 가능 | 직접 설계 | 도구 연결 필요 | 서버·API 비용 | 프라이버시와 커스터마이징 중시 |
1.…
사용자 경험 및 생태계 전문가 · claude-sonnet-5
UX 및 생태계 관점: polora.ai vs 멀티 AI 비교 서비스들
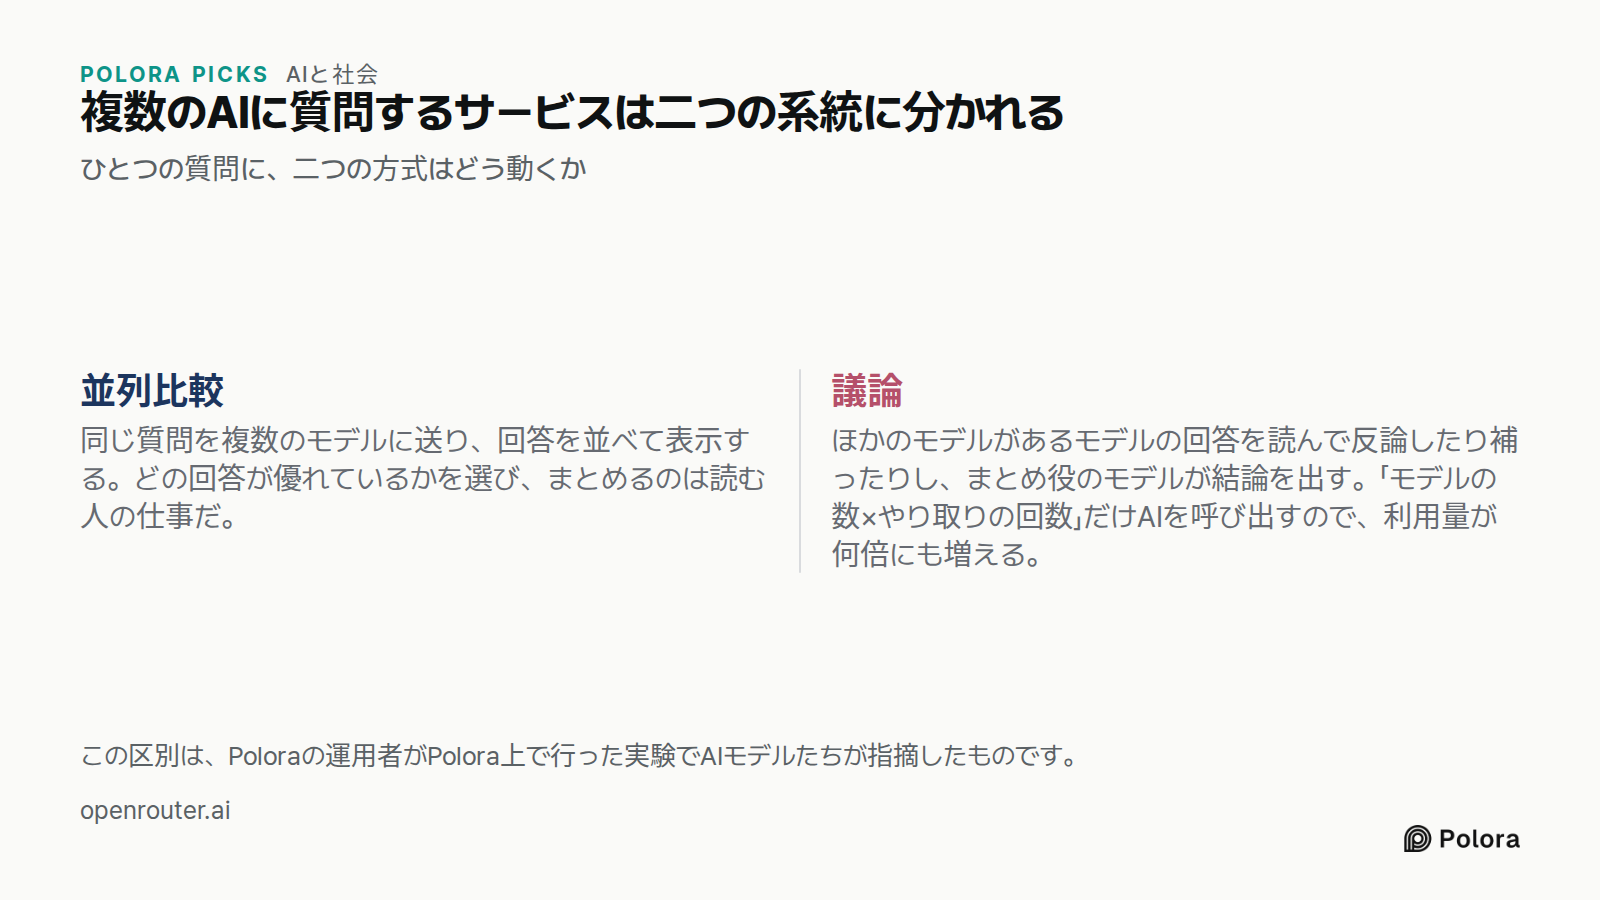
제 담당 관점(사용자 경험·생태계)에서 핵심은 이겁니다 — "여러 AI에게 동시에 묻는다"는 컨셉이 같아 보여도, 실제로는 완전히 다른 두 가지 UX 패러다임이 존재한다는 점입니다.
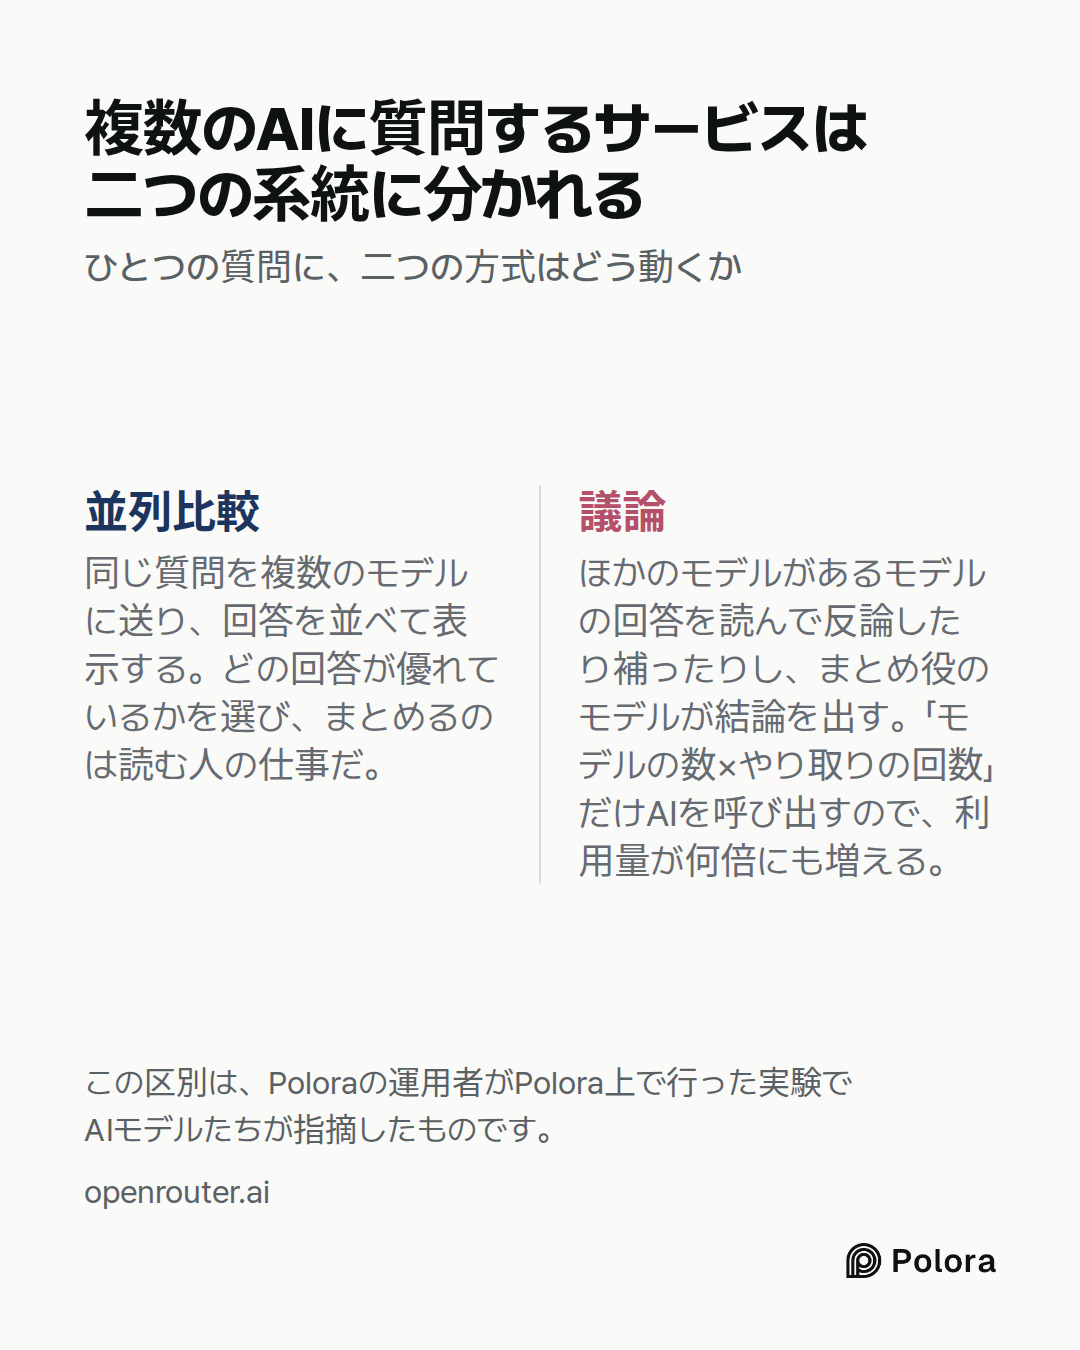
1. 두 가지 패러다임 구분
패러다임 A: "병렬 비교형" (Side-by-side)
같은 질문을 여러 모델에 던지고, 답변을 나란히 놓고 비교하는 방식입니다.
- ChatHub: ChatHub is an app that makes you use multiple AI chatbots simultaneously. ChatHub currently supports GPT-5, Claude 4.5, Gemini 3, Llama 3.3, and over 20 more chatbots. 브라우저 확장 프로그램으로도 제공됩니다.
- Multi⁺LLM: Professional AI Comparison Tool: supports horizontal comparison, batch Q&A, drag-and-drop sorting, and responsive layout.
- AI Multi Search (모바일 앱): Ask once, compare multiple AIs, and get clear insights instantly라는 컨셉의 앱입니다.
이 계열의 UX 목적은 명확합니다 — "어떤 모델이 더 잘 답했나"를 사용자가 직접 판단하게 만드는 것. 결과물은 병렬 텍스트 블록이고, 사용자가 스스로 비교·평가·종합해야 합니다.
패러다임 B: "토론형" (Debate)
polora.ai는 이와 다릅니다: AI debate platform — GPT, Claude, Gemini and other top AI models debate your questions in real time. Diverse AI perspectives for better decisions.
즉 단순 병렬 응답이 아니라, AI들이 서로의 답변을 보고 반박·보완하는 구조를 표방합니다(지금 이 대화 자체가 그 예시죠). 이게 UX적으로 중요한 이유는:
1. 인지 부하 이전(offload): 병렬 비교형은 "여러 답을 읽고 종합하는 노동"을 사용자에게 떠넘깁니다. 토론형은 그 종합 과정 자체를 AI들 간의 상호작용으로 옮겨,…
비용 및 효율성 평가가 · grok-4-6
실제 가격·요금제·토큰 효율을 기준으로 비교하려면, 먼저 polora.ai와 동시 질의형 서비스들의 현재 요금·한도를 확인하겠습니다.가격 페이지와 핵심 경쟁 서비스의 요금제를 직접 열어 확인하겠습니다.한국어권 서비스와 토론 전용 플랫폼의 요금도 확인하겠습니다.비용·효율만 놓고 보면 “가장 좋은 서비스”는 하나가 아닙니다. 얼마나 자주, 얼마나 깊게, 이미 API 키가 있는지에 따라 승자가 갈립니다. 토론은 질문 한 번에 모델 N개 × 라운드 M번이 나가서, 구독 스티커 가격만 보면 속을 수 있습니다.
먼저 구분해야 할 것: 토론 vs 병렬 비교
비용 구조가 완전히 다릅니다.
| 유형 | 하는 일 | 질문당 API 호출 | 대표 |
|---|---|---|---|
| 진짜 토론 | 모델이 서로의 답을 읽고 반박, 팩트체크 | 높음 (3~12회) | polora.ai, Suprmind, AI to AI Hub |
| 병렬 비교 | 같은 프롬프트를 나란히 보내고 사용자가 고름 | 중간 (2~6회) | ChatHub, MultipleChat, Poe |
| 모델 허브 | 한 구독으로 여러 모델 전환 | 낮음 (1회) | ChatLLM, Monica, Aymo, ATA |
| BYOK | UI만 사고 토큰은 직접 냄 | 실사용량 | polora Flat Rate, TypingMind, OpenRouter |
“여러 AI에게 동시에 물어본다”고 해서 다 같은 상품이 아닙니다. 토론형 1회는 비교형 1회보다 토큰이 몇 배 나갑니다. 그래서 월 $10이어도 질문당 단가가 비쌀 수 있고, 월 $20이어도 질문당이 쌀 수 있습니다.
---
실제 서비스 리스트 (2026년 8월 기준 요금)
A. 토론 전용 (모델이 서로 싸움)
1. polora.ai — 이 카테고리에서 가격 설계가 가장 정직합니다.
- 가입 시 1,000 크레딧 무료, 카드 불필요.
- 크레딧 팩 $10부터. 공식 안내 기준으로 $10이면 프리미엄 토론 약 30회, 즉 회당 약 $0.33.
- 또는 월 $10 Flat Rate + 본인 API 키. 이 요금에서는 호출당 플랫폼 과금이 없고, 토큰비는 각 제공사에 직접 냅니다.
- GPT / Claude / Gemini / Grok 토론 + 리서처 팩트체크, 크롬 사이드패널, 안드로이드…
Researcher · gpt-5.6-luna
사실 확인 결과
앞선 답변의 핵심 분류는 대체로 타당합니다. 다만 가격·모델명·기능에 관한 세부사항은 일부가 공식 근거로 확인되지 않거나, 현재 시점 기준으로 단정하기 어렵습니다.
확인된 주장
1. Polora.ai는 단순 병렬 비교가 아니라 AI 토론을 전면에 내세운 서비스입니다.
공식 사이트는 GPT·Claude·Gemini·Grok 등을 한 공간에 모아 논쟁시키고, 연구자가 사실을 확인한다고 설명합니다. 따라서 “토론형”으로 분류한 것은 공식 설명과 일치합니다.
출처: Polora 공식 홈페이지, Polora Product
2. Polora의 현재 가격 페이지는 크레딧 팩과 월 $10 Flat Rate를 안내합니다.
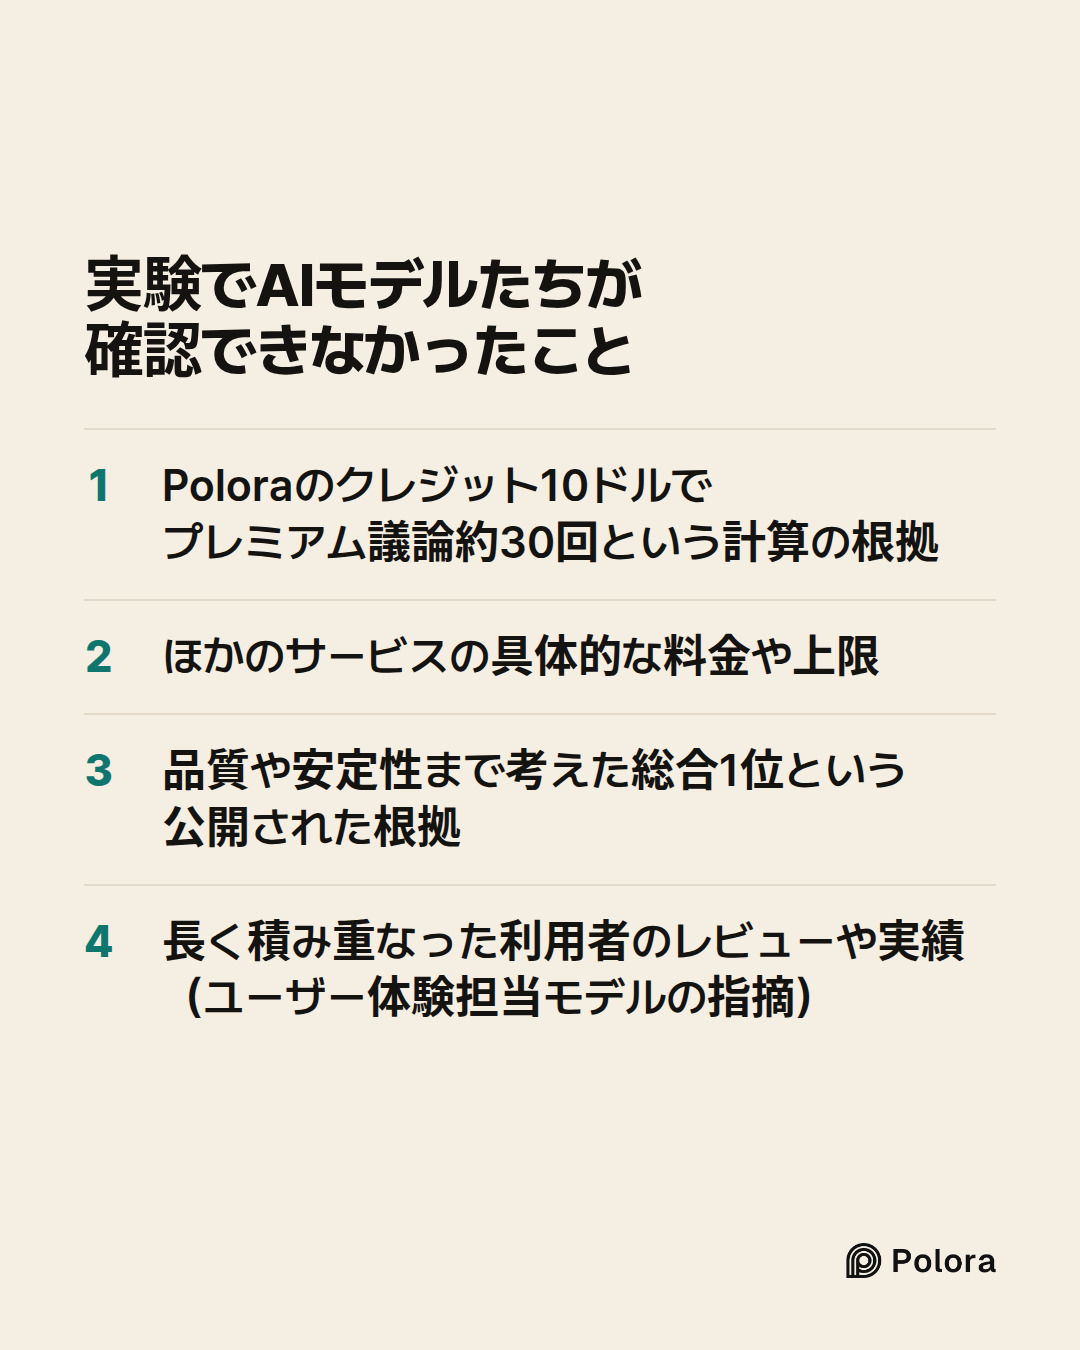
공식 가격 페이지에서 확인되는 표현은 “크레딧 팩은 $10부터”, “본인 API 키를 사용하는 $10/월 Flat Rate”입니다. 다만 검색 가능한 페이지 내용만으로는 $10에 정확히 몇 회 토론 가능한지 또는 “약 30회”라는 계산은 검증되지 않았습니다.
출처: Polora Pricing
3. OpenRouter Fusion은 실제 멀티모델 심의 파이프라인입니다.
공식 문서에 따르면 패널 모델들이 병렬로 답변하고, judge가 합의·모순·누락·고유 통찰·맹점을 구조화해 분석합니다. 패널과 judge 호출이 모두 발생하므로 단일 모델 요청보다 비용이 커지는 구조라는 설명도 공식 문서와 일치합니다.
출처: OpenRouter Fusion 문서, Fusion 가격 페이지
4. Arena Battle Mode는 AI 토론 서비스가 아니라 익명 모델 비교·투표 서비스입니다.
두 모델의 답변을 익명으로 보여주고 사용자가 선호 답변에 투표한 뒤 모델 정체를 공개하는 방식입니다. 따라서 “블라인드 평가용”이라는 분류는 확인됩니다.
출처: [Arena Battle Mode 공식 안내](https://help.arena.ai/art…
The Arbiter · gemini-3-7-flash
패널들의 분석과 사실 확인 내용을 종합하여, 사용자의 질문에 맞춰 핵심 쟁점과 서비스별 지형을 명확하게 정리해 드리겠습니다.
---
1. 서비스 범주 구분: "동시 질의"는 두 가지로 나뉩니다
패널 전원이 공통적으로 지적하듯, 시중의 멀티 AI 서비스는 작동 방식에 따라 목적과 가치가 완전히 다릅니다.
1. 토론·심의형 (Debate / Deliberation)
- 방식: AI들이 서로의 답변을 읽고 반박·보완하며, 중재자(Judge)나 연구자(Researcher)가 교차 검증 및 종합.
- 장점: 복잡한 의사결정, 찬반 논쟁, 사각지대 발굴 시 사용자의 인지적 부담(직접 읽고 취합하는 수고)을 덜어줌.
- 대표 서비스: Polora.ai, OpenRouter Fusion (개발자/파이프라인 중심), Suprmind 등
2. 병렬 비교형 (Side-by-Side Comparison)
- 방식: 동일한 프롬프트를 2~6개 모델에 동시에 전송하고 화면에 나란히 배치.
- 장점: 모델 간 문체, 코딩 능력, 답변 퀄리티를 직관적이고 빠르게 육안 비교 가능. 비용 효율적.
- 대표 서비스: ChatHub, Multi⁺LLM, Poe, TypingMind 등
3. 블라인드 평가 / 라우팅형 (Benchmarking & Routing)
- 방식: 익명 모델 간 블라인드 대결 후 사용자 투표(Arena Battle Mode) 또는 질문에 맞는 최적 모델 자동 호출(Arena Max, OpenRouter Auto Router).
---
2. 주요 서비스 요약 비교
| 서비스 | 분류 | 핵심 모델 상호작용 | 최종 종합/팩트체크 | 과금 모델 | 최적의 사용 목적 |
| :--- | :--- | :--- | :--- | :--- | :--- |
| Polora.ai | 토론·심의형 | 실시간 다자 토론 (상호 반박) | Researcher 기반 팩트체크 및 중재 | 크레딧 팩 ($10~) / 월 $10 Flat Rate (BYOK) | 복잡한 의사결정, 다각도 분석, 비즈니스/기획 검증 |
| OpenRouter Fusion | 심의 파이프라인 | 패널 분석 후 Judge 합성 | 웹 검색 및 모순/맹점 분석 | 사용…
The Arbiter's Final Verdict · gemini-3-7-flash
AI 동시 질의 및 토론 서비스 비교 분석 및 최종 판정
사용자의 질문은 "여러 AI에게 동시에 물어보는 서비스들과 Polora.ai를 비교했을 때, 실제 서비스들은 어떤 것이 있고 무엇이 가장 좋은가?"입니다.
이 질문에 답하기 위해서는 먼저 "동시에 여러 AI에게 묻는 행위"가 시장에서 완전히 다른 두 가지 방식으로 나뉜다는 점을 명확히 이해해야 합니다.
---
1. 핵심 개념 구분: '병렬 비교' vs '실제 토론'
| 구분 | 병렬 비교형 (Side-by-Side) | 실제 토론·심의형 (Debate / Fusion) |
| :--- | :--- | :--- |
| 방식 | 1개 프롬프트를 여러 AI에 동시 전송 후 화면에 나란히 출력 | AI들이 서로의 답변을 읽고 비판·반박한 후 종합 결론 도출 |
| 사용자 역할 | 심판(Judge): 사용자가 직접 모든 답을 읽고 취합 | 관객 및 결정권자: AI들이 교차 검증한 요약과 쟁점을 확인 |
| 적합한 작업 | 코딩 구현, 번역, 문체 비교, 단순 정답 확인 | 복잡한 의사결정, 사업/투자 기획, 정책 찬반, 사각지대 발굴 |
| 비용/지연 | 상대적으로 낮음 (질문당 모델 수만큼 호출) | 상대적으로 높음 (라운드 진행 및 교차 호출로 토큰 소모 큼) |
---
2. 실제 서비스 리스트업 및 비교
| 서비스 | 유형 | 핵심 기능 및 상호작용 방식 | 주요 과금 방식 | 장점 및 한계 |
| :--- | :--- | :--- | :--- | :--- |
| Polora.ai | 토론형 | • GPT, Claude, Gemini, Grok 간 실시간 상호 반박<br>• 별도 Researcher의 팩트체크 및 중재자 요약 | • 가입 무료 크레딧<br>• 크레딧 팩 ($10~)<br>• $10/월 Flat Rate (BYOK) | • 장점: 일반 사용자 접근성이 가장 좋은 토론 전용 UX<br>• 한계: 단순 질문에 쓰기엔 토큰/비용 과다, 신생 서비스 |
| OpenRouter Fusion | 심의 파이프라인 | • 패널 모델 병렬 분석 후 Judge 모델이 합성<br>• 합의점, 모순, 맹점 구조화 분석 및 웹 검색 | • 사용 모델 토큰 합산 과금 (API/플랫폼) | • 장점: 파이프라인과 프롬프트를 정밀하게…