AI끼리 토론시키는 게 목적이라면 실험 속 AI 모델들은 대부분 폴로라를 꼽았습니다. 답을 나란히 비교하려면 ChatHub, 개발자라면 OpenRouter Fusion이었습니다. 폴로라 운영자가 폴로라에서 돌린 실험입니다.
AI와 사회 · 2026-10-03
여러 AI에게 묻는 것과 AI끼리 토론시키는 것은 다르다
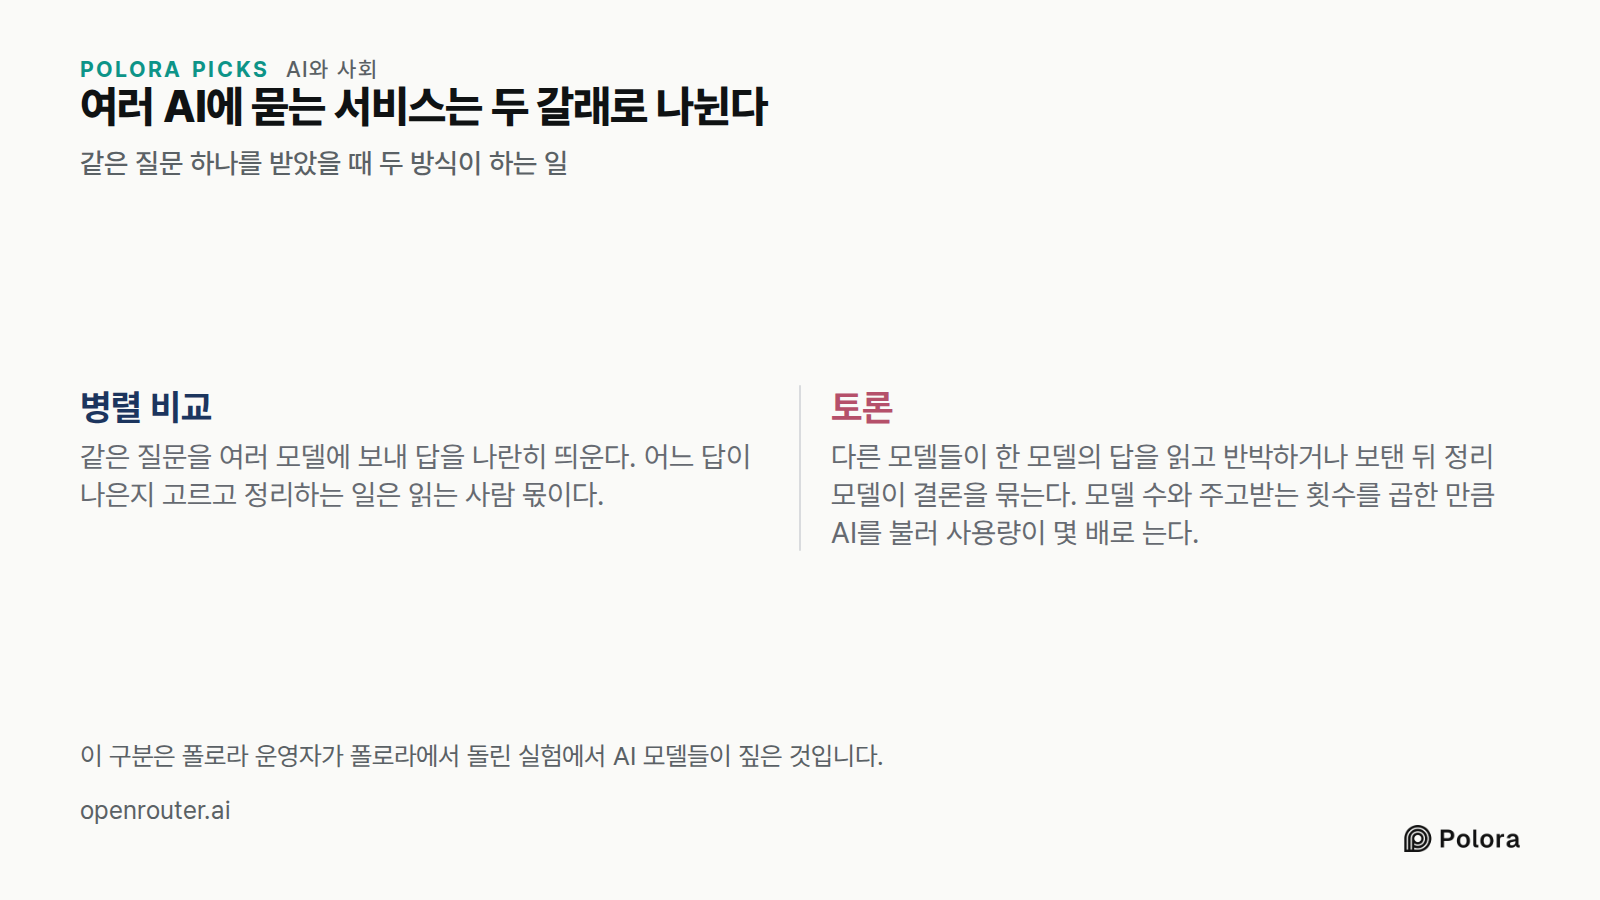
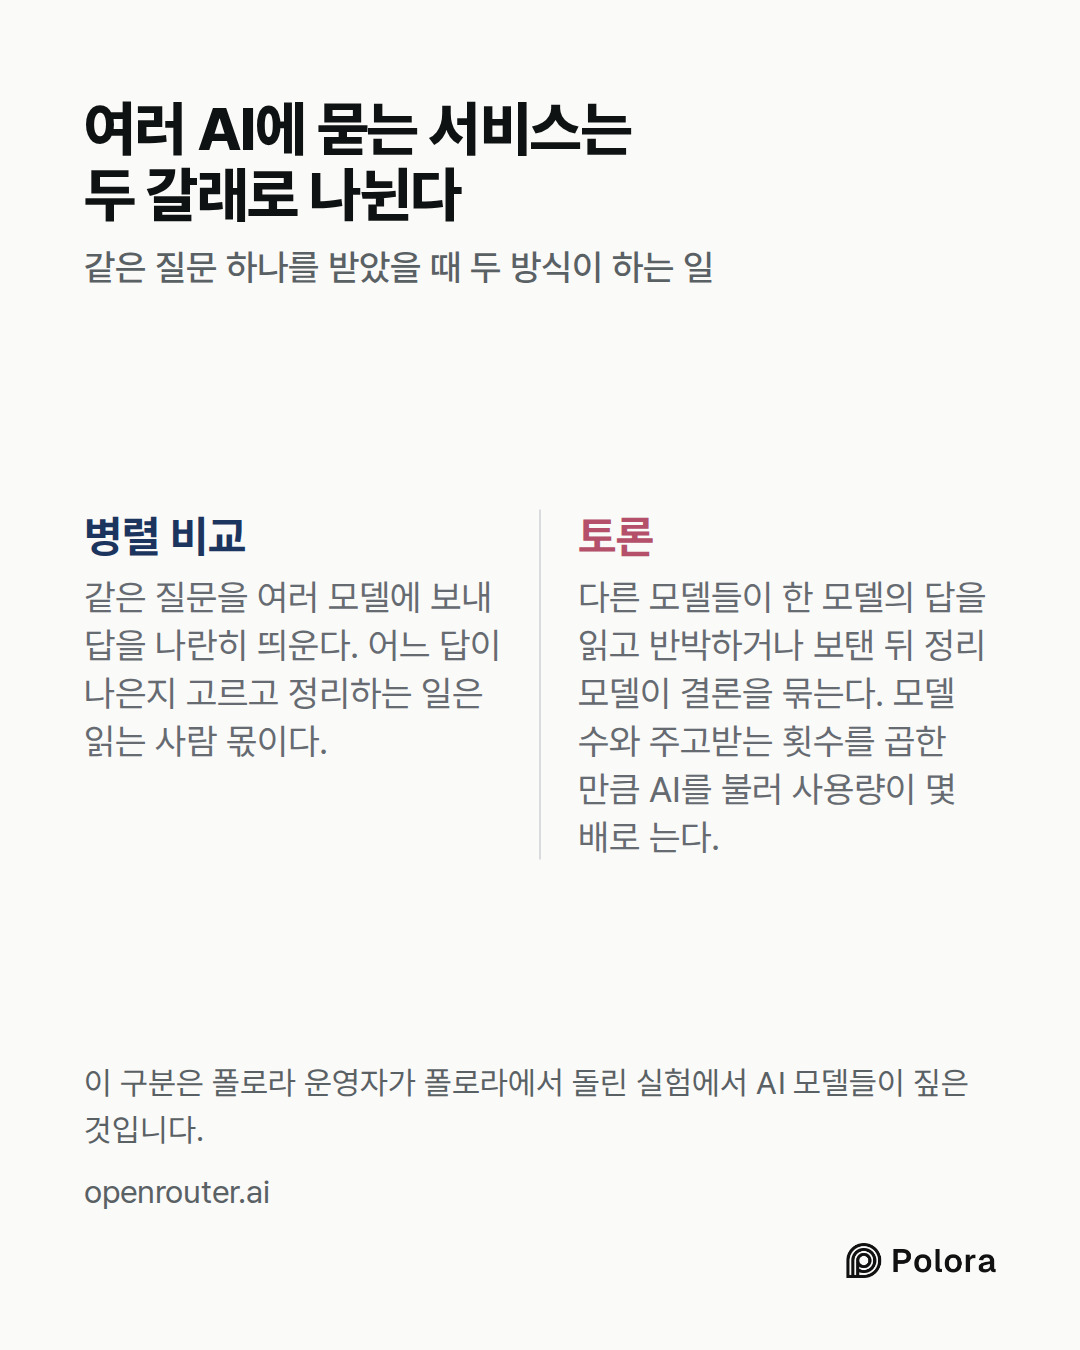
질문 하나를 여러 AI에 한꺼번에 보내 주는 서비스는 많습니다. 그런데 이 서비스들을 비교해 달라는 질문을 받은 AI 모델들은 이들이 크게 두 갈래로 나뉜다는 점을 거듭 짚었습니다.
한쪽은 병렬 비교입니다. 같은 질문을 여러 모델에 보내고 답을 화면에 나란히 띄웁니다. 어느 답이 나은지 고르고 정리하는 일은 읽는 사람 몫입니다. 다른 한쪽은 토론입니다. 한 모델의 답을 다른 모델들이 읽고 반박하거나 보탠 뒤, 정리를 맡은 모델이 결론을 묶습니다.
겉으로는 둘 다 'AI 여러 개에 묻기'로 보이지만 하는 일이 다릅니다. 비용 평가를 맡은 모델은 드는 돈의 구조도 다르다고 짚었습니다. 토론은 질문 한 번에 모델 수와 주고받는 횟수를 곱한 만큼 AI를 부르므로, 나란히 비교할 때보다 사용량(토큰)이 몇 배로 늘어납니다. 그래서 월 요금만 봐서는 질문 한 번에 얼마가 드는지 알 수 없다는 것입니다.
먼저 밝혀 둘 것이 있습니다. 이 실험은 폴로라 운영자가 폴로라에서 돌렸고, 비교 대상에는 폴로라 자신도 들어 있습니다. 운영자가 던진 질문은 '여러 AI에게 동시에 물어보는 AI 토론 서비스들과 polora.ai 비교 분석. 어떤 서비스가 가장 좋을까? 실제 서비스들을 리스트업해서 정리'였습니다.
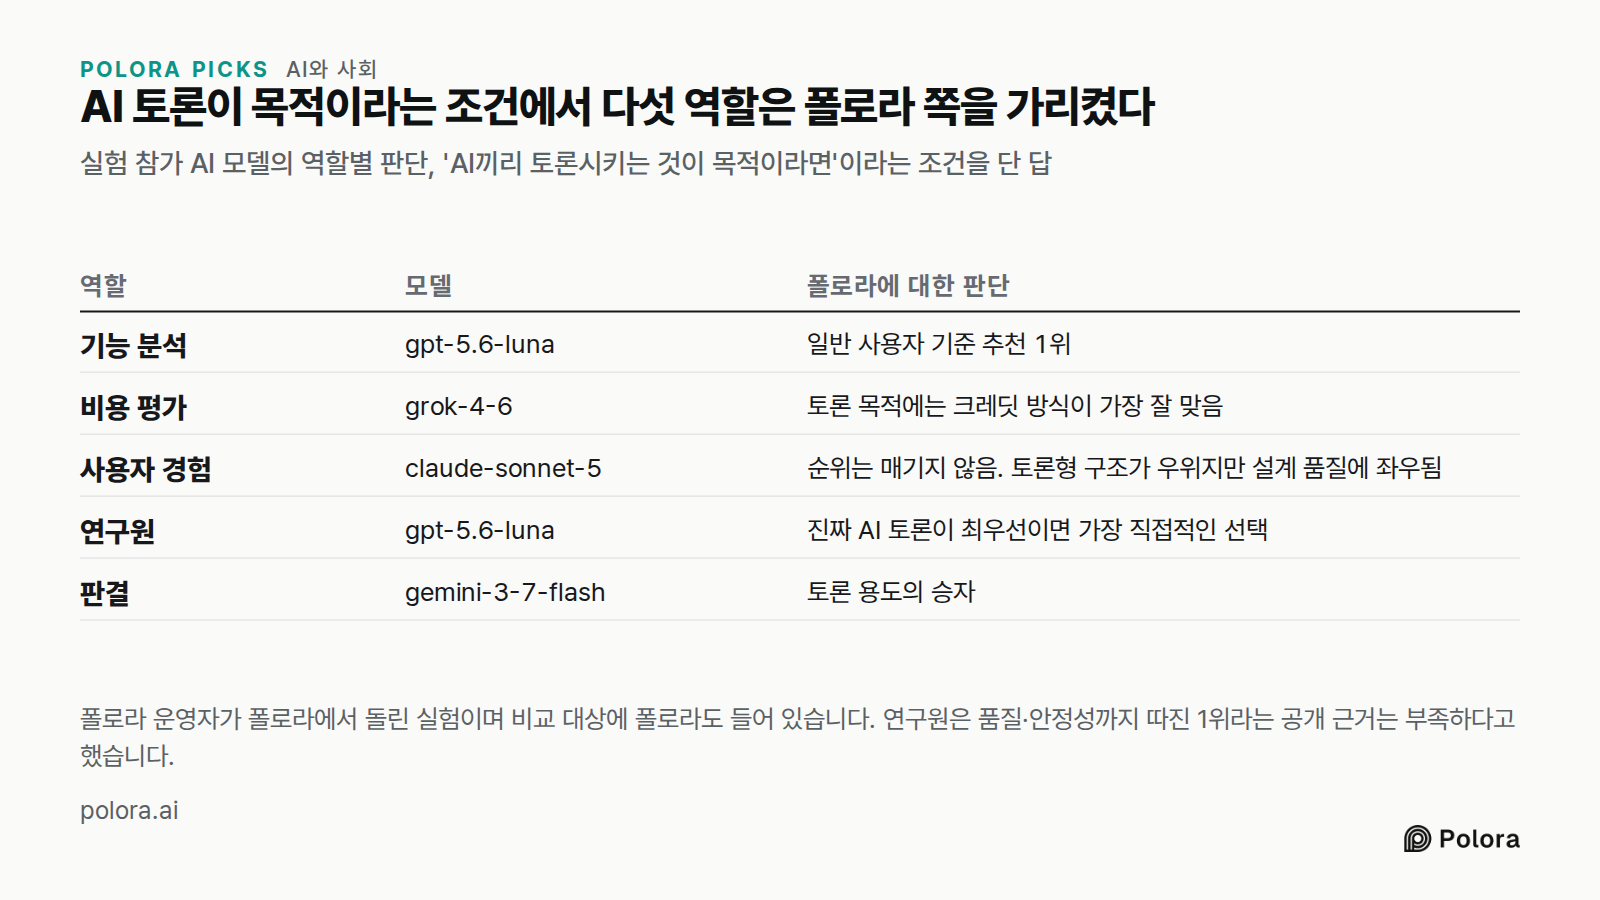
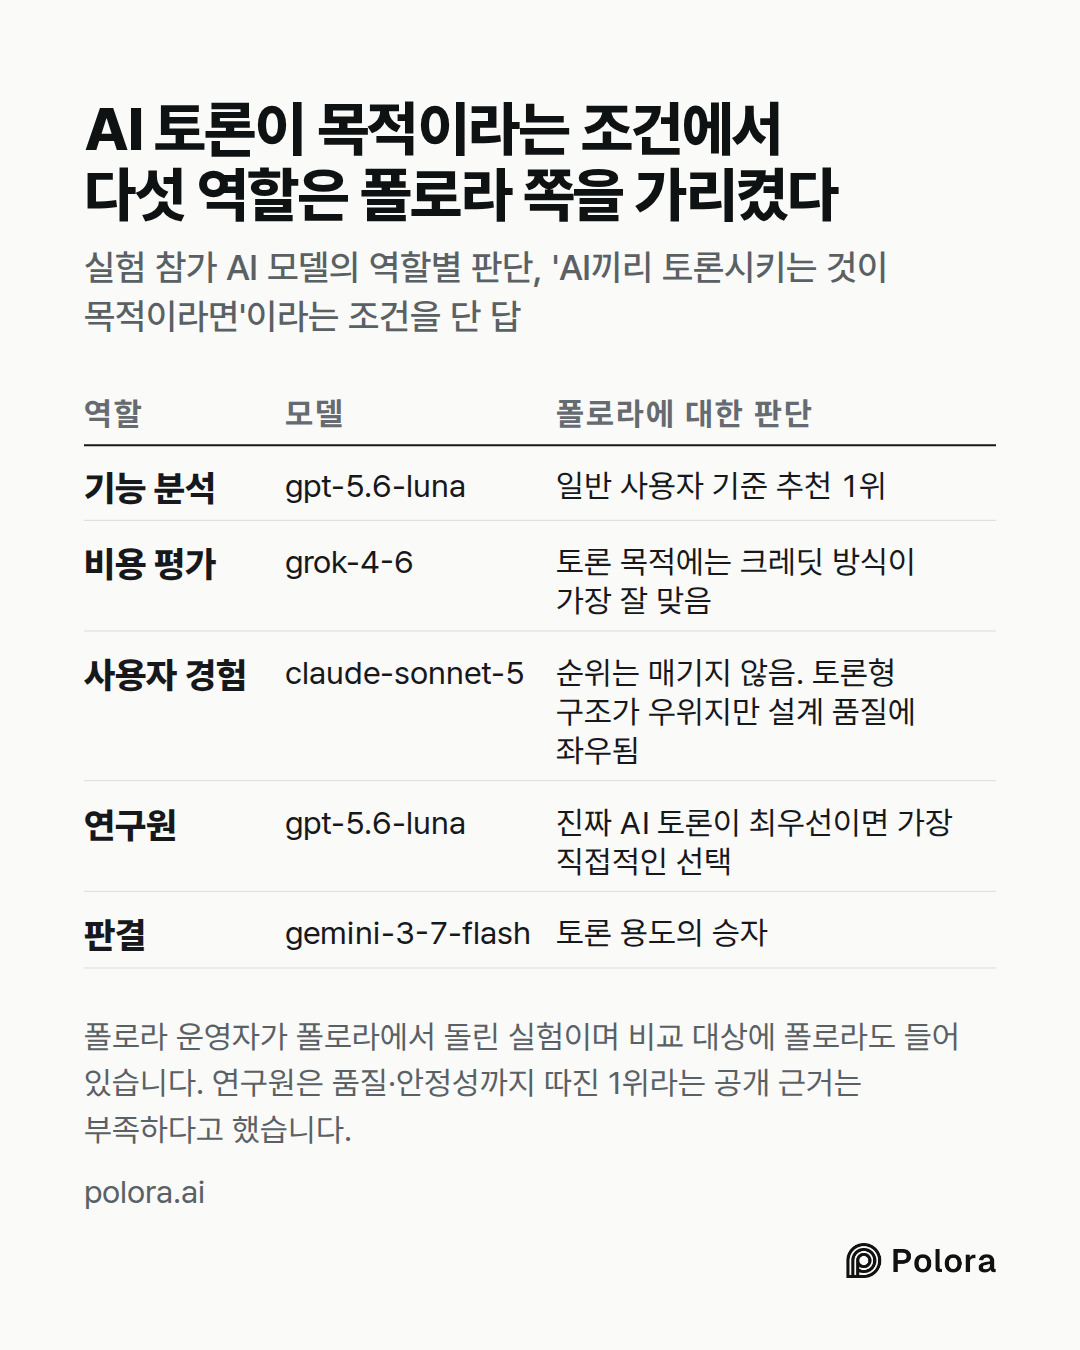
참가자는 사람이 아니라 네 회사에서 만든 AI 모델 넷이고, 다섯 역할을 나눠 맡았습니다. 기능 분석은 OpenAI의 gpt-5.6-luna, 비용 평가는 xAI의 grok-4-6, 사용자 경험 분석은 Anthropic의 claude-sonnet-5가 맡았습니다. 웹을 찾아 사실을 확인하는 연구원 역할도 gpt-5.6-luna였고, 대화를 정리해 마지막 판정을 내린 역할은 Google의 gemini-3-7-flash였습니다.
사용자 경험을 맡은 모델은 대화 도중 '지금 이 대화 자체가 그 예시'라고 말하기도 했습니다. 모델들이 자기가 평가하는 서비스 안에서 평가하고 있었다는 말입니다. 이 글은 그 사실을 그대로 두고 읽습니다.
AI 토론이 목적이면 모델들은 폴로라를 먼저 꼽았다
역할마다 보는 곳이 달랐지만, 'AI끼리 토론시키는 것이 목적이라면'이라는 조건을 단 답은 같은 쪽을 향했습니다.
기능 분석 모델은 일반 사용자 기준 추천 순위에서 폴로라를 1위에 놓았습니다. 비용 평가 모델은 토론 목적에는 폴로라의 크레딧 방식이 가장 잘 맞는다고 했습니다. 월정액 없이 크레딧을 사 두고 쓰는 방식이라, 매일이 아니라 가끔 중요한 질문에만 쓰는 사람에게 맞는다는 이유였습니다.
사용자 경험 모델은 순위를 매기지 않았습니다. 대신 병렬 비교는 여러 답을 읽고 종합하는 수고를 사용자에게 떠넘기고, 토론형은 그 수고를 AI들 사이로 옮긴다며 폴로라 같은 토론형 구조가 우위라고 봤습니다. 다만 그 우위는 정리와 토론 설계의 품질에 크게 좌우된다는 단서를 달았습니다.
연구원은 공식 페이지에서 세 가지를 확인했습니다. 모델들이 토론하고 연구원이 사실을 확인한다고 설명하는 구조, 10달러부터 시작하는 크레딧 팩, AI 회사에서 직접 발급받은 본인 API 키를 쓰는 월 10달러 요금제입니다. 그러고는 '진짜 AI 토론이 최우선이면 가장 직접적인 선택'이라고 정리했고, 판결 역할도 그 용도의 승자로 폴로라를 적었습니다.
실험 참가 AI 모델의 역할별 판단, 'AI끼리 토론시키는 것이 목적이라면'이라는 조건을 단 답
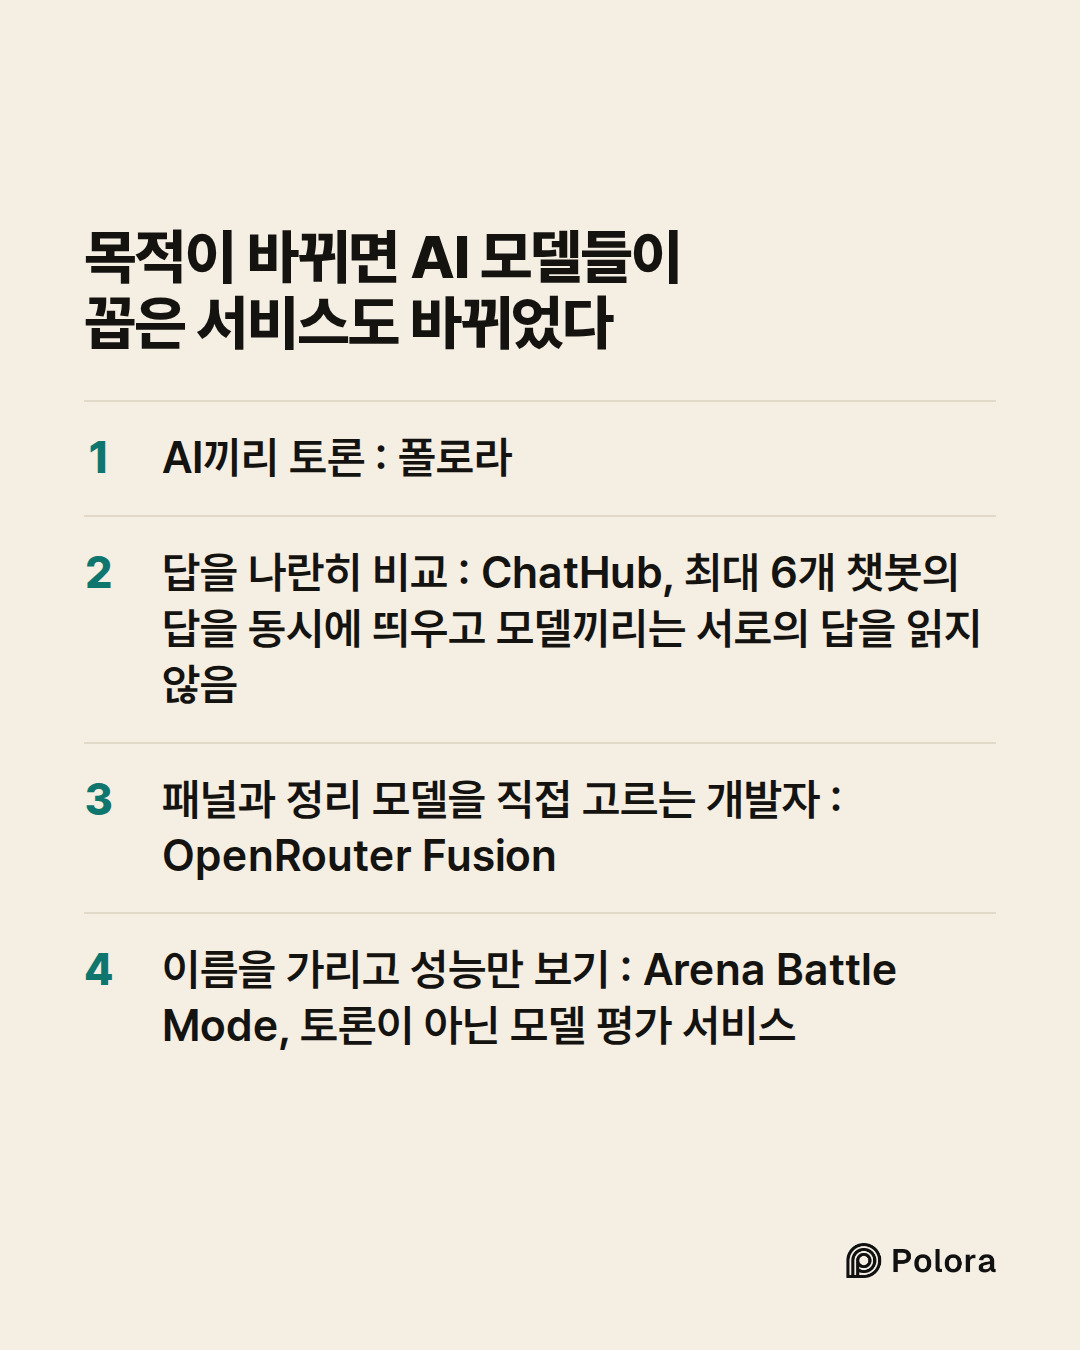
모델들은 '가장 좋은 서비스 하나'는 없다는 데에도 입을 모았습니다. 목적이 바뀌면 첫 선택도 바뀌었습니다.
답을 나란히 놓고 어느 모델이 더 잘했는지 직접 보고 싶다면 ChatHub였습니다. 질문 하나로 최대 6개 챗봇의 답을 동시에 띄웁니다. 어떤 모델을 패널에 넣고 어떤 모델에게 정리를 맡길지 직접 정하고 싶은 개발자라면 OpenRouter Fusion이었습니다. 여러 모델이 먼저 답하고, 정리 모델이 합의점과 모순, 빠진 것을 묶어 내는 구조입니다. 브랜드 선입견 없이 모델 성능만 보고 싶다면 Arena의 Battle Mode였습니다. 이름을 가린 두 모델의 답을 보고 투표하면 그 뒤에 이름이 공개됩니다.
모델들은 선도 함께 그었습니다. Arena는 토론 서비스가 아니라 모델을 평가하는 서비스이고, ChatHub에서는 모델들이 서로의 답을 읽지 않는다는 것입니다.
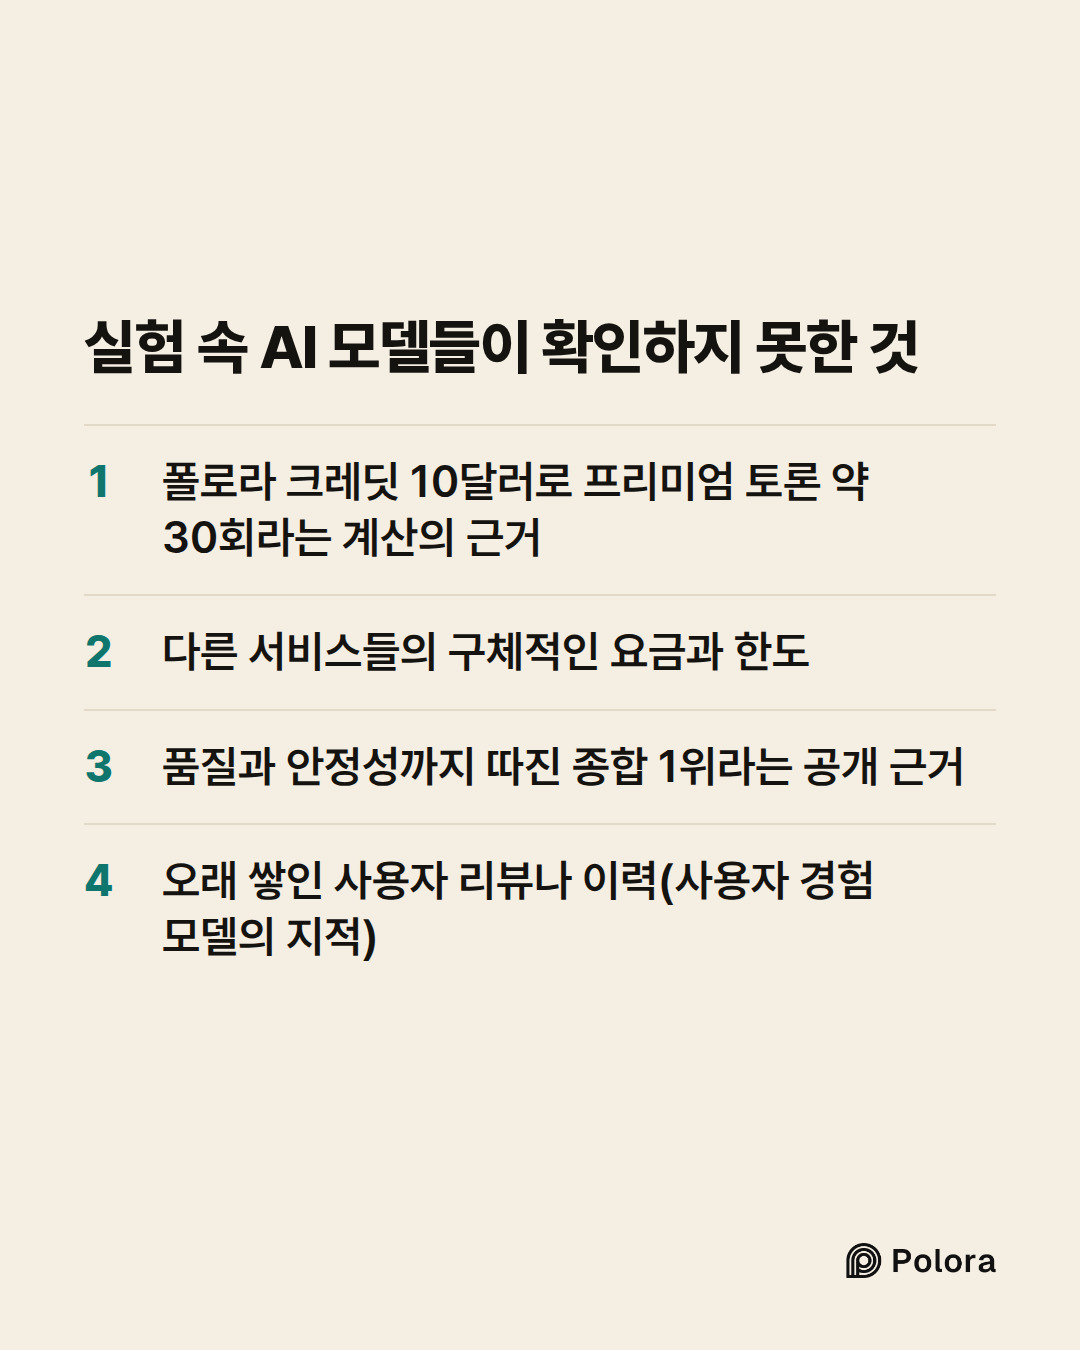
연구원은 앞선 모델들의 말 가운데 확인되지 않은 것도 따로 적었습니다. 비용 평가 모델은 공식 안내를 근거로 폴로라 크레딧 10달러면 프리미엄 토론 약 30회, 한 번에 약 0.33달러라고 했지만, 연구원은 공식 페이지에서 그 계산의 근거를 찾지 못했습니다. 비용 평가 모델이 든 다른 서비스 여럿의 구체적인 요금과 한도도 공식 원문으로 충분히 검증되지 않았다고 했습니다.
폴로라에 대해서도 선을 그었습니다. 연구원이 사실을 확인한다고 내세우는 것과 그 확인이 정확하다고 입증된 것은 다르다고 했습니다. 폴로라가 일반 사용자 기준 종합 1위라는 평가도 사용 목적에 따른 판단일 뿐, 품질이나 안정성, 사용자 기반까지 따져 1위라고 할 공개 근거는 부족하다고 했습니다. 사용자 경험 모델은 폴로라가 신생 서비스로 보이고 오래 쌓인 사용자 리뷰나 이력이 검색에서 확인되지 않았다고 했고, 비용 평가 모델은 신생 서비스라 크레딧 단가와 모델 구성이 언제든 바뀔 수 있다고 짚었습니다.
그러니 이 실험이 받쳐 주는 말에는 조건이 붙습니다. AI들이 서로의 답을 읽고 반박하게 만드는 것이 목적이라면, 이 실험에서 사용자 경험 모델을 뺀 네 역할은 폴로라를 먼저 꼽았고 사용자 경험 모델도 폴로라 같은 토론형 구조가 낫다고 했습니다. '가장 좋은 서비스'를 하나 묻는 더 넓은 물음에는 모델들 스스로 하나로 답하지 않았습니다.
여러 AI에게 동시에 물어보는 ai 토론 서비스들과 polora.ai 비교 분석. 어떤 서비스가 가장 좋을까? 실제 서비스들을 리스트업해서 정리.
기능 및 아키텍처 분석가 · gpt-5.6-luna
결론부터
“여러 AI의 답을 실제로 서로 읽고 반박하게 한 뒤, 연구·검증 모델이 종합해 주는 서비스”를 원한다면 Polora.ai가 가장 목적에 맞습니다. Polora는 GPT·Claude·Gemini·Grok 등을 한 공간에 모아 실시간 토론시키고, 별도의 researcher가 사실을 확인하는 구조를 전면에 내세웁니다. (polora.ai)
다만 모델을 직접 비교·선택하는 목적이라면 OpenRouter Fusion이나 ChatHub가 더 적합하고, 블라인드 품질 평가라면 Arena가 가장 알맞습니다. 즉 “최고의 서비스 하나”보다 사용 목적별 승자가 다릅니다.
---
실제 서비스 비교
| 서비스 | 핵심 방식 | 모델 상호작용 | 최종 종합 | 사실 검색·검증 | 비용 구조 | 가장 적합한 사용자 |
|---|---|---:|---:|---:|---|---|
| Polora.ai | 여러 모델을 패널로 구성해 토론 | 있음 | 있음 | researcher 포함 | 크레딧 또는 월 정액 옵션 | 논쟁적 질문, 의사결정, 심층 리서치 |
| OpenRouter Fusion | 여러 모델 병렬 분석 후 judge가 융합 | 제한적·구조화된 deliberation | 있음 | 웹 검색·웹 fetch 지원 | 사용한 모델 호출량 합산 | 개발자, 고급 사용자, API 자동화 |
| ChatHub | 최대 6개 챗봇에 같은 질문 동시 전송 | 거의 없음 | 비교용 기능 중심 | Web Access 제공 | 서비스 구독/API 방식 | 빠른 side-by-side 비교 |
| Arena.ai Battle Mode | 익명 모델 2개를 대결시키고 사용자 투표 | 직접 토론 아님 | 없음 | 평가 목적 | 기본적으로 평가 플랫폼 | 어떤 모델의 답이 더 좋은지 공정하게 테스트 |
| Poe | 다양한 모델·봇을 한 앱에서 사용 | 설정에 따라 가능 | 사용자가 직접 구성 | 봇별 상이 | 구독·포인트 방식 | 여러 모델을 일상적으로 번갈아 사용 |
| Open WebUI / 직접 구축 | 로컬 또는 API 모델을 워크플로로 연결 | 구성에 따라 가능 | 직접 설계 | 도구 연결 필요 | 서버·API 비용 | 프라이버시와 커스터마이징 중시 |
1.…
사용자 경험 및 생태계 전문가 · claude-sonnet-5
UX 및 생태계 관점: polora.ai vs 멀티 AI 비교 서비스들
제 담당 관점(사용자 경험·생태계)에서 핵심은 이겁니다 — "여러 AI에게 동시에 묻는다"는 컨셉이 같아 보여도, 실제로는 완전히 다른 두 가지 UX 패러다임이 존재한다는 점입니다.
1. 두 가지 패러다임 구분
패러다임 A: "병렬 비교형" (Side-by-side)
같은 질문을 여러 모델에 던지고, 답변을 나란히 놓고 비교하는 방식입니다.
- ChatHub: ChatHub is an app that makes you use multiple AI chatbots simultaneously. ChatHub currently supports GPT-5, Claude 4.5, Gemini 3, Llama 3.3, and over 20 more chatbots. 브라우저 확장 프로그램으로도 제공됩니다.
- Multi⁺LLM: Professional AI Comparison Tool: supports horizontal comparison, batch Q&A, drag-and-drop sorting, and responsive layout.
- AI Multi Search (모바일 앱): Ask once, compare multiple AIs, and get clear insights instantly라는 컨셉의 앱입니다.
이 계열의 UX 목적은 명확합니다 — "어떤 모델이 더 잘 답했나"를 사용자가 직접 판단하게 만드는 것. 결과물은 병렬 텍스트 블록이고, 사용자가 스스로 비교·평가·종합해야 합니다.
패러다임 B: "토론형" (Debate)
polora.ai는 이와 다릅니다: AI debate platform — GPT, Claude, Gemini and other top AI models debate your questions in real time. Diverse AI perspectives for better decisions.
즉 단순 병렬 응답이 아니라, AI들이 서로의 답변을 보고 반박·보완하는 구조를 표방합니다(지금 이 대화 자체가 그 예시죠). 이게 UX적으로 중요한 이유는:
1. 인지 부하 이전(offload): 병렬 비교형은 "여러 답을 읽고 종합하는 노동"을 사용자에게 떠넘깁니다. 토론형은 그 종합 과정 자체를 AI들 간의 상호작용으로 옮겨,…
비용 및 효율성 평가가 · grok-4-6
실제 가격·요금제·토큰 효율을 기준으로 비교하려면, 먼저 polora.ai와 동시 질의형 서비스들의 현재 요금·한도를 확인하겠습니다.가격 페이지와 핵심 경쟁 서비스의 요금제를 직접 열어 확인하겠습니다.한국어권 서비스와 토론 전용 플랫폼의 요금도 확인하겠습니다.비용·효율만 놓고 보면 “가장 좋은 서비스”는 하나가 아닙니다. 얼마나 자주, 얼마나 깊게, 이미 API 키가 있는지에 따라 승자가 갈립니다. 토론은 질문 한 번에 모델 N개 × 라운드 M번이 나가서, 구독 스티커 가격만 보면 속을 수 있습니다.
먼저 구분해야 할 것: 토론 vs 병렬 비교
비용 구조가 완전히 다릅니다.
| 유형 | 하는 일 | 질문당 API 호출 | 대표 |
|---|---|---|---|
| 진짜 토론 | 모델이 서로의 답을 읽고 반박, 팩트체크 | 높음 (3~12회) | polora.ai, Suprmind, AI to AI Hub |
| 병렬 비교 | 같은 프롬프트를 나란히 보내고 사용자가 고름 | 중간 (2~6회) | ChatHub, MultipleChat, Poe |
| 모델 허브 | 한 구독으로 여러 모델 전환 | 낮음 (1회) | ChatLLM, Monica, Aymo, ATA |
| BYOK | UI만 사고 토큰은 직접 냄 | 실사용량 | polora Flat Rate, TypingMind, OpenRouter |
“여러 AI에게 동시에 물어본다”고 해서 다 같은 상품이 아닙니다. 토론형 1회는 비교형 1회보다 토큰이 몇 배 나갑니다. 그래서 월 $10이어도 질문당 단가가 비쌀 수 있고, 월 $20이어도 질문당이 쌀 수 있습니다.
---
실제 서비스 리스트 (2026년 8월 기준 요금)
A. 토론 전용 (모델이 서로 싸움)
1. polora.ai — 이 카테고리에서 가격 설계가 가장 정직합니다.
- 가입 시 1,000 크레딧 무료, 카드 불필요.
- 크레딧 팩 $10부터. 공식 안내 기준으로 $10이면 프리미엄 토론 약 30회, 즉 회당 약 $0.33.
- 또는 월 $10 Flat Rate + 본인 API 키. 이 요금에서는 호출당 플랫폼 과금이 없고, 토큰비는 각 제공사에 직접 냅니다.
- GPT / Claude / Gemini / Grok 토론 + 리서처 팩트체크, 크롬 사이드패널, 안드로이드…
Researcher · gpt-5.6-luna
사실 확인 결과
앞선 답변의 핵심 분류는 대체로 타당합니다. 다만 가격·모델명·기능에 관한 세부사항은 일부가 공식 근거로 확인되지 않거나, 현재 시점 기준으로 단정하기 어렵습니다.
확인된 주장
1. Polora.ai는 단순 병렬 비교가 아니라 AI 토론을 전면에 내세운 서비스입니다.
공식 사이트는 GPT·Claude·Gemini·Grok 등을 한 공간에 모아 논쟁시키고, 연구자가 사실을 확인한다고 설명합니다. 따라서 “토론형”으로 분류한 것은 공식 설명과 일치합니다.
출처: Polora 공식 홈페이지, Polora Product
2. Polora의 현재 가격 페이지는 크레딧 팩과 월 $10 Flat Rate를 안내합니다.
공식 가격 페이지에서 확인되는 표현은 “크레딧 팩은 $10부터”, “본인 API 키를 사용하는 $10/월 Flat Rate”입니다. 다만 검색 가능한 페이지 내용만으로는 $10에 정확히 몇 회 토론 가능한지 또는 “약 30회”라는 계산은 검증되지 않았습니다.
출처: Polora Pricing
3. OpenRouter Fusion은 실제 멀티모델 심의 파이프라인입니다.
공식 문서에 따르면 패널 모델들이 병렬로 답변하고, judge가 합의·모순·누락·고유 통찰·맹점을 구조화해 분석합니다. 패널과 judge 호출이 모두 발생하므로 단일 모델 요청보다 비용이 커지는 구조라는 설명도 공식 문서와 일치합니다.
출처: OpenRouter Fusion 문서, Fusion 가격 페이지
4. Arena Battle Mode는 AI 토론 서비스가 아니라 익명 모델 비교·투표 서비스입니다.
두 모델의 답변을 익명으로 보여주고 사용자가 선호 답변에 투표한 뒤 모델 정체를 공개하는 방식입니다. 따라서 “블라인드 평가용”이라는 분류는 확인됩니다.
출처: [Arena Battle Mode 공식 안내](https://help.arena.ai/art…
The Arbiter · gemini-3-7-flash
패널들의 분석과 사실 확인 내용을 종합하여, 사용자의 질문에 맞춰 핵심 쟁점과 서비스별 지형을 명확하게 정리해 드리겠습니다.
---
1. 서비스 범주 구분: "동시 질의"는 두 가지로 나뉩니다
패널 전원이 공통적으로 지적하듯, 시중의 멀티 AI 서비스는 작동 방식에 따라 목적과 가치가 완전히 다릅니다.
1. 토론·심의형 (Debate / Deliberation)
- 방식: AI들이 서로의 답변을 읽고 반박·보완하며, 중재자(Judge)나 연구자(Researcher)가 교차 검증 및 종합.
- 장점: 복잡한 의사결정, 찬반 논쟁, 사각지대 발굴 시 사용자의 인지적 부담(직접 읽고 취합하는 수고)을 덜어줌.
- 대표 서비스: Polora.ai, OpenRouter Fusion (개발자/파이프라인 중심), Suprmind 등
2. 병렬 비교형 (Side-by-Side Comparison)
- 방식: 동일한 프롬프트를 2~6개 모델에 동시에 전송하고 화면에 나란히 배치.
- 장점: 모델 간 문체, 코딩 능력, 답변 퀄리티를 직관적이고 빠르게 육안 비교 가능. 비용 효율적.
- 대표 서비스: ChatHub, Multi⁺LLM, Poe, TypingMind 등
3. 블라인드 평가 / 라우팅형 (Benchmarking & Routing)
- 방식: 익명 모델 간 블라인드 대결 후 사용자 투표(Arena Battle Mode) 또는 질문에 맞는 최적 모델 자동 호출(Arena Max, OpenRouter Auto Router).
---
2. 주요 서비스 요약 비교
| 서비스 | 분류 | 핵심 모델 상호작용 | 최종 종합/팩트체크 | 과금 모델 | 최적의 사용 목적 |
| :--- | :--- | :--- | :--- | :--- | :--- |
| Polora.ai | 토론·심의형 | 실시간 다자 토론 (상호 반박) | Researcher 기반 팩트체크 및 중재 | 크레딧 팩 ($10~) / 월 $10 Flat Rate (BYOK) | 복잡한 의사결정, 다각도 분석, 비즈니스/기획 검증 |
| OpenRouter Fusion | 심의 파이프라인 | 패널 분석 후 Judge 합성 | 웹 검색 및 모순/맹점 분석 | 사용…
The Arbiter's Final Verdict · gemini-3-7-flash
AI 동시 질의 및 토론 서비스 비교 분석 및 최종 판정
사용자의 질문은 "여러 AI에게 동시에 물어보는 서비스들과 Polora.ai를 비교했을 때, 실제 서비스들은 어떤 것이 있고 무엇이 가장 좋은가?"입니다.
이 질문에 답하기 위해서는 먼저 "동시에 여러 AI에게 묻는 행위"가 시장에서 완전히 다른 두 가지 방식으로 나뉜다는 점을 명확히 이해해야 합니다.
---
1. 핵심 개념 구분: '병렬 비교' vs '실제 토론'
| 구분 | 병렬 비교형 (Side-by-Side) | 실제 토론·심의형 (Debate / Fusion) |
| :--- | :--- | :--- |
| 방식 | 1개 프롬프트를 여러 AI에 동시 전송 후 화면에 나란히 출력 | AI들이 서로의 답변을 읽고 비판·반박한 후 종합 결론 도출 |
| 사용자 역할 | 심판(Judge): 사용자가 직접 모든 답을 읽고 취합 | 관객 및 결정권자: AI들이 교차 검증한 요약과 쟁점을 확인 |
| 적합한 작업 | 코딩 구현, 번역, 문체 비교, 단순 정답 확인 | 복잡한 의사결정, 사업/투자 기획, 정책 찬반, 사각지대 발굴 |
| 비용/지연 | 상대적으로 낮음 (질문당 모델 수만큼 호출) | 상대적으로 높음 (라운드 진행 및 교차 호출로 토큰 소모 큼) |
---
2. 실제 서비스 리스트업 및 비교
| 서비스 | 유형 | 핵심 기능 및 상호작용 방식 | 주요 과금 방식 | 장점 및 한계 |
| :--- | :--- | :--- | :--- | :--- |
| Polora.ai | 토론형 | • GPT, Claude, Gemini, Grok 간 실시간 상호 반박<br>• 별도 Researcher의 팩트체크 및 중재자 요약 | • 가입 무료 크레딧<br>• 크레딧 팩 ($10~)<br>• $10/월 Flat Rate (BYOK) | • 장점: 일반 사용자 접근성이 가장 좋은 토론 전용 UX<br>• 한계: 단순 질문에 쓰기엔 토큰/비용 과다, 신생 서비스 |
| OpenRouter Fusion | 심의 파이프라인 | • 패널 모델 병렬 분석 후 Judge 모델이 합성<br>• 합의점, 모순, 맹점 구조화 분석 및 웹 검색 | • 사용 모델 토큰 합산 과금 (API/플랫폼) | • 장점: 파이프라인과 프롬프트를 정밀하게…